Какие тексты цитируют нейросети и почему ИИ нужны не лонгриды, а точечные абзацы про бренд
Агентство Graphite посчитало, что около половины англоязычных статей, вышедших с 2025 года, написаны в основном нейросетью. Среди статей, на которые ссылаются ChatGPT и Perplexity, ИИ-текстов при этом только 18%. Брендам, которые выпускают ИИ-тексты пачками, стоит проверить, какие их тексты цитируют нейросети и цитируют ли вообще. Но и страницу, на которую ссылается, Perplexity переносит в ответ не целиком. Я разобрал 60 его ответов, и обычно туда попадает всего пара кусков текста, а не материал целиком. Поэтому выигрывает в гонке за ИИ-видимость тот бренд, у которого ключевая информация по запросу считывается в одном-двух абзацах, а не во всей статье.
Половину ИИ-статей Graphite насчитала только в выборке англоязычных страниц
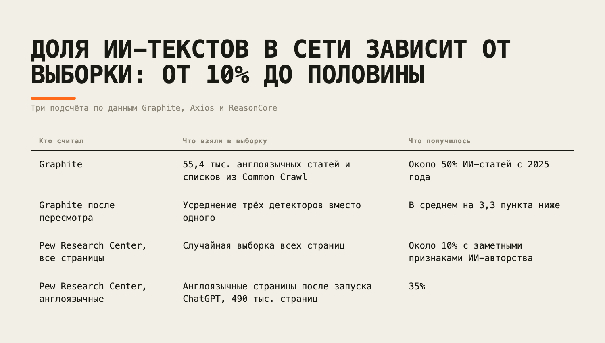
Ребята из Graphite считали не весь интернет, конечно. По данным агентства в пересказе Axios, в выборку вошли 55,4 тыс. англоязычных страниц из открытого архива Common Crawl: только статьи и списки не короче 100 слов, опубликованные с января 2020 по март 2026 года. Доля статей, написанных в основном нейросетью, за первый год после запуска ChatGPT выросла до 35,9%, а с 2025 года держится около 50%, как пишет Sostav.
ИИ-статьёй в Graphite считали текст, в котором детектор (программа, которая распознаёт машинный текст) находил больше 50% ИИ-текста. В первой версии исследования детектор был один. В пересмотре агентство усреднило три, и доля, по его же оценке, вышла в среднем на 3,3 пункта ниже.
Pew Research Center считал иначе, и цифры у него другие. В случайной выборке всех страниц около 10% имеют заметные признаки ИИ-авторства, а 35% получается только среди англоязычных страниц с датой после запуска ChatGPT, на выборке из 490 тыс. страниц (пересказ ReasonCore). Разброс от 10% до половины во многом зависит от того, какие страницы брать в счёт. Русскоязычных текстов в этих выборках нет.
Почему ИИ-статьи реже попадают в ссылки ChatGPT и Perplexity?
Точного ответа нет. ИИ-статей в ссылках ChatGPT и Perplexity 18%, среди опубликованных около половины, и сравнивать эти доли напрямую нельзя: выборки разные. Для цитирований Graphite взяла по 100 ключевых слов на категорию, нейросеть превратила их в вопросы, а ответы ChatGPT собирали вручную в браузере. Статью агентство оценивало целиком, детектор проверял её кусками по 500 слов, поэтому непонятно, какой абзац попал в ответ.
Среди обычных поисковых ссылок Google ИИ-статьи тоже стоят ниже: на первой позиции их 7% при средней доле 14%. Graphite смотрела первые две страницы обычных поисковых ссылок за июнь 2025 года и только англоязычные статьи. Но и говорить, что ИИ-тексты в ответы ИИ не попадают, некорректно. В научной работе с конференции Canadian AI 2026 обзоры Google с ИИ на запросах о здоровье и деньгах цитировали ИИ-документы чаще человеческих, даже с поправкой на место среди обычных поисковых ссылок.
Место среди обычных поисковых ссылок и место в ответе тоже расходятся. Я смотрел 1 095 вопросов на русском: обзоры Google с ИИ появлялись почти всегда, в 93% случаев, и примерно половина их источников была не с первой страницы обычных поисковых ссылок.
Ссылку Perplexity ставит на всю страницу, а в ответ берёт лишь её кусочек
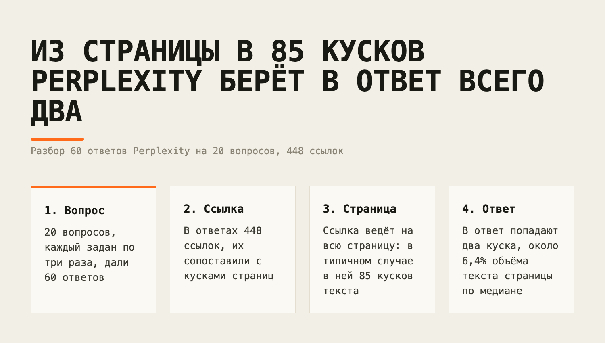
Со страницы, на которую сослался Perplexity, в ответ в типичном случае (по медиане) попадают два кусочка текста из 85 (кусок — фрагмент, на которые делится страница). Это около 6,4% объёма её текста: доля считается по объёму, а не по числу кусков. Я задал Perplexity 20 вопросов по три раза, получил 60 ответов и сопоставил 448 ссылок в них с кусками страниц, на которые они ведут. Я думал, доля будет заметно больше.
Google пишет, что для ИИ-ответов поиск находит подходящие страницы в индексе, затем системы просматривают на них конкретную информацию и собирают ответ со ссылками. Поиск Яндекса ещё до генеративных ответов показывал быстрые ответы: фрагменты текста с сайта, которые с высокой вероятностью отвечали на вопрос. Кусок страницы вместо страницы целиком поиск брал и раньше.
Замер небольшой: одна нейросеть и 20 вопросов. Для ChatGPT, GigaChat и Алисы AI такого замера у меня нет, и переносить на них эти цифры нельзя.
Абзацы, которые Perplexity берёт в ответ, длиннее остальных
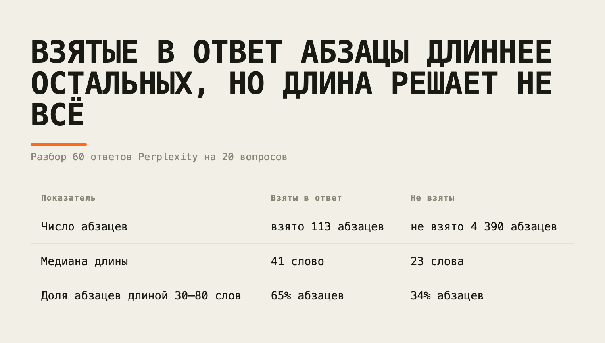
В тех же 60 ответах Perplexity взял 113 абзацев и не взял 4 390, то есть примерно каждый сороковой абзац. Медиана длины взятого абзаца — 41 слово, невзятого — 23. Длина 30–80 слов у 65% взятых абзацев и только у 34% невзятых.
Но 34% от 4 390 — это около полутора тысяч абзацев подходящей длины, которые нейросеть пропустила. Одной длиной выбор не объяснить. Google в руководстве по ИИ-поиску тоже пишет, что идеальной длины нет, и советует строить страницы из абзацев и разделов с заголовками.
Контент-бюджет бренда стоит тратить на продуманные тексты, из которых ИИ будет забирать точечно абзацы
Гонка за объёмом ИИ-текстов — пустая трата бюджета. Нейросети цитируют абзац, а не статью, поэтому одна страница, где каждый абзац отвечает на вопрос сам, полезнее десяти сгенерированных. Google в том же руководстве пишет, что большое число страниц не работает как долгосрочная стратегия.
Условный пример — страница тарифов интернет-магазина. Абзац начинается так: как мы писали выше, этот тариф подходит не всем. Без остальной страницы он непонятен: какой тариф и кому не подходит? Тот же абзац можно переписать так: тариф Про подходит магазинам с оборотом больше миллиона рублей в месяц и включает три рабочих места. В нём названы предмет, условие и содержание, и нейросеть может взять его в ответ целиком. Так стоит переписать главные страницы бренда: услуги, цены, ответы на вопросы клиентов.
Считать результат стоит по ссылкам на конкретную страницу бренда. Ведь бренд в ответе нейросети могут назвать, а сослаться при этом на чужой обзор или сайт-подборку.