Сезонность в GEO: почему один набор запросов нельзя проверять одинаково весь год
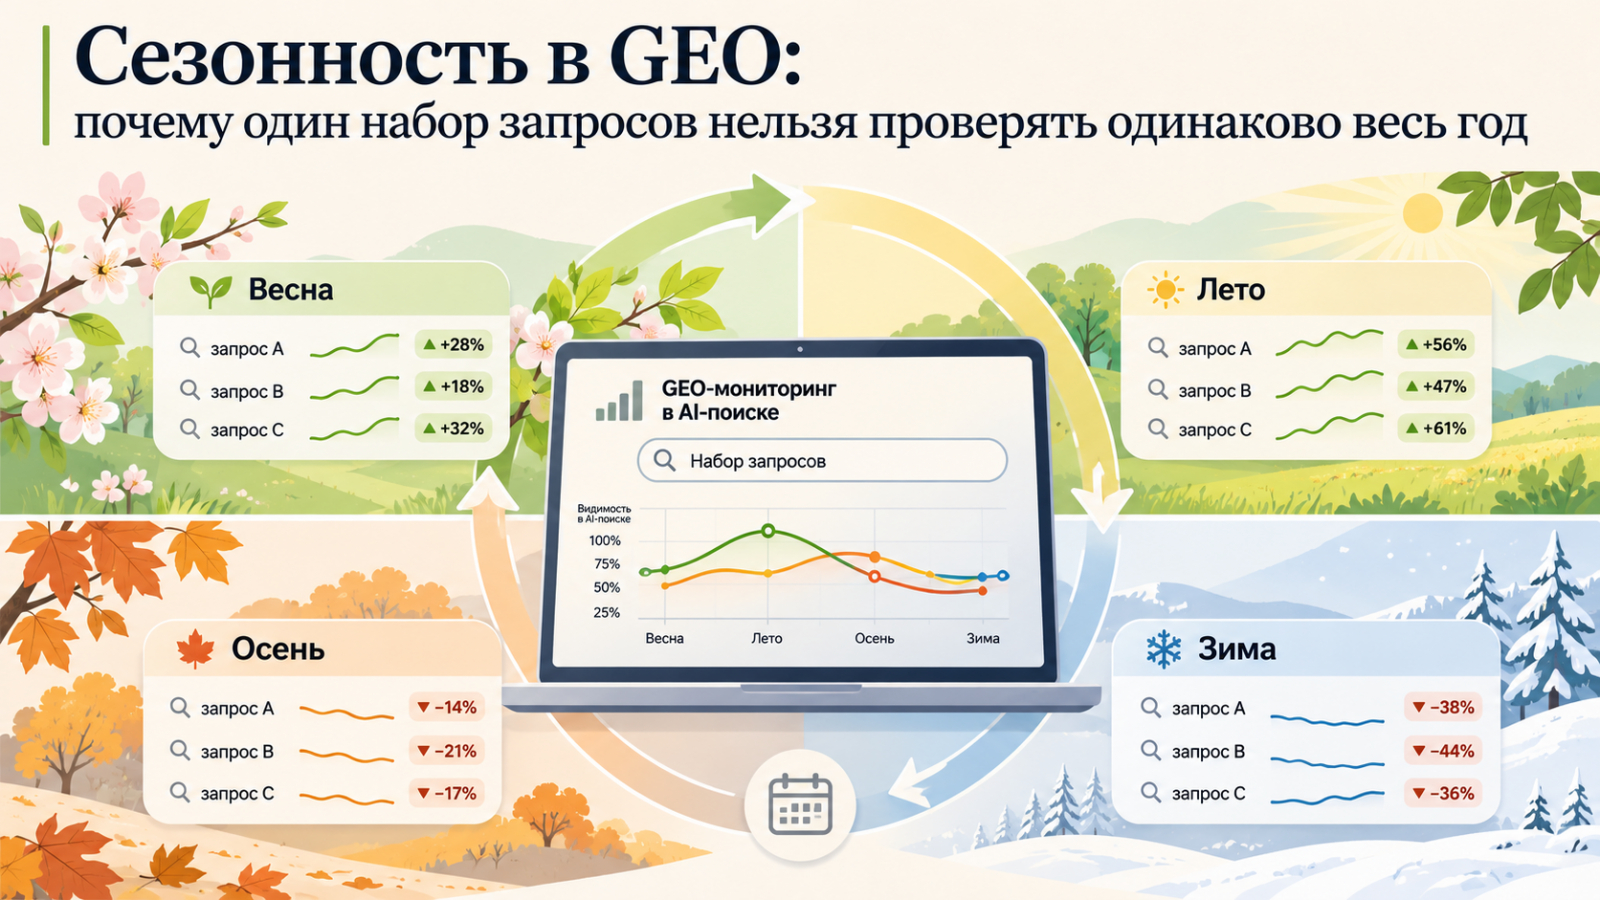
Клиент из ниши, где круглый год продают примерно одно и то же, смотрит в отчёт и говорит: цифры как в октябре, значит, ничего не изменилось, за что платить дальше. Через минуту он открывает чат с нейросетью и спрашивает ровно то, что спросил бы его покупатель в феврале. В ответе три конкурента и ни слова про него.
Средняя видимость выглядит стабильной, пока не разложишь её по месяцам
Мониторинг видимости в нейросетях почти всегда начинается одинаково: собрали двести-триста запросов, зафиксировали набор, дальше смотрим динамику. Логика понятная, без постоянного набора нет сопоставимости: поменяли запросы и уже не знаете, бренд стал заметнее или просто вопросы стали проще. Поэтому набор замораживают на год, иногда на два.
Проблема в том, что покупатель набор не замораживал. В ноябре он спрашивает нейросеть про подарок, в январе про то, как сэкономить после праздников, в мае про монтаж до начала сезона, в августе про сборы к учебному году. Это не другие слова вокруг того же товара, это другие сценарии выбора: меняется срочность, меняется критерий, меняется сам состав того, что модель считает уместным советом. Средняя видимость по замороженному набору в такие месяцы остаётся ровной, потому что она измеряет прошлогодние вопросы.
По моей агентской выборке за последний год это выглядит так: у брендов, где метрика упоминаемости держалась в пределах обычных колебаний, при ручной проверке сезонных формулировок видимость в них оказывалась заметно ниже, чем на основном наборе. Проверка при этом занимала полчаса: мы просто выписывали, что человек спросил бы в этом месяце, и прогоняли вручную.
Что именно меняется в сезон, кроме слов
- Критерий выбора. В низкий сезон спрашивают, что лучше и надёжнее. В высокий добавляется вопрос про сроки: успеют ли привезти, установить, доставить до даты.
- Формат ответа. На сезонных запросах нейросети чаще отдают подборки и списки, а не один вариант, и попасть в такой ответ может бренд, которого нет в ответе на общий запрос категории.
- Состав источников. Под сезон обновляются обзоры и подборки в медиа, и модель начинает цитировать свежие материалы, а не те, по которым бренд вытягивал видимость весь год.
- География. Сезонность разная по регионам: отопительный сезон, начало дачного, завоз школьной формы. Один запрос без гео-привязки это усреднение по стране.
- Состав конкурентов в ответе. В сезон в выдачу входят игроки, которых в межсезонье в ответах нет вообще, и наоборот.
Ядро и сезонные кластеры: как делить набор
- Постоянное ядро, примерно 60-70 процентов набора. Запросы категории, сравнения с конкурентами, вопросы про цену и доверие. Это ядро не трогают весь год: именно по нему считают динамику и показывают клиенту, выросли мы или нет.
- Сезонные кластеры, 20-30 процентов. Отдельные группы запросов, которые включаются за шесть-восемь недель до события и выключаются после него. Считаются и показываются отдельно, в общую среднюю не смешиваются.
- Пробный кластер, около 10 процентов. Гипотезы на сезон: новые формулировки, новые поводы, новые регионы. Что подтвердилось, на следующий год переходит в сезонный кластер или в ядро.
Ключевое правило: сезонный кластер нельзя складывать с ядром в одну метрику. Иначе каждый сезон вы получаете скачок, который нечем объяснить клиенту: видимость выросла, потому что бренд стал заметнее, или потому что в набор добавили двадцать запросов, где он случайно упоминается. Я предпочитаю два графика рядом и одну подпись под ними, что в наборе менялось.
Что это значит для российского рынка
У нас сезонность вопросов усиливается тем, что ассистентов много и ведут они себя по-разному. Один охотнее опирается на свежие публикации, другой на давно проиндексированные обзоры, третий отвечает по-разному в двух своих режимах. Поэтому сезонный кластер, прогнанный только в одной модели, почти ничего не говорит: расхождение между ассистентами на сезонных формулировках у нас стабильно больше, чем на общих запросах категории.
Для клиентских замеров я беру сервисы GEO-мониторинга: например, brandfound прогоняет набор по десяти нейросетям, включая оба режима Алисы, и отдаёт тональность и источники каждого ответа, а запросы можно привязать к региону и держать избранные на почасовой проверке. Рядом смотрим VisioBrand, PixelTools: задача не выбрать лучший, а прогнать любой кандидат по своему чек-листу, где для сезонной работы важны три вещи: группировка запросов в отдельные кластеры, гео-привязка и выгрузка источников.
Вторая российская особенность это сроки. Сезонный кластер имеет смысл включать заранее, потому что между публикацией материала и его появлением в ответах проходит время, и в наших проектах это недели, а не дни. Если кластер включается в тот же месяц, когда начинается спрос, вы успеваете только зафиксировать, что бренда там нет.
Чек-лист сезонного пересбора
- Соберите календарь спроса клиента на год: события, пики, провалы. Источники простые, годовая выручка по месяцам, сезонность в Вордстате, календарь акций.
- Для каждого пика выпишите, что человек спрашивает за два месяца до него, за месяц и в самом пике. Формулировки берите у клиентской поддержки, а не из головы.
- Разметьте набор на ядро, сезонные кластеры и пробный кластер. Зафиксируйте, что ядро весь год не меняется.
- Включайте кластер за шесть-восемь недель до пика и снимайте первый замер до начала работ, чтобы была точка отсчёта.
- Отдельно выгружайте источники по сезонным ответам: это и есть список, куда надо попасть, и он отличается от круглогодичного.
- После сезона сравните кластер с прошлым годом и перенесите подтвердившиеся формулировки в постоянную часть. Остальное выключите, чтобы набор не разрастался.