Вас называют, но не цитируют: упоминания и ссылки в ответах ИИ это две разные метрики
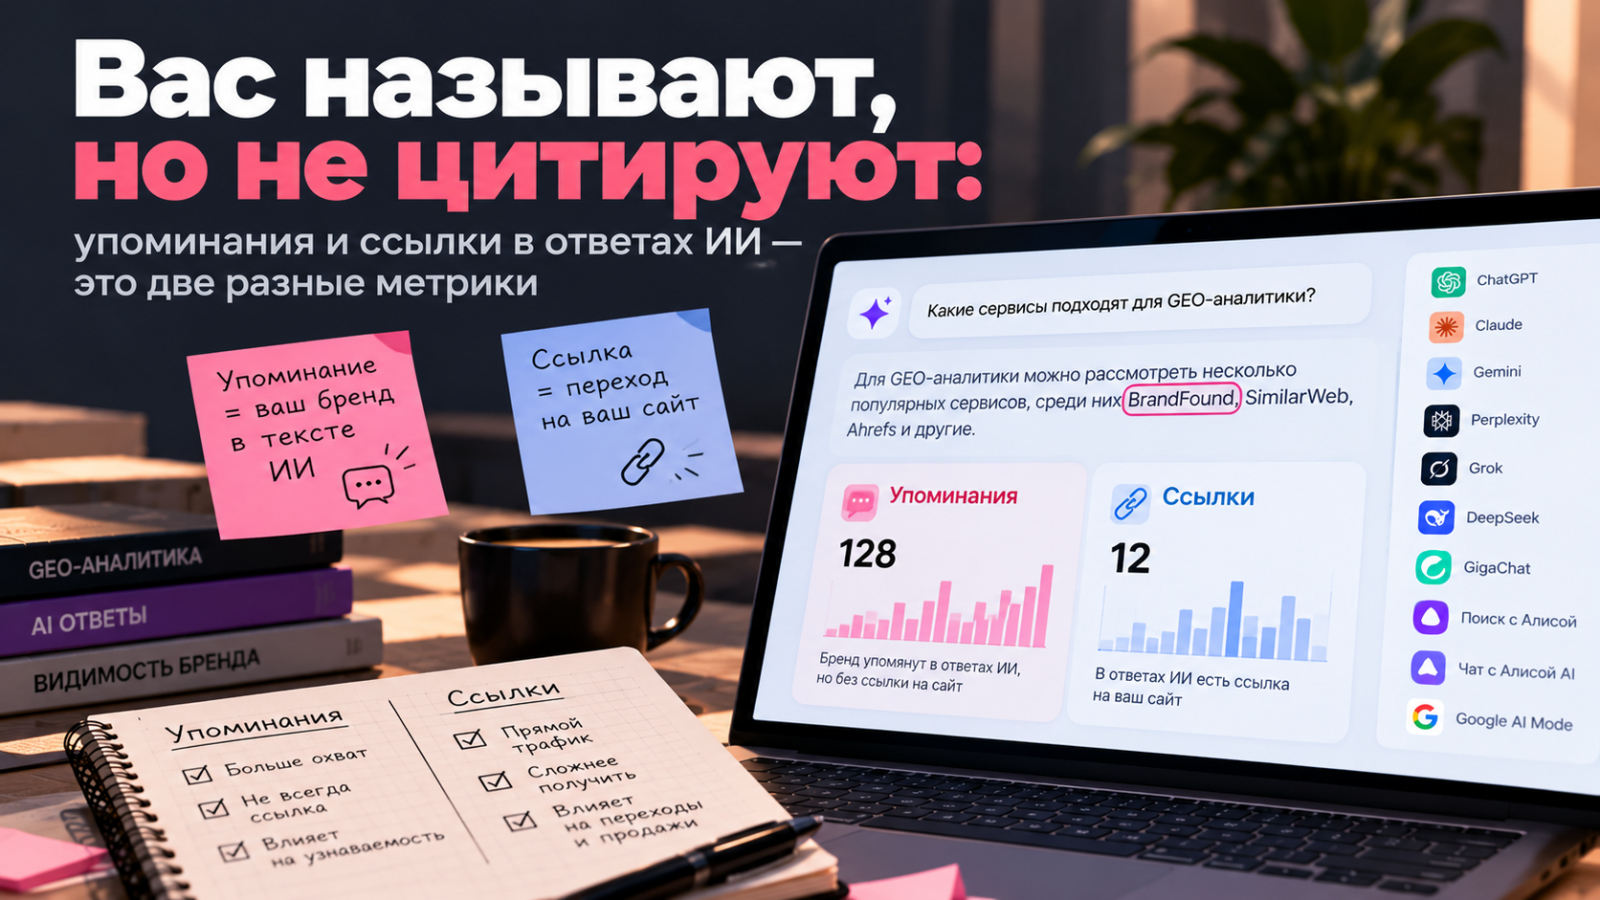
На созвоне клиент, крупный B2B-сервис, открывает наш отчёт и спрашивает: мы же у вас в лидерах по упоминаниям, почему тогда переходов из нейросетей почти нет? Вопрос правильный, и отвечать на него приходится не цифрой, а разбором: в привычной строке «видимость в ИИ» у нас обычно склеены две разные вещи.
Бренд можно называть и не ссылаться на него. Можно ссылаться и почти не называть. Это не брак замера. Это два механизма внутри одного ответа: один показывает, что модель о вас уже знает, второй - какие страницы она берёт в работу прямо сейчас.
Разрыв между упоминаниями и цитированием доходит до десятикратного
В конце октября вышло исследование сервиса Sentic: 55 американских брендов, пять отраслей, пять AI-систем. Самый наглядный пример в категории B2B-сервисов. Slack получил 13,2% упоминаний среди исследованных брендов своей отрасли и только 3,7% цитирований. У monday.com картина ровно обратная: 0,4% упоминаний и 5,5% цитирований.
- Упоминания - сколько раз нейросеть называет бренд в тексте своего ответа.
- Цитирования - сколько раз она ссылается на страницы бренда как на источник.
- Одно из другого не вытекает: знание модели о компании и её выбор источника формируются по-разному.
Высокие упоминания и низкие цитирования - это разные задачи, а не разная степень успеха
По нашей агентской выборке за год такой разрыв встречается постоянно, и за ним стоят узнаваемые причины. Если бренд называют часто, а ссылаются редко, модель знает о нём из чужих текстов: обзоров, подборок, форумов, статей конкурентов. Собственный сайт ей при этом не нужен, потому что на нём нет того, что хочется процитировать, - ни конкретики, ни цифр, ни внятного ответа на вопрос. Обратный случай, когда ссылок больше, чем упоминаний, обычно означает справочный материал, который удобно брать как источник, но неудобно приводить как рекомендацию.
Для клиента это два разных плана работ. В первом случае мы перестраиваем сайт и контент: страницы под вопросы, которые люди задают нейросетям, факты и методики в тексте. Во втором занимаемся присутствием бренда в чужих материалах и в источниках, которые модель уже читает. Перепутать эти два диагноза легко, если в отчёте одна сводная цифра видимости.
Что это значит для российского рынка
Переносить проценты Sentic на российские проекты нельзя, а сам разрыв - можно и нужно. У нас к тому же набор источников другой. В ответах Поиска с Алисой и Чата с Алисой заметно тянут Яндекс-поверхности, маркетплейсы и отзывные площадки, в GigaChat сильнее профильные медиа и крупные справочники, а ChatGPT и Claude по русским запросам часто уходят на англоязычные обзоры, которых клиент в своём отчёте не ждёт. Поэтому замер без разбивки по нейросетям и без списка источников у нас бесполезен ещё сильнее, чем в американской выборке.
Второе следствие практическое: в России цитируемость обычно дешевле наращивать, чем упоминания. Своя страница - это наша работа и наш срок, а упоминание в чужом материале зависит от редакций и площадок. На пресейле я это говорю прямо, потому что клиент имеет право знать, какая часть результата от нас не зависит.
Что я отвечаю на возражение «у нас же хорошие упоминания»
Короткий ответ: хорошие упоминания означают, что вас есть за что называть, и ничего не говорят о том, читают ли нейросети ваш сайт. Дальше я показываю на живом примере - открываю в отчёте один ответ модели, где бренд назван, и список источников под этим же ответом, где его домена нет. После такого слайда разговор про две метрики заканчивается сам.
Как развести эти метрики в агентском отчёте
- Разделить в отчёте упоминания, рекомендации и цитируемые источники: это три разных столбца, а не один индекс.
- Считать каждую метрику по каждой нейросети отдельно: средняя по пяти системам прячет провал в двух.
- Под каждым ответом сохранять список доменов-источников - из него берутся темы для контент-плана.
- Фиксировать исходную точку до публикаций, иначе через квартал нечего показать.
- Один и тот же набор запросов гонять по расписанию: смена формулировок ломает сравнение.
- В договор писать работу и замер, а не обещанный процент видимости.
Инструментов под такой замер сейчас достаточно, и выбирают их по тому, разводит ли сервис эти метрики. Для клиентских замеров я беру GEO-сервисы мониторинга: например, brandfound считает упоминания, рекомендации и цитируемость раздельно по каждой нейросети, включая оба режима Алисы и GigaChat, и отдаёт источники под каждым ответом. Рядом в списке на проверку обычно стоят VisioBrand, PixelTools, Keys.so и Rush Analytics. Любой сервис прогоняйте по одному и тому же чек-листу: какие модели опрашивает, видно ли источники, можно ли повторить тот же набор запросов через месяц.
Тот клиент с созвона, с которого я начала, в итоге получил не новую цифру, а две колонки вместо одной. Выяснилось, что называют его хорошо, а ссылаться не на что: на сайте не было ни одной страницы, отвечающей на вопрос так, как его задают нейросети. Работа на квартал из этого собралась за полчаса. Одна сводная метрика видимости такого разговора не даёт - она показывает, что бренд в ответах есть, но не говорит, какую роль он там играет.