Table Transformer: где скачать и как пользоваться
Table Transformer — инструмент для разработчиков и команд, которые превращают таблицы из PDF и изображений в машинно-читаемую структуру. На Xeon Live можно скачать Table Transformer бесплатно и перейти к исходным материалам. Важная особенность проекта: это не настольный PDF-редактор с кнопкой «Открыть файл». Рабочий контур строится вокруг Python, inference.py, моделей обнаружения и распознавания структуры, а текст для HTML или CSV подаётся отдельно из OCR либо из текстового слоя PDF.
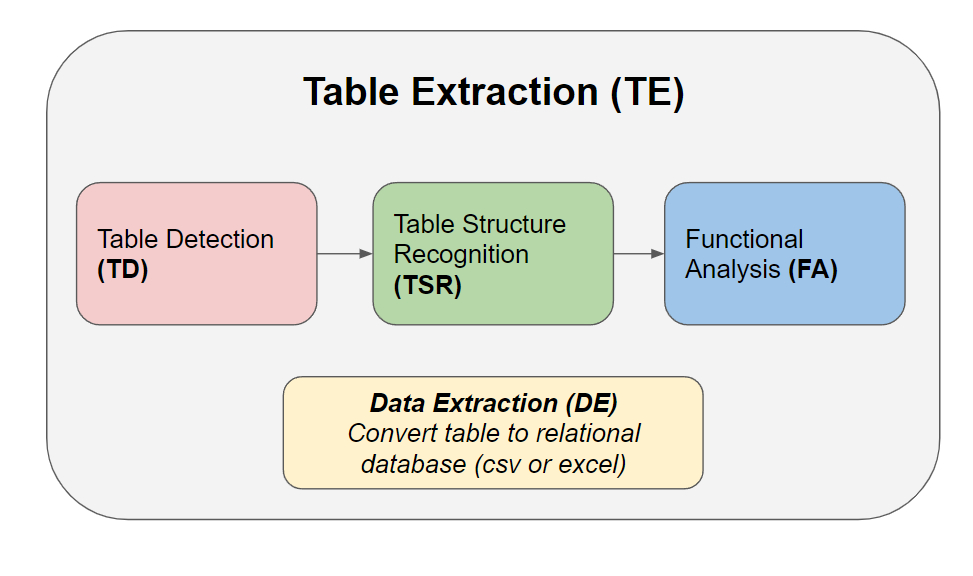
Поэтому Table Transformer полезно оценивать не как замену Acrobat или Excel, а как компонент конвейера обработки документов. Он сначала находит область таблицы, затем размечает строки, столбцы, заголовочные области и объединённые ячейки, после чего код связывает геометрию с токенами текста. Для общего контекста формата пригодится материал о том, как устроен PDF и какие способы извлечения данных из него применяются.
Что именно делает Table Transformer
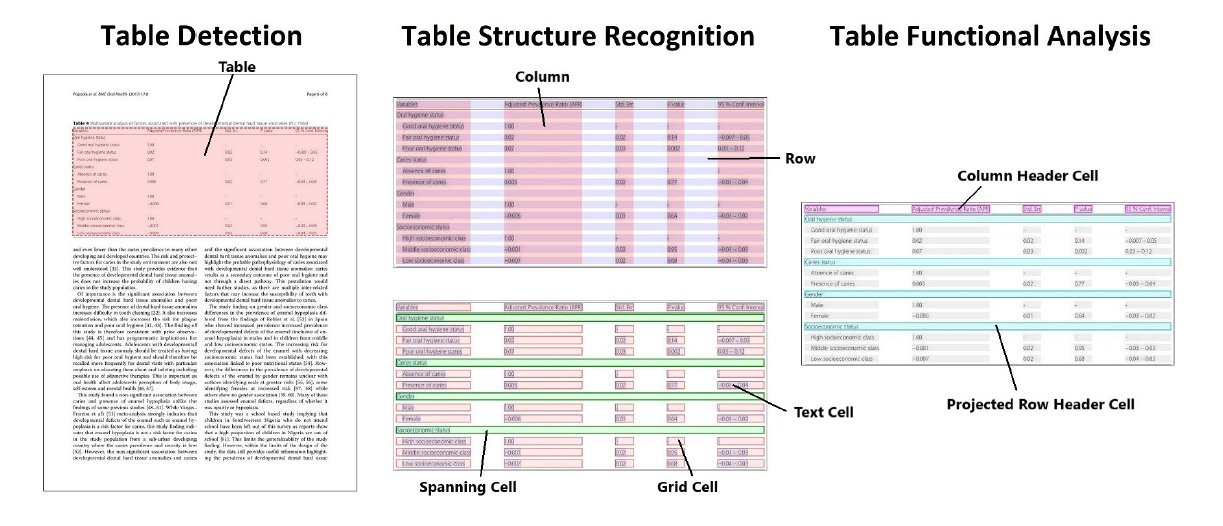
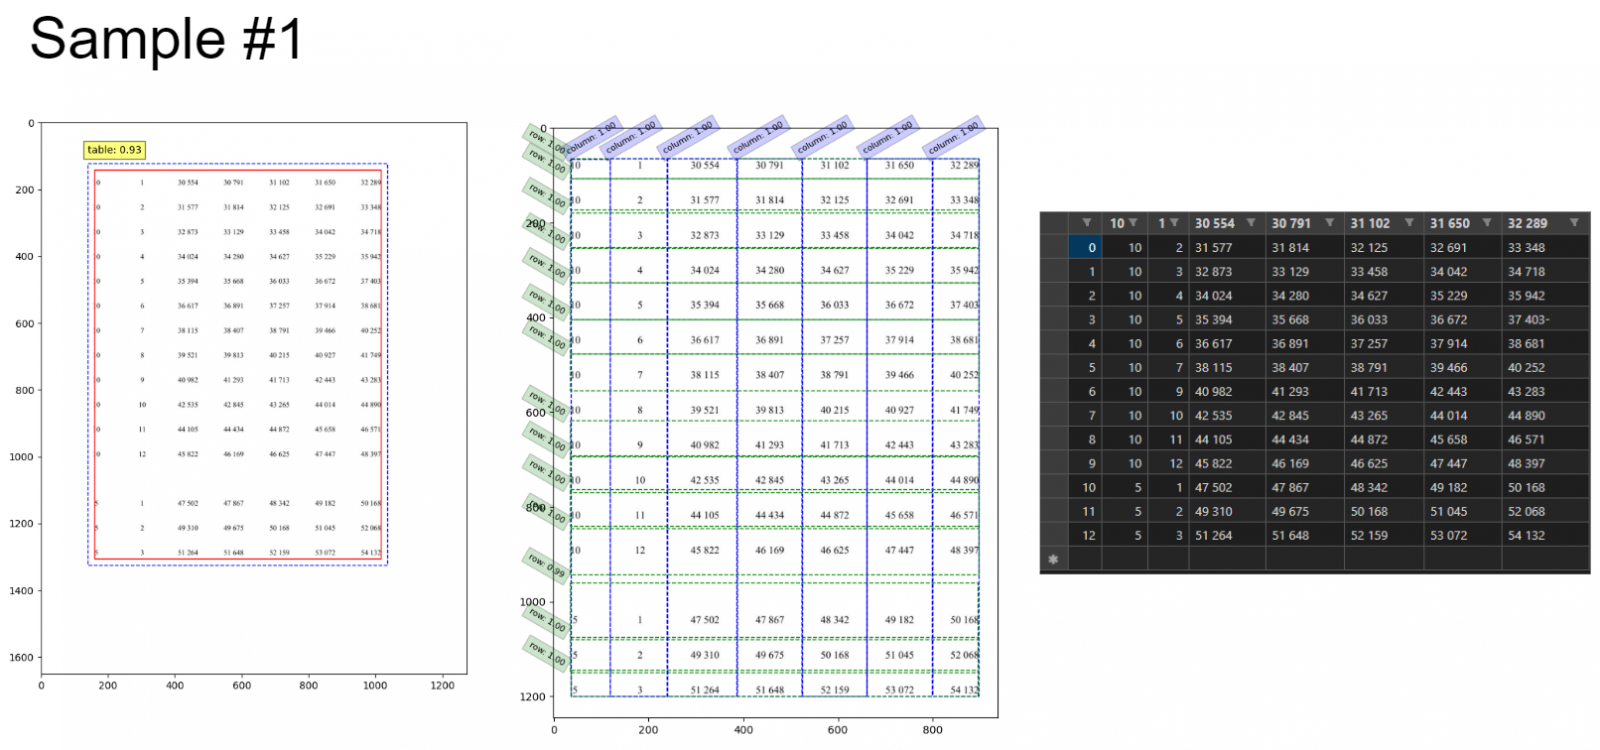
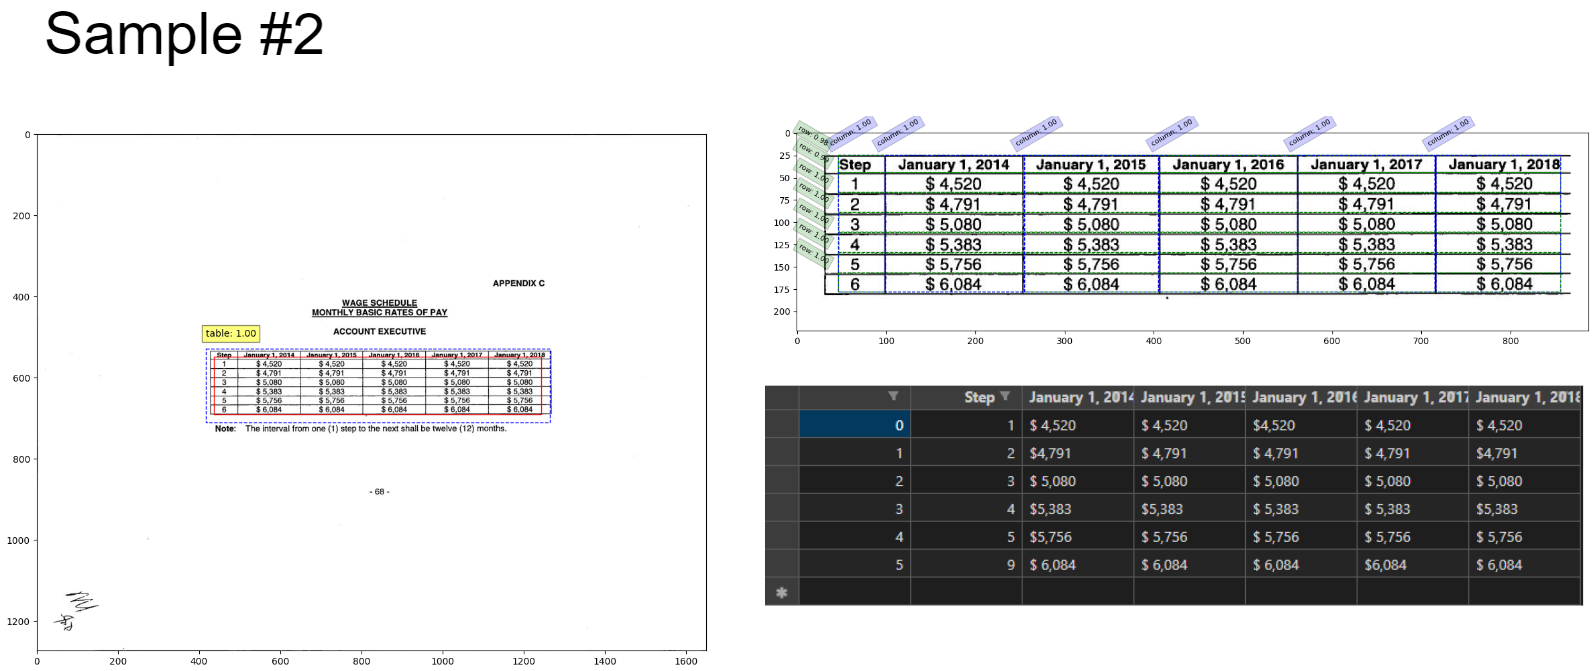
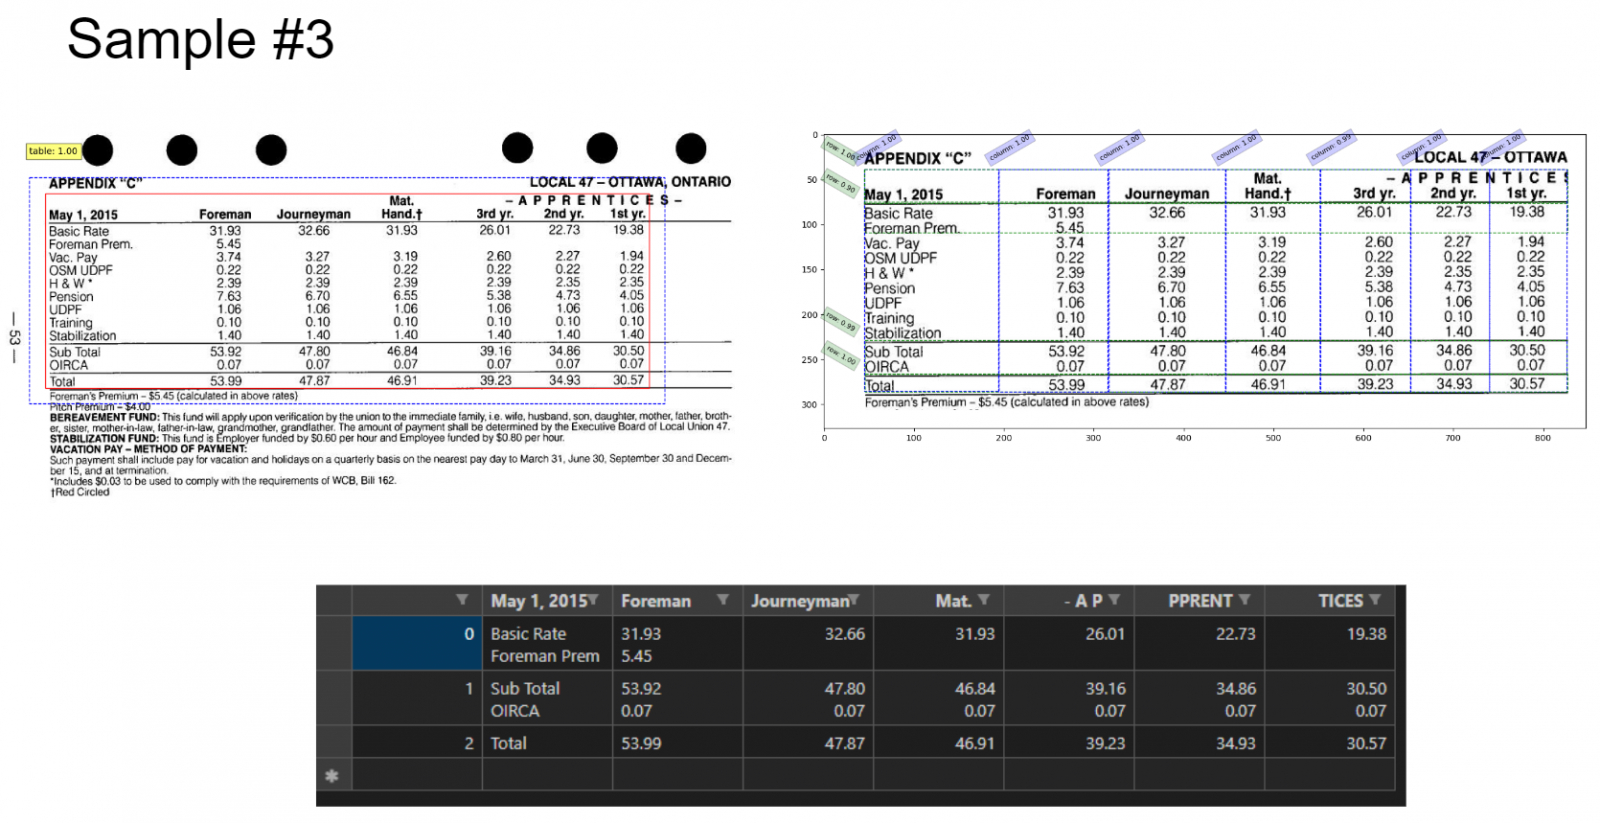
Table Transformer, или TATR, основан на подходе object detection: модель видит страницу или кроп таблицы как изображение и возвращает классы объектов с координатами. Официальный проект разделяет две основные задачи. Первая модель ищет таблицы на странице, включая повёрнутые. Вторая модель работает уже с областью таблицы и выделяет строки, столбцы, заголовок столбцов, projected row header и spanning cell. Затем постобработка собирает пересечения строк и столбцов в ячейки.
Карта рабочего контура: detect, recognize и extract
Практический «интерфейс» проекта — три режима inference.py. detect запускает только поиск таблиц; recognize принимает заранее вырезанную таблицу и восстанавливает её внутреннюю структуру; extract соединяет оба этапа. Во всех трёх режимах доступна геометрия объектов, а распознавание структуры дополнительно выдаёт список ячеек, HTML и CSV. Список ячеек сохраняет максимум информации, потому что в нём остаются координаты каждой ячейки.
HTML удобнее для переноса rowspan и colspan в веб-представление, однако координаты ячеек в нём не сохраняются. CSV ещё проще: многострочный заголовок приходится сводить к одной строке. Поэтому для последующего контроля качества, повторной разметки или привязки значений к странице разумно сохранять cells вместе с визуализацией, а CSV рассматривать как производный экспорт.
- Для поиска таблиц на страницах нужен detection config и checkpoint модели обнаружения.
- Для структуры уже вырезанной таблицы нужен structure config и checkpoint модели распознавания структуры.
- Для полного режима extract нужны оба конфига и оба checkpoint-файла.
- Для появления текста в HTML и CSV нужен words/tokens JSON с текстом и координатами слов; одна картинка даёт структуру, но не текстовое содержимое.
Подготовка окружения, моделей и исходных данных
Установка начинается с официального репозитория: в нём есть environment.yml, конфигурации, inference.py и постобработка. Репозиторий обновлял окружение до Python 3.10.9, PyTorch 1.13.1 и torchvision 0.14.1. Для воспроизводимого запуска удобнее создать отдельное conda-окружение из environment.yml, активировать его и выполнять команды из каталога src, как показано в документации проекта.
Шаг за шагом: собрать минимальный набор для инференса
1. Склонируйте репозиторий и создайте окружение командой conda env create -f environment.yml. Затем активируйте его командой conda activate tables-detr. Это снижает риск несовместимости версий Torch и torchvision с кодом проекта.
2. Для первого полного прогона подготовьте четыре файла: detection_config.json, checkpoint детектора, structure_config.json и checkpoint модели структуры. В репозитории опубликованы веса DETR R18 для детекции и несколько вариантов структуры. Базовый вариант обучен на PubTables-1M; TATR-v1.1-Pub ориентирован на PubTables-1M, TATR-v1.1-Fin — на FinTabNet.c, TATR-v1.1-All — на объединение PubTables-1M и FinTabNet.c. Выбор модели должен совпадать с типом документов, а не с названием выходного файла.
3. Создайте отдельные каталоги, например input_pages для страниц, words для токенов и output для результата. Командная версия inference.py перебирает изображения в image_dir. Практически удобно давать страницам стабильные имена без пробелов и хранить рядом words JSON с тем же базовым именем и суффиксом _words.json. Такое соответствие прямо используется в текущем коде загрузки.
4. Для PDF сначала превратите нужные страницы в растровые изображения. Сам Table Transformer принимает PIL.Image, а не PDF-контейнер. Разрешение выбирайте так, чтобы мелкие символы не сливались и линии таблицы сохранялись. После рендеринга визуально проверьте несколько страниц: поворот, обрезку полей, качество текста и отсутствие пустых кадров.
5. Для цифрового PDF извлеките слова и координаты из текстового слоя; для скана выполните OCR. Структура tokens — список словарей с полями text и bbox, где bbox задаётся как [xmin, ymin, xmax, ymax] в координатах изображения и элементы идут в порядке чтения. Практические способы распознавания текста разобраны в материале о распознавании текста в PDF. Координаты OCR обязаны относиться к той же растровой странице, которая поступает в модель.
6. Перед массовым запуском сделайте один контрольный пример. Убедитесь, что изображение открывается PIL, names в image_dir и words_dir совпадают, checkpoint загружается без ошибки и устройство указано корректно. Значения detection_device и structure_device по умолчанию равны cuda. На машине без настроенной CUDA укажите cpu для обоих параметров, чтобы код не пытался перенести модель на недоступное устройство.
7. Сохраните точную команду и набор весов рядом с результатами. Для производственного процесса это важнее «последней версии» как таковой: одинаковая страница, одинаковый checkpoint, одинаковый config и одинаковая предобработка должны приводить к сопоставимому результату. Смена модели структуры или способа подготовки токенов — отдельное изменение конвейера, которое следует проверять на контрольной выборке.
8. Не смешивайте конфигурацию одной модели с checkpoint другой. Файлы config задают архитектурные параметры, по которым build_model создаёт сеть перед загрузкой state_dict. Практический порядок такой: храните config и веса парой, фиксируйте их имена в журнале запуска и после замены checkpoint заново выполняйте тест на тех же страницах. Ошибка загрузки весов обычно видна сразу, а несовпадение домена проявляется позже — в пропущенных строках, заголовках и объединённых ячейках. Поэтому техническая загрузка модели не заменяет проверку качества на реальных документах.
Как обнаружить таблицы на страницах
Режим detect нужен, когда на странице сначала требуется понять, где находятся таблицы. Он не строит CSV и не восстанавливает ячейки. Его задача — вернуть объекты table или table rotated, сохранить координаты и, при необходимости, вырезать найденные области для следующего шага. В текущем исходном коде порог для двух классов детекции задан 0,5.
Шаг за шагом: режим detect и контроль кропов
1. Перейдите в каталог src. Подготовьте image_dir с изображениями страниц и out_dir для результатов. Подключение words_dir на этом этапе необязательно для геометрии, но полезно, когда вместе с кропом требуется сохранить соответствующие ему токены.
2. Запустите inference.py с mode detect, путями к detection_config.json и checkpoint детектора, параметром detection_device, каталогом изображений и выходным каталогом. Для практической проверки включите -o, -p и -z: -o сохраняет объекты с bounding box, -p — кропы найденных таблиц и обрезанные токены, -z — визуализацию найденных таблиц. -v выводит подробности в консоль.
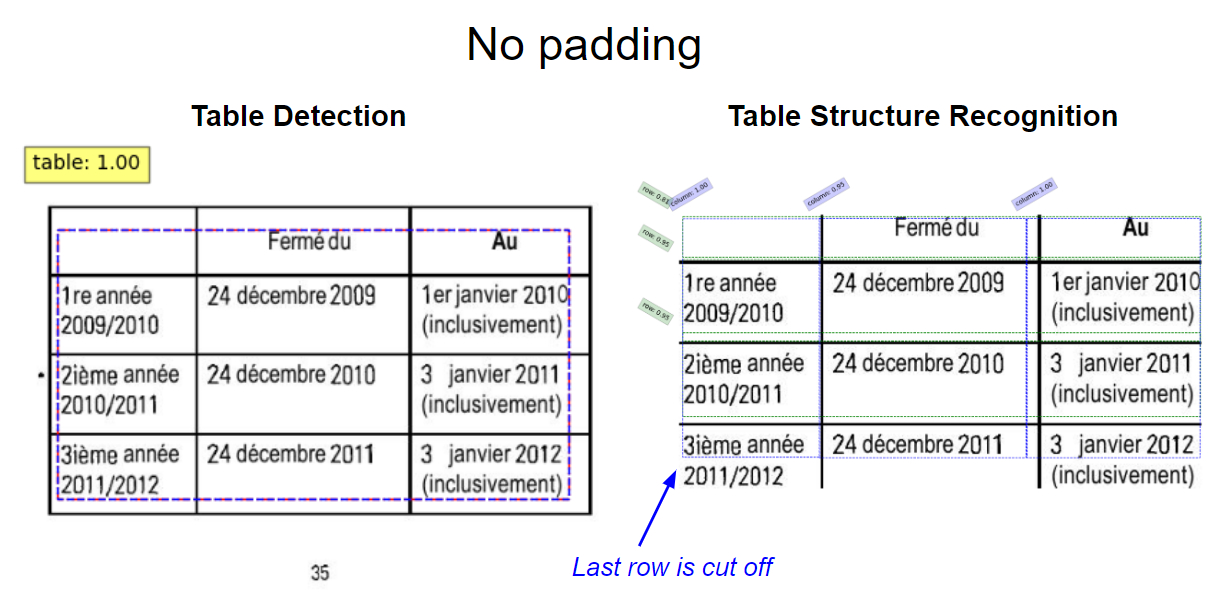
3. Отдельно задайте crop_padding. В текущем inference.py значение по умолчанию равно 10 пикселям, а пример команды в INFERENCE.md явно задаёт 20. Это не противоречие: документация прямо указывает подбирать отступ под модель структуры. Для TATR-v1.1-All карточка весов автора, напротив, ориентирует на очень плотный кроп — до 5 пикселей. Поэтому фиксировать один универсальный отступ для всех checkpoint нельзя; его выбирают после контрольного прогона конкретной модели.
4. Откройте сохранённые визуализации. Bounding box должен полностью включать верхний и нижний края таблицы, заголовок не должен оказаться снаружи, а соседний текст страницы — попадать внутрь только в минимальном объёме. Особенно внимательно проверяйте безрамочные таблицы и подписи, расположенные над сеткой: ошибка на этом этапе автоматически переносится в распознавание структуры.
5. Проверьте класс rotated. Для объекта table rotated код при создании кропа поворачивает изображение на 270 градусов и пересчитывает bbox токенов. После поворота откройте как картинку, так и words JSON: координаты слов должны лежать внутри новой ширины и высоты, а порядок чтения не должен разъехаться.
6. Для папки из сотен страниц начните с небольшой репрезентативной выборки: обычная таблица, таблица без линий, таблица с многоуровневым заголовком, повернутая таблица и таблица у края страницы. После проверки отступа и качества кропа запускайте весь каталог. Такой порядок отделяет ошибки детектора от ошибок OCR и структуры и резко упрощает диагностику.
7. Для задач, где нужен не только регион, но и готовое содержимое таблицы, после detect переходите к recognize либо сразу используйте extract. Общая логика извлечения таблиц из PDF с точки зрения пользователя дополнена в инструкции как вытащить таблицу из PDF; Table Transformer в этом процессе отвечает прежде всего за геометрию и структуру.
8. Для автоматической проверки детектора сохраняйте не только кроп, но и JSON объектов. У каждого объекта есть label, score и bbox. На контрольной выборке удобно считать долю страниц без найденных таблиц, число таблиц на страницу и долю рамок, которые касаются края изображения. Резкое изменение этих показателей после обновления модели или рендера сигнализирует о сдвиге конвейера раньше, чем ошибка попадёт в итоговый CSV. Такой мониторинг не оценивает смысл данных, но хорошо ловит технические регрессии детекции.
Как распознать строки, столбцы и объединённые ячейки
Режим recognize работает с изображением одной таблицы. Внутри модели используются классы table column, table row, table column header, table projected row header и table spanning cell. После детекции этих объектов постобработка согласует строки и столбцы и строит ячейки на пересечениях, включая объединённые области.
Шаг за шагом: режим recognize
1. Сложите вырезанные таблицы в отдельный image_dir. Для каждой картинки подготовьте соответствующий words JSON, когда итог должен содержать текст. Кроп и токены должны быть получены из одного и того же исходного изображения и с одинаковым преобразованием координат.
2. Запустите inference.py с mode recognize, укажите structure_config_path, structure_model_path и structure_device. Подключите words_dir и out_dir. Для полной диагностики используйте -o, -l, -m, -c и -z: объекты, список ячеек, HTML, CSV и визуализация структуры сохраняются параллельно. Это удобнее, чем сразу смотреть только CSV, потому что ошибка становится видна на уровне, где она возникла.
Отдельно учитывайте расхождение между текстом INFERENCE.md и текущей функцией main в inference.py. Документация назначает флаг -l для вывода cells, а в текущей ветке main вызов recognize передаёт out_cells из args.csv. Поэтому для CLI этой ревизии включайте -c вместе с -l: CSV активирует построение cells, после чего output_result сохраняет список ячеек. В прямом Python API такого обходного пути нет — параметр out_cells передаётся методу recognize напрямую. Это важная деталь для воспроизводимого запуска именно текущего кода.
3. Сначала откройте визуализацию объектов. Проверьте, что table row покрывает каждую логическую строку, table column — каждый столбец, а заголовочная область не захватывает строки данных. В таблицах со spanning cell отдельно убедитесь, что объединённая ячейка не разбита на несколько независимых ячеек и не перекрывает соседний столбец.
4. Затем изучите cells JSON. Для каждой ячейки важны bbox, принадлежность к строкам и столбцам, признаки column header или projected row header и текст. Именно cells содержит наиболее полное представление результата. При разработке последующей бизнес-логики лучше строить проверки на cells, а HTML и CSV формировать уже после контроля структуры.
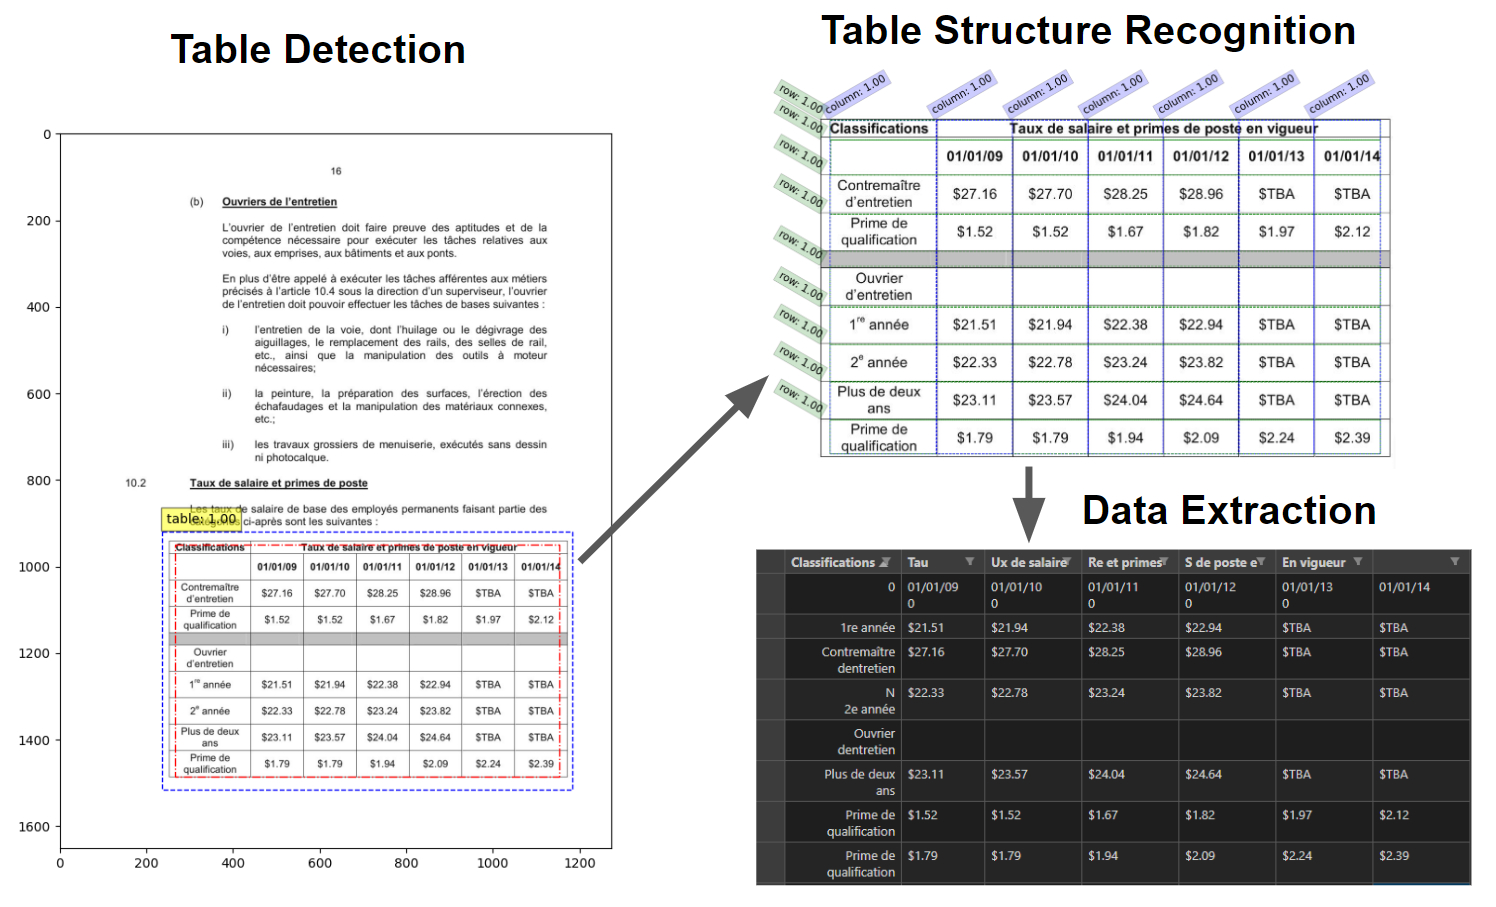
5. Сопоставьте два-три значения с оригиналом: левый верхний заголовок, число в середине таблицы и крайнее значение в последней строке. Три точки быстро выявляют типичные смещения: потерянный заголовок, слияние соседних столбцов или обрезку нижнего края. После этого выборочно проверяйте spanning cell и строки с пустыми ячейками.
6. При систематической ошибке не правьте CSV вручную. Возвращайтесь на один этап назад: сначала проверяйте кроп, затем структуру, затем tokens. Ошибка геометрии должна исправляться на уровне изображения или модели структуры; ошибка текста — на уровне OCR или извлечения слов. Такое разделение сохраняет повторяемость процесса и позволяет улучшать весь пакет документов, а не один файл.
Как получить HTML, CSV и список ячеек
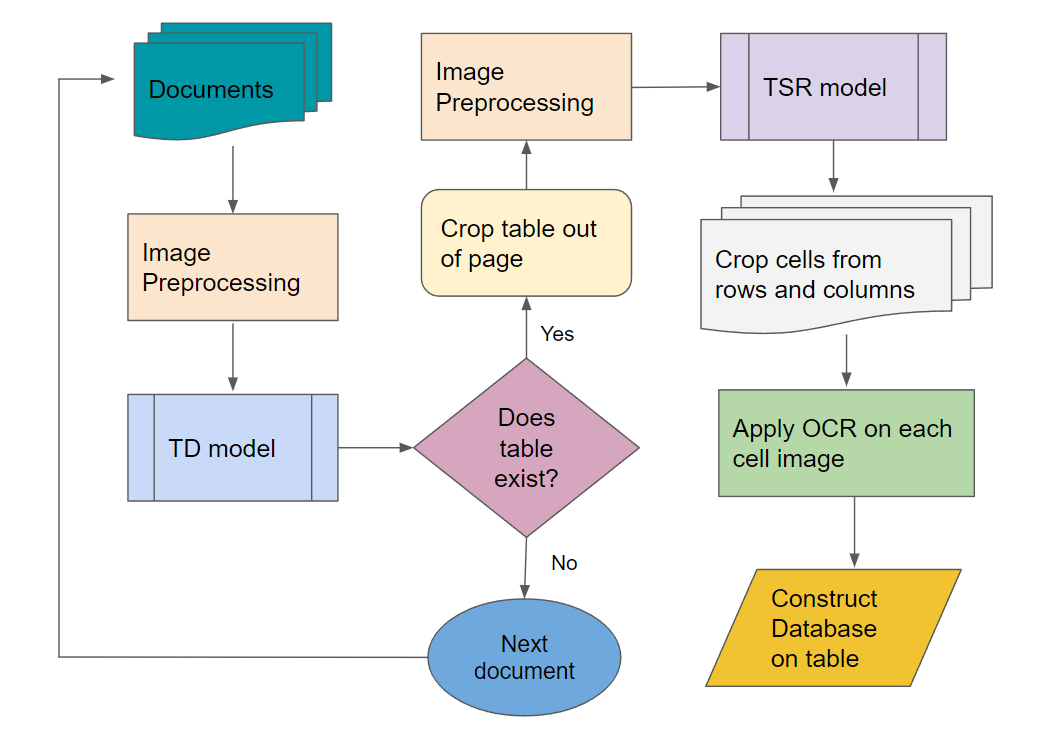
Полный режим extract полезен, когда входом служит изображение страницы, а выходом нужен комплект результатов по всем найденным таблицам. Он вызывает детектор, создаёт кропы, передаёт каждый кроп в распознавание структуры и собирает результаты. Для текстового экспорта по-прежнему нужны tokens.
Шаг за шагом: end-to-end extract и Python API
1. Подготовьте те же четыре модельных файла, что и для раздельного процесса: detection config и checkpoint, structure config и checkpoint. Укажите image_dir, words_dir и out_dir. Режим extract принимает параметры обоих устройств и crop_padding, поэтому одна команда полностью фиксирует рабочую конфигурацию.
2. Запустите inference.py с mode extract. Для контроля включите -o, -l, -m, -c, -z и -p. В результате для каждой найденной таблицы появятся геометрия объектов, ячейки, HTML/CSV, визуализация и связанные кропы там, где это предусмотрено выбранными флагами. Названия файлов формируются на основе имени входного JPG и номера таблицы.
3. Откройте сначала cells, затем HTML, затем CSV. Cells используйте как эталон структуры внутри конвейера. HTML сохраняет табличную разметку лучше CSV, потому что умеет выражать объединения ячеек. CSV предназначен для плоской сетки; многострочный заголовок сводится к первой строке, поэтому сравнивать его с исходной страницей нужно с учётом этой потери информации.
4. Для интеграции в собственный сервис используйте класс TableExtractionPipeline. В конструктор передаются пути к двум config, двум checkpoint и устройства. Метод recognize принимает PIL.Image и tokens и возвращает выбранные через параметры objects, cells, html и csv. Метод detect возвращает объекты и кропы, а extract соединяет этапы. Такой API удобен для очереди заданий, где изображения уже загружены в память и не требуется запускать отдельный процесс для каждой страницы.
5. На выходе сохраняйте вместе три сущности: исходный идентификатор страницы, cells и визуализацию. CSV удобно передавать аналитикам, но он не должен быть единственным артефактом проверки. При спорном значении cells показывает границы ячейки, а визуализация позволяет сразу увидеть, правильно ли модель разделила строки и столбцы.
6. Для дальнейшей работы в электронных таблицах сначала проверьте структуру и текст, затем импортируйте CSV в нужную систему. Отдельный сценарий конвертации документов разобран в материале о преобразовании PDF в Excel. Table Transformer не создаёт XLSX сам: официальный inference-пайплайн формирует HTML и CSV, а Excel-файл получают уже следующим инструментом.
7. Для многостраничного документа присваивайте таблицам стабильный составной идентификатор: документ, номер страницы, номер таблицы. Это позволяет повторно прогнать только проблемные страницы после изменения OCR или checkpoint и затем заменить конкретные результаты, не пересобирая набор вручную.
8. После экспорта добавьте машинную валидацию. Сверяйте число строк и столбцов с ожидаемым диапазоном, ищите пустые заголовки, дубликаты имён столбцов и ячейки, в которых внезапно склеились значения разных колонок. Для финансовых и отчётных таблиц отдельно контролируйте десятичные разделители, проценты и отрицательные значения. Такой слой не исправляет модель, но не позволяет технически корректному CSV незаметно превратиться в логически неверные данные.
Как подать текст и проверить связку с OCR
Table Transformer распознаёт визуальную структуру, но содержимое ячеек появляется только после сопоставления со словами. Официальная документация прямо отделяет этот ввод: tokens — список слов и bbox, отсортированный в порядке чтения. В командном скрипте при отсутствии span_num, line_num и block_num текущий код добавляет эти поля автоматически, однако text и bbox остаются обязательными смысловыми данными.
Шаг за шагом: подготовка tokens без смещения координат
1. Получите слова из текстового слоя PDF либо OCR. Для каждого слова сохраните исходный текст и прямоугольник в координатах той страницы, которая будет передана модели. Не смешивайте PDF-координаты в пунктах с пиксельными координатами PNG: перед записью bbox выполните пересчёт в систему изображения.
2. Упорядочьте tokens по чтению. Для обычной страницы это движение сверху вниз с последовательностью слов слева направо внутри строки. Порядок нужен постобработке, когда она собирает текст ячейки из нескольких слов. Токены со случайным порядком способны дать правильный bbox ячейки, но неестественную последовательность текста.
3. Назовите файл в words_dir по схеме, которую ожидает CLI: для page_001.jpg используется page_001_words.json. Текущий код также принимает объект верхнего уровня с полем words и извлекает список оттуда. После загрузки он заполняет недостающие span_num, line_num и block_num, что уменьшает число служебных требований к простому OCR-экспорту.
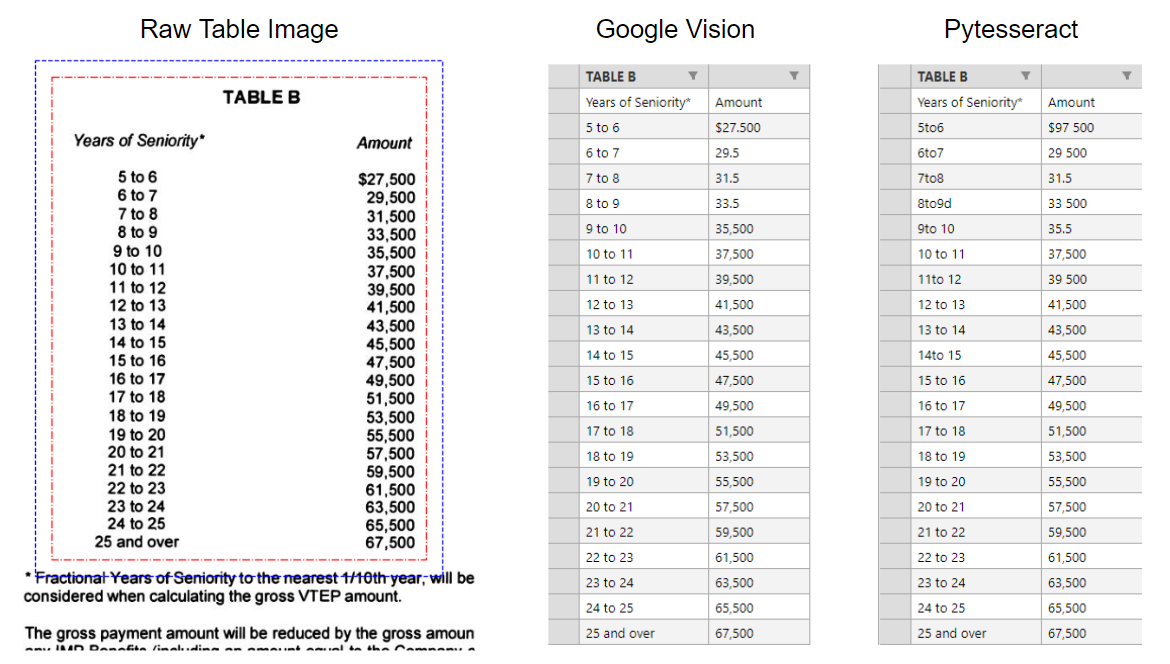
4. Проверьте координаты на одном примере. Нарисуйте bbox нескольких слов поверх исходного изображения любым вспомогательным скриптом или откройте диагностическую визуализацию. Прямоугольник слова должен лежать на символах, а не быть сдвинутым после масштабирования или поворота. Систематический сдвиг на одинаковую величину у всех слов указывает на ошибку преобразования координат.
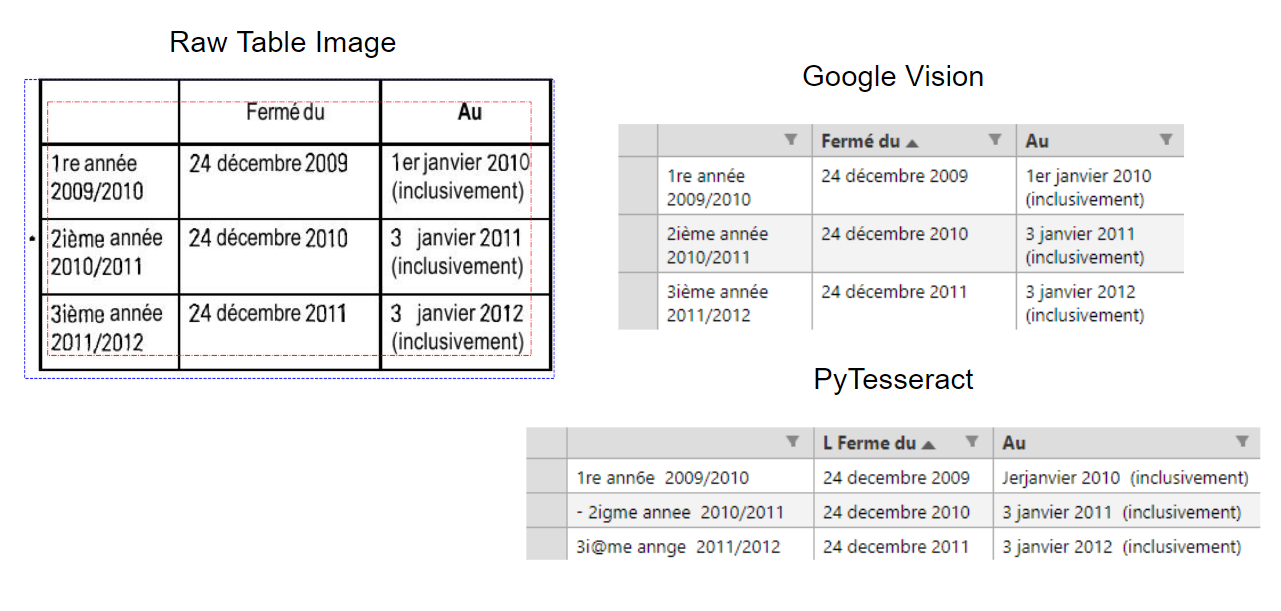
5. Запустите recognize с -l, -m и -c. Сравните текст в cells с OCR-источником. Потери символов, неверные десятичные разделители и смешанные даты относятся к качеству OCR; слияние значений соседних столбцов чаще связано с границами структуры или координатами токенов. Диагностика должна различать эти классы ошибок.
6. Для цифровых документов отдавайте предпочтение текстовому слою PDF, когда он содержит реальные слова и корректные координаты. OCR полезен для сканов и изображений. Главный критерий — совпадение текста и геометрии с тем же растровым представлением страницы, а не конкретный движок распознавания.
7. Поворот страницы обрабатывайте до связывания текста. Детектор знает отдельный класс table rotated и при создании кропа поворачивает такую таблицу вместе с токенами. Для внешнего OCR надёжнее заранее нормализовать ориентацию страницы либо передавать токены в исходных координатах и доверять преобразованию, которое выполняет тот же код кропа. Смешивание уже повёрнутой картинки с bbox от неповёрнутой страницы даёт внешне правдоподобные слова, но распределяет их по неверным ячейкам.
Настройка качества, производительности и типичных ошибок
Производительность Table Transformer определяется не одной «настройкой качества», а связкой устройства, размера входа, кропа и качества tokens. В текущем inference.py детекционный transform масштабирует максимальную сторону до 800 пикселей, а structural transform — до 1000, после чего применяется стандартная нормализация. Эти значения зашиты в пример inference-кода и задают реальный рабочий масштаб модели.
Шаг за шагом: как искать причину плохого результата
1. Начните с геометрии страницы. Откройте исходный рендер и результат detect. Потерянная часть таблицы исправляется на уровне рендера или crop_padding, а не в CSV. Для TATR-v1.1-All держите в уме ограничение карточки модели: она обучалась на плотных кропах с отступом около 5 пикселей или меньше; большой фон вокруг таблицы ухудшает соответствие данным обучения.
2. Затем проверьте структуру. Включите -z и -l, сравните визуализацию с cells. Неправильно найденный столбец, пропущенная строка или лишняя spanning cell относятся к модели структуры и постобработке. Повторный OCR не исправляет границу столбца, потому что модель структуры работает по изображению.
3. После структуры проверьте текст. Правильные границы при ошибочных цифрах означают проблему OCR или tokens. Правильный OCR при пустом CSV указывает на отсутствие words_dir, несовпадение имён файлов или координат. Убедитесь, что токены попадают внутрь ячеек и относятся к текущему кропу.
4. Для скорости сначала выберите устройство. detection_device и structure_device по умолчанию настроены на cuda. На рабочей станции с совместимой CUDA обе модели можно держать на GPU; на CPU явно укажите cpu. Сравнивайте время на одинаковой выборке и одинаковых моделях, иначе результат замера не показывает эффект устройства.
5. Пакетную обработку стройте каталогами. CLI сам перебирает image_dir, поэтому отдельный запуск на каждую страницу не нужен. Логируйте имя изображения, модель, config, crop_padding и наличие words. Ошибку одного файла сохраняйте отдельно и продолжайте конвейер на остальных страницах через собственную оболочку, а не смешивайте неполные результаты с готовыми CSV.
6. После изменения параметров повторяйте контрольную выборку, а не весь архив. Минимальная проверка включает таблицу с сеткой, безрамочную таблицу, многоуровневый заголовок, spanning cell, мелкий шрифт и поворот. Стабильный набор примеров превращает настройку в воспроизводимый процесс, а не в ручной подбор на одной удачной странице.
7. Не меняйте пороги классов только ради одного сложного примера. В текущем inference.py для table, table rotated и всех структурных классов задано 0,5, а затем постобработка выполняет выравнивание и подавление перекрывающихся объектов. Снижение порога увеличивает число кандидатов и способно добавить ложные строки или столбцы; повышение порога, наоборот, отбрасывает слабые, но реальные элементы. Изменение порогов оформляйте как отдельную конфигурационную правку с повторной оценкой контрольной выборки.
Плюсы, минусы, альтернативы и практический выбор
Table Transformer особенно уместен в конвейерах, где нужна не просто строка текста, а геометрическая структура таблицы: строки, столбцы, заголовочные зоны и объединённые ячейки. Проект открыт по MIT, предоставляет исходный код обучения и инференса и имеет готовые веса для детекции и структуры. PubTables-1M содержит 575 305 размеченных страниц и 947 642 полностью размеченные таблицы, поэтому базовые модели опираются на крупный специализированный набор.
Плюсы
- Раздельные модели детекции и структуры упрощают диагностику: видно, на каком этапе возникла ошибка.
- Есть полный режим extract, а также Python-класс TableExtractionPipeline для встраивания в собственный сервис.
- Cells сохраняет координаты каждой ячейки и даёт более богатое представление, чем плоский CSV.
- Поддерживаются таблицы без явной сетки, заголовочные области, projected row header и spanning cell как отдельные структурные классы.
- Код и веса доступны открыто; репозиторий также содержит инструменты обучения и оценки GriTS.
Минусы
- Нет готового оконного приложения для ручной работы с PDF: необходим Python-конвейер и подготовка входных изображений.
- Текст не появляется из изображения автоматически в официальном inference-пайплайне: OCR или извлечение текстового слоя подключается отдельно.
- CSV теряет часть структуры сложных заголовков; для точного контроля приходится хранить cells или HTML.
- Качество зависит от кропа, качества рендера, домена документов и конкретного checkpoint; сложные таблицы требуют контрольной выборки.
- Готовые веса ориентированы на обучающие домены PubTables-1M и FinTabNet.c, поэтому для специфических бланков и отраслевых форм требуется отдельная оценка, а иногда дообучение.
Кому подойдёт
Проект подходит разработчикам, инженерам данных, командам document AI и внутренней автоматизации, которым нужен воспроизводимый пайплайн извлечения таблиц из сканов и PDF-страниц. Он также полезен как отдельный модуль: один сервис рендерит PDF, другой создаёт OCR tokens, Table Transformer восстанавливает структуру, а последующий слой валидирует и загружает данные в хранилище.
Для пользователя, которому нужно вручную открыть один PDF и сразу получить Excel без Python, Table Transformer избыточен. Для такого сценария удобнее готовый конвертер или OCR-приложение. Для разработчика, которому важны bounding box каждой ячейки, собственная постобработка и контроль модели, напротив, именно программная архитектура TATR является главным достоинством.
Среди реальных альтернатив есть Camelot, PaddleOCR PP-StructureV3 и Docling. Camelot хорошо работает с PDF, где таблица представлена текстовыми операторами; его документация прямо отмечает, что image-only сканы без OCR не содержат текста для извлечения. PP-StructureV3 объединяет layout analysis, OCR, распознавание таблиц и другие элементы документа и умеет выдавать структурированные результаты. Docling конвертирует PDF в собственную модель документа, имеет распознавание структуры таблиц и экспорт таблиц в CSV и HTML.
Выбор зависит от исходных данных. Для born-digital PDF с чистым текстовым слоем Camelot часто сокращает число этапов. Для комплексного разбора документа с OCR, формулами и порядком чтения удобнее цельный стек вроде PP-StructureV3 или Docling. Table Transformer остаётся сильным вариантом, когда центральная задача — именно детекция и геометрическая структура таблицы, а OCR и бизнес-правила уже существуют отдельно.
Практическая рекомендация для внедрения проста: не начинайте с массовой конвертации. Зафиксируйте 20–50 характерных страниц, сохраните cells, HTML, CSV и визуализации, определите допустимые ошибки по строкам и столбцам, затем выберите checkpoint и crop_padding. После этого автоматизируйте пакетный прогон и оставьте выборочную проверку для документов с низким качеством, сложными объединёнными заголовками и нетипичной версткой.
Table Transformer не заменяет OCR, PDF-рендерер и систему контроля данных, но хорошо выполняет свою специализированную роль между ними. При таком разделении ответственности его проще поддерживать: детектор отвечает за область таблицы, structure model — за сетку и функциональные элементы, tokens — за текст, а cells служит проверяемым промежуточным форматом перед HTML, CSV и дальнейшей аналитикой.