TableNet: где скачать и как пользоваться
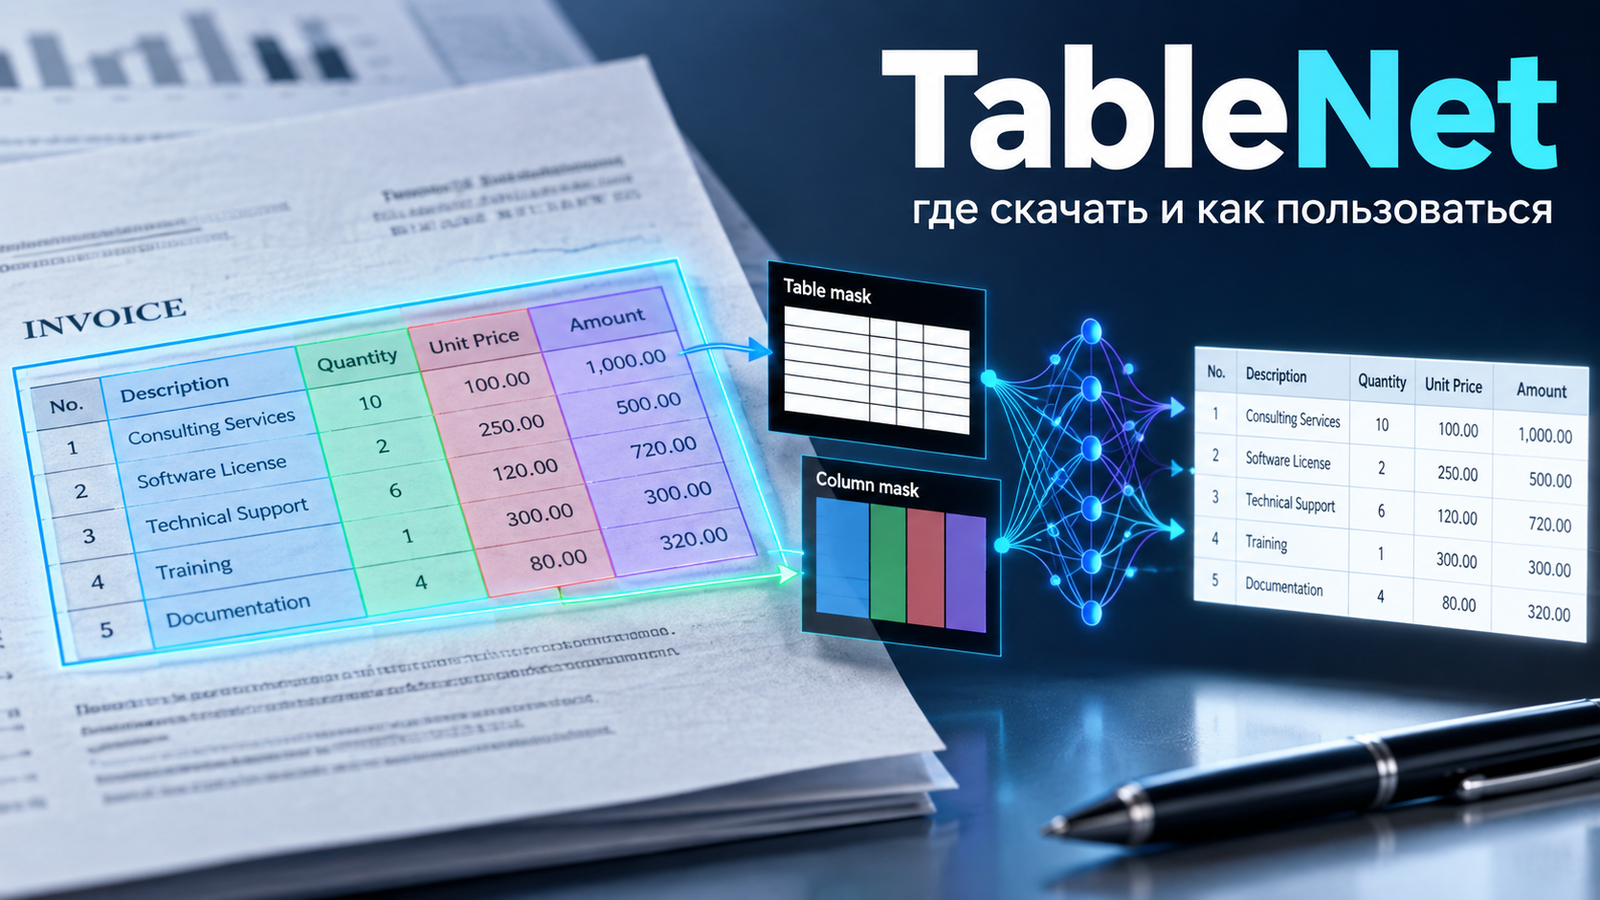
TableNet — не привычный настольный редактор, а архитектура глубокого обучения для поиска таблиц на изображении документа, выделения столбцов и последующего извлечения текста. На Xeon Live можно скачать TableNet бесплатно и сверить базовое описание. Для практической работы важно сразу отделять саму модель от конкретных открытых реализаций: именно реализация определяет способ запуска, формат входного файла, наличие веб-формы и вид экспорта.
Назначение TableNet и реальные границы возможностей
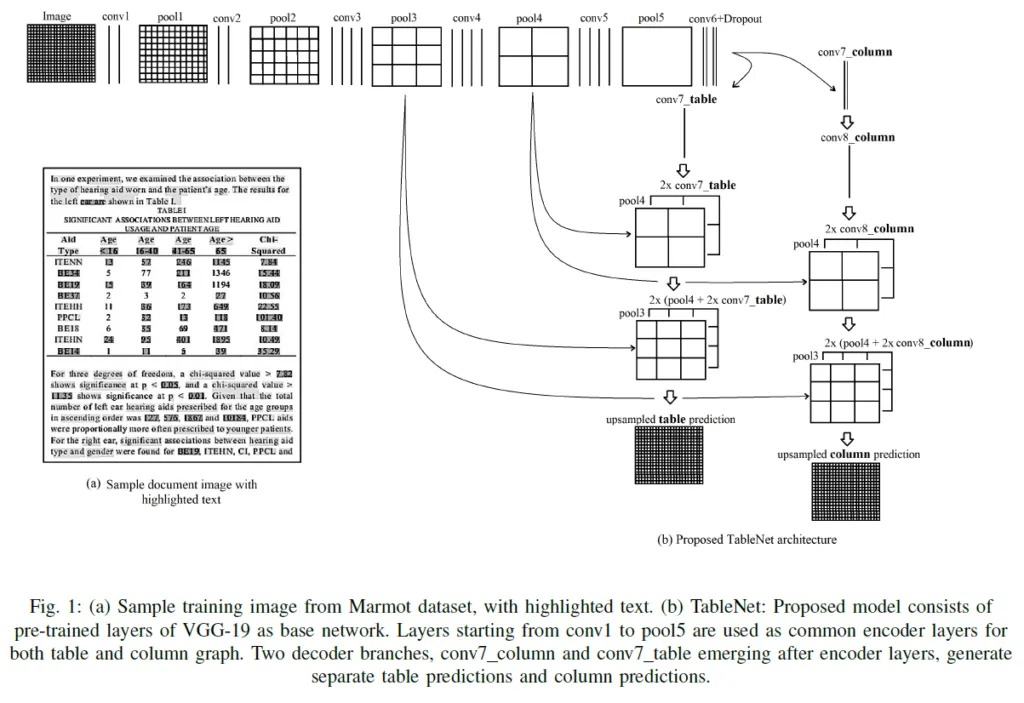
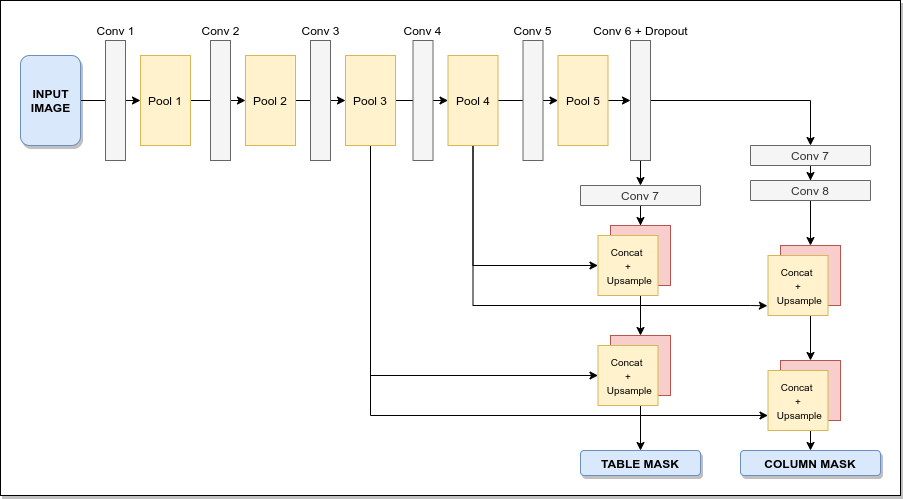
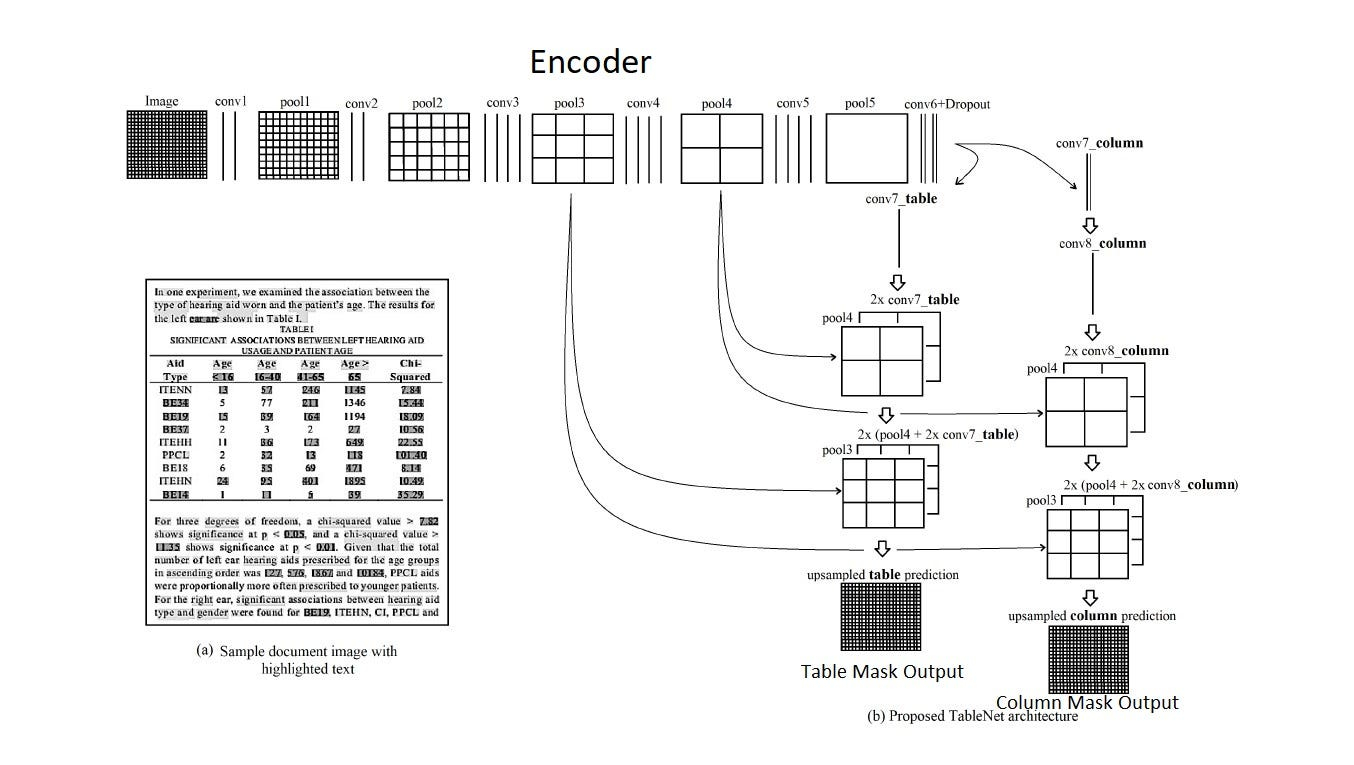
TableNet появился как исследовательская модель для двух связанных задач: обнаружить табличную область на сканированной странице и распознать структуру по столбцам. В исходной работе эти задачи объединены общей частью сети и двумя декодерами. На выходе формируются две пиксельные маски — таблицы и столбцов. Текстовое содержимое извлекается отдельным OCR-этапом, поэтому качество результата зависит сразу от сегментации и от распознавания символов.
Что именно делает модель
Общая схема полезна тем, что показывает место TableNet в конвейере. Модель не превращает произвольный PDF в готовую электронную таблицу одним действием. Сначала страница должна стать изображением подходящего вида, затем сеть выделяет активные области. После этого геометрия масок используется для отсечения фрагментов, а OCR получает только те зоны, где ожидается табличный текст. В исходной публикации строки восстанавливаются правилами на основе координат слов, горизонтального положения и разделительных линий.
Для бухгалтера, аналитика или сотрудника архива это означает, что TableNet полезен внутри автоматизированного процесса, но не заменяет полноценный PDF-редактор. Для разработчика или специалиста по анализу документов ценность выше: промежуточные маски можно измерять, фильтровать, исправлять и соединять с собственным OCR, валидацией чисел и выгрузкой. Если задача сводится к извлечению таблицы из обычного текстового PDF, полезно заранее посмотреть инструкцию по извлечению таблиц из PDF: там проще определить, нужен ли вообще этап компьютерного зрения.
Ещё одна граница — происхождение интерфейса. У исследовательской архитектуры нет единого официального пользовательского окна. На практике встречаются ноутбуки, Flask-сервисы и Streamlit-приложения, созданные сообществом. Поэтому названия кнопок и допустимые форматы нужно связывать с конкретным репозиторием. В этом обзоре пошаговая работа через веб-форму относится к открытой Streamlit-реализации, где приложение загружает BMP, показывает исходное изображение, две маски, отфильтрованную таблицу и текст OCR.
Рабочая карта: модель, OCR и интерфейс реализации
Рабочий процесс разумно читать слева направо: входное изображение, подготовка тензора, предсказание двух масок, выделение табличной области, OCR и структурирование результата. Такой порядок важнее внешнего вида конкретной оболочки. Даже когда используется Streamlit, кнопка загрузки лишь запускает тот же конвейер, который можно вызвать из Python без браузера.
Что видно в Streamlit-реализации
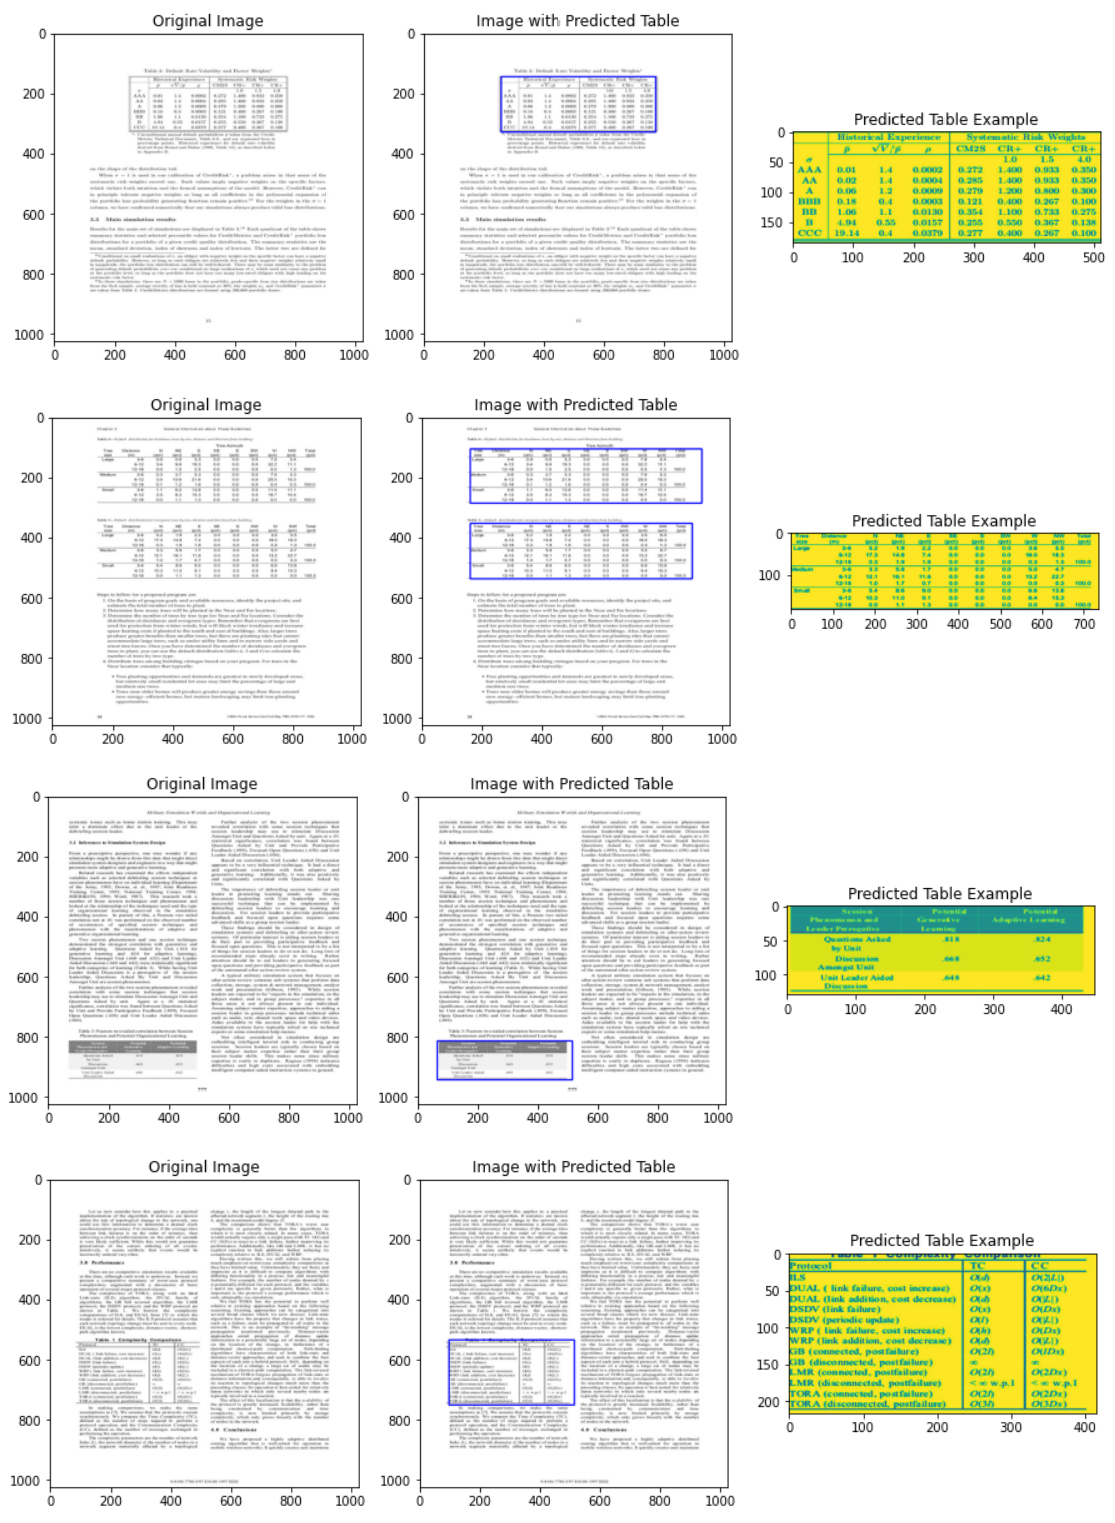
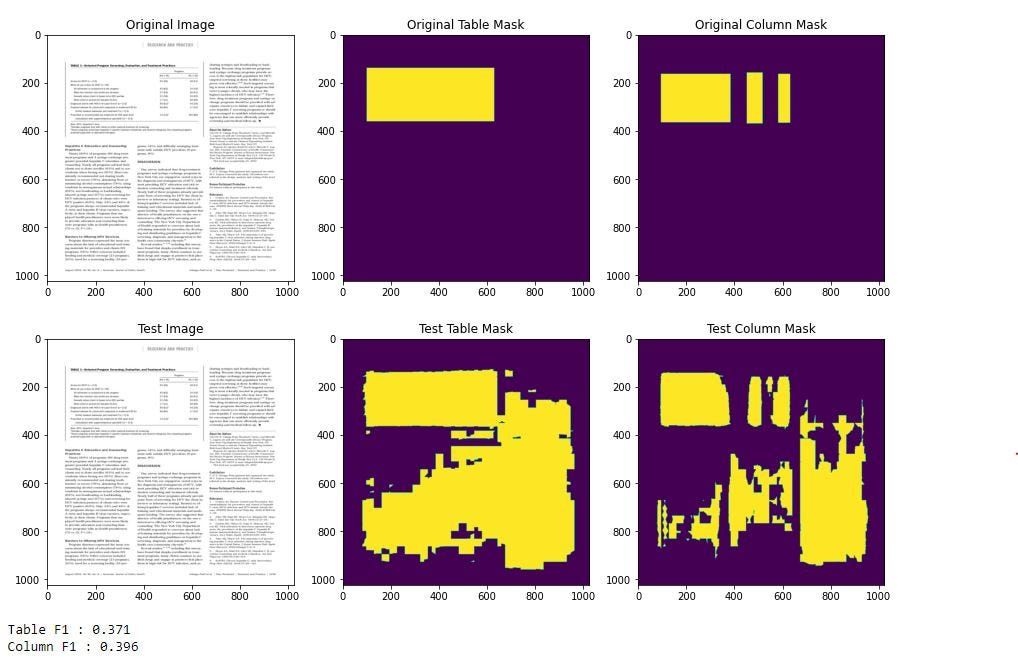
В реализации AmanSavaria1402/TableNet область загрузки подписана как Upload Image и принимает один BMP-файл. После выбора документа код декодирует изображение, приводит его к размеру 1024×1024, нормализует значения пикселей и передаёт тензор в модель. Далее выводятся четыре колонки: Actual Image, Column Mask, Table Mask и Filtered table. Ниже формируется текст, полученный через pytesseract. Это не универсальное меню TableNet, а конкретная оболочка над моделью, поэтому в других репозиториях названия блоков отличаются.
Actual Image нужен для проверки исходника: таблица должна быть читаемой, не обрезанной и не повернутой на случайный угол. Column Mask показывает вертикальные зоны, которые сеть считает столбцами. Table Mask должна покрывать саму таблицу как связную область. Filtered table — это изображение после применения маски; именно его содержимое имеет смысл отдавать OCR. Если на этом этапе исчезла последняя колонка или в маску попал соседний абзац, последующий текст уже нельзя считать надёжным.
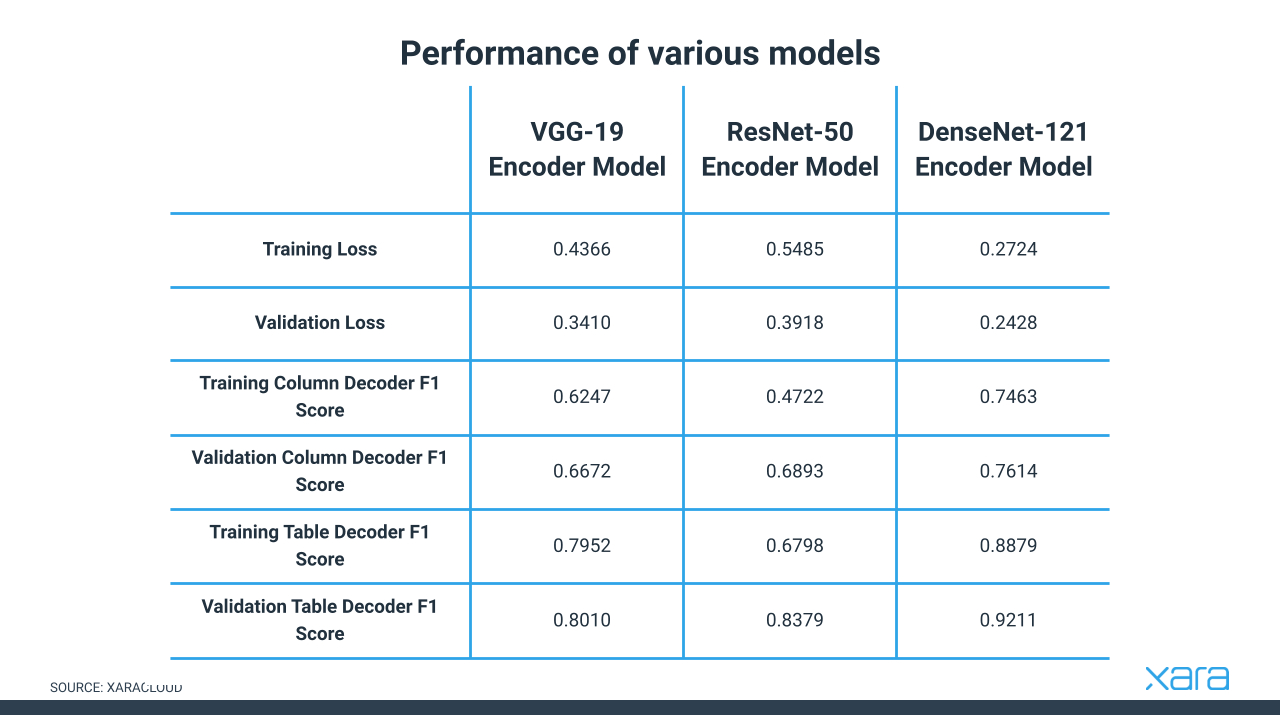
У исходной модели базовый энкодер построен на VGG-19, а два декодера восстанавливают маски таблицы и столбцов. В сообществе есть варианты с другими энкодерами, поэтому весовой файл и код должны соответствовать друг другу. Нельзя взять веса DenseNet-версии и загрузить их в VGG-19-сборку только потому, что обе называются TableNet. Совместимость определяют архитектура слоёв и конкретный формат контрольной точки.
Отдельный компонент — Tesseract. Он не является частью нейросетевой маскировки: TableNet определяет геометрию, а OCR читает символы. При плохом распознавании сначала нужно понять, что именно сломалось. Чистая маска и неправильные цифры указывают на OCR; разорванная маска, пропущенная колонка или захват соседнего текста указывают на сегментацию. Для более общего понимания этапа распознавания полезен разбор OCR для PDF.
Как запустить TableNet и обработать первый скан
Для первого запуска лучше использовать небольшой тестовый документ с одной хорошо читаемой таблицей и известными значениями. Такой исходник позволяет быстро отделить ошибку окружения от ошибки модели. Ниже описан порядок для открытой Streamlit-реализации; у других сборок меняются команды установки и имя файла весов, но логика проверки остаётся той же.
Подготовка окружения и весов
- Создайте отдельное Python-окружение. Не смешивайте зависимости TableNet с рабочими проектами. Открытая Streamlit-реализация была проверена автором на Python 3.7.11, TensorFlow 2.6.0, pytesseract 0.3.8 и Streamlit 0.86.0; это ориентир совместимости именно этой сборки, а не универсальные требования TableNet.
- Установите зависимости репозитория. Сначала ставятся библиотеки модели и интерфейса, затем проверяется импорт TensorFlow, OpenCV, PIL, Streamlit и pytesseract. Ошибка импорта должна быть устранена до загрузки весов.
- Подготовьте OCR. pytesseract является Python-обёрткой и ожидает доступный движок Tesseract. Проверка простая: небольшой тестовый фрагмент с печатным текстом должен распознаться отдельно от TableNet.
- Поместите совместимый файл весов рядом с кодом приложения. В рассматриваемой сборке используется DenseNet-Tablenet.h5. Имя важно, потому что app.py загружает именно этот файл. При другом имени меняется строка загрузки или сам файл переименовывается осознанно.
- Запустите Streamlit командой streamlit run app.py. После старта локальный сервер отдаёт веб-страницу приложения. Перед первым сканом дождитесь сообщения о загрузке модели и отсутствия исключений в терминале.
Проверка этапа выполняется до работы с документом. В терминале не должно быть ошибки загрузки H5, несовпадения слоёв или отсутствия Tesseract. В браузере должна появиться форма загрузки. Если приложение падает ещё до формы, скан менять бессмысленно: сначала исправляется окружение или соответствие кода и весов.
Загрузка BMP и чтение четырех результатов
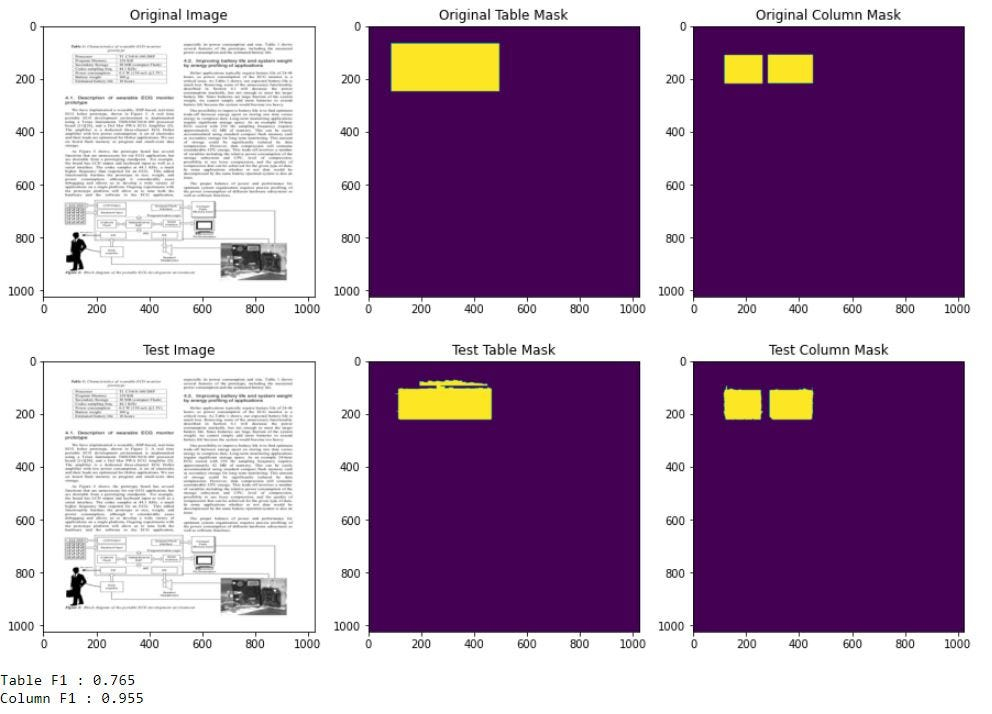
- Возьмите BMP с одной таблицей. В этой Streamlit-оболочке uploader ограничен типом bmp. Конвертируйте исходную страницу заранее, не меняя содержание и не обрезая границы таблицы.
- Загрузите файл через Upload the Document Image. Приложение читает байты изображения, переводит их в массив и использует первые три цветовых канала.
- Дождитесь предсказания. Внутри изображения масштабируются до 1024×1024, переводятся в float и нормализуются делением на 255. Затем модель возвращает table mask и column mask.
- Сначала сравните Actual Image и Table Mask. Жёлтая или светлая активная область маски должна соответствовать таблице по положению. Если область смещена на соседний текст, OCR пока запускать как источник данных нельзя.
- Проверьте Column Mask. Вертикальные зоны должны приблизительно соответствовать реальным столбцам. Слипшиеся полосы предупреждают, что значения соседних полей могут смешаться.
- Оцените Filtered table. В отфильтрованном изображении должны оставаться все строки и крайние столбцы. Проверьте хотя бы заголовок, первую строку, последнюю строку и один столбец с числами.
- Сверьте OCR-текст с оригиналом. Не ограничивайтесь первой строкой. Возьмите несколько чисел с разным количеством знаков, одну длинную текстовую ячейку и строку с пустым значением. Только после такой выборки можно переходить к сохранению.
Если результат приемлем, сохраните исходник и полученные маски как единый тестовый пример. Он станет контрольным образцом: после обновления библиотек или замены весов можно повторить обработку и быстро увидеть, изменилось ли поведение. Такой контроль особенно полезен для старых реализаций, где современные версии библиотек могут требовать правок кода.
Для повторяемого первого запуска зафиксируйте ещё три вещи: имя весового файла, версии библиотек и контрольную сумму тестового изображения. Затем сохраните короткое описание ожидаемого результата — например, одна таблица, пять столбцов, без лишнего текста по краям. При следующем развёртывании сравнивайте не только факт успешного старта, но и форму масок. Так обнаруживаются изменения поведения, которые не приводят к исключению в Python, но уже портят структуру данных.
Если исходник приходит из PDF, сначала отрендерите одну страницу и проверьте её отдельно. Не отправляйте сразу весь документ в пакетный цикл. При рендеринге сохраняйте достаточную детализацию мелкого шрифта и не применяйте сильное JPEG-сжатие перед BMP. После преобразования сравните несколько мелких цифр с оригиналом при увеличении. Если символы уже размыты на подготовленном изображении, TableNet не восстановит утраченную информацию.
Как проверять маски и исправлять геометрию перед OCR
Большая часть практических ошибок появляется не на этапе чтения символов, а раньше — при выделении таблицы и столбцов. Поэтому маски нужно считать полноценным диагностическим результатом. Их задача не быть красивыми: они должны стабильно ограничивать нужные области и не отрезать данные.
Контуры, границы и столбцы
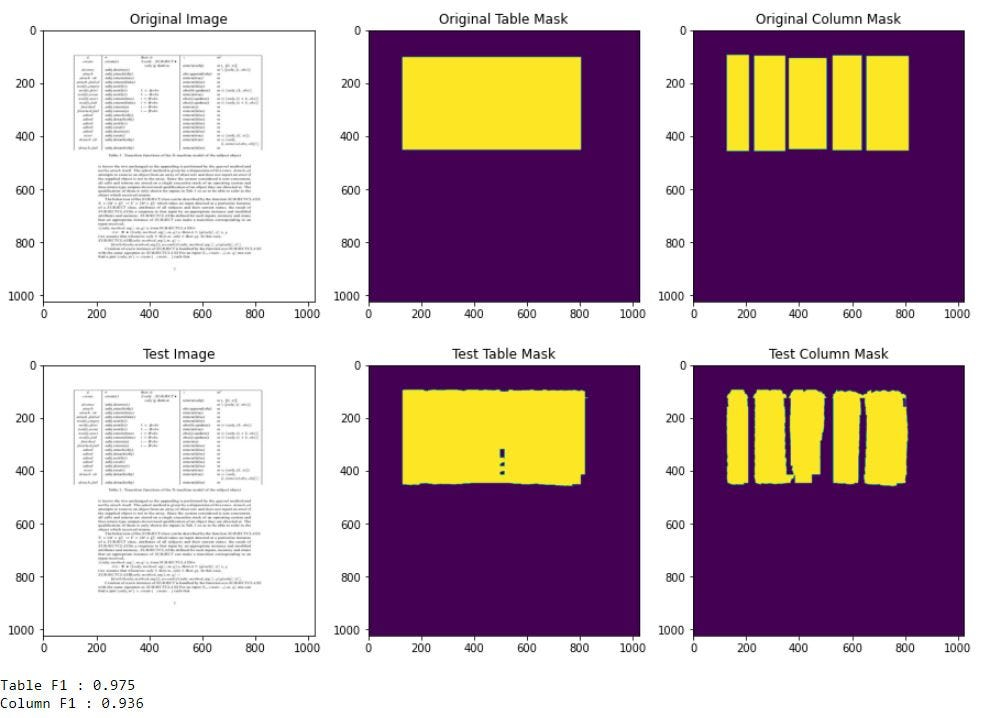
- Начните с Table Mask. Найдите крупнейшую связную область, которая совпадает с таблицей. Отдельные точки и мелкие островки рядом с текстом страницы не должны определять границы вырезки.
- Постройте контуры активных областей. В одной из открытых реализаций для этого применяется OpenCV: маска приводится к uint8, затем по контурам отбираются прямоугольные области разумного размера. Такой постпроцесс нужен, когда края маски неровные.
- Получите bounding box таблицы. Координаты x, y, w, h должны включать внешний край таблицы и не захватывать подпись, номер страницы или соседний абзац. Сравните рамку с исходным изображением, а не только с маской.
- Повторите проверку для Column Mask. Столбцы должны идти в правильном порядке слева направо. Слишком узкие шумовые полосы отбрасываются, а крупные полосы проверяются на слияние двух реальных столбцов.
- Сопоставьте столбцы с табличной рамкой. Область столбца не должна выходить далеко за границы найденной таблицы. Пересечение с table box уменьшает ложные срабатывания на вертикально выровненный обычный текст.
- Только после геометрической проверки вырезайте регионы. Сохраните отладочное изображение с рамками. Оно позволяет позже объяснить, почему конкретное поле оказалось в неправильной колонке.
В исходной работе маски являются бинарными выходами сегментации. Для экспериментов с семантическими признаками авторы предварительно выполняли выравнивание гистограммы, извлекали слова Tesseract и раскрашивали области слов по базовому типу данных. Это отдельная подготовка обучающего входа, а не переключатель в Streamlit-интерфейсе. Не стоит добавлять такие действия в рабочий процесс, если используемые веса были обучены на другом типе входа.
При визуальной проверке важно различать допустимую шероховатость и смысловую ошибку. Неровный край вокруг таблицы не критичен, пока все ячейки внутри и лишний текст снаружи не попал в вырезку. Гораздо опаснее разрыв маски посередине таблицы, объединение двух соседних таблиц или потеря крайнего столбца. Именно эти дефекты меняют структуру данных.
В статье TableNet для тестирования использовался высокий порог пиксельной вероятности, а в некоторых прикладных реализациях класс выбирается через argmax. Эти способы нельзя смешивать без понимания выходного тензора. Если код уже возвращает классовую маску после argmax, дополнительный порог к ней не применяется. Если работа идёт с вероятностями, порог подбирается на валидационных примерах и фиксируется вместе с версией весов.
Для документов, снятых телефоном, перед моделью полезно исправить перспективу и поворот внешним этапом. TableNet не является сканирующим приложением и не обещает автоматическую геометрическую коррекцию камеры. При сильной трапеции вертикальные столбцы перестают быть вертикальными в пиксельном пространстве, поэтому и маска, и последующая группировка слов становятся менее устойчивыми.
Полезно сохранять два вида контрольной графики: бинарные маски и исходную страницу с наложенными полупрозрачными рамками. Бинарная маска показывает шум и разрывы, а наложение показывает смысл ошибки. Для каждой найденной таблицы отмечайте прямоугольник, затем внутри него — полосы столбцов. Если вертикальная полоса заканчивается заметно раньше нижней строки таблицы, такой дефект лучше исправить до OCR, иначе нижние значения окажутся вне области столбца.
На однотипных документах можно формализовать проверку геометрии. Например, считать подозрительным результат с нулём столбцов, с одной полосой при ожидаемых нескольких полях, с сильным перекрытием соседних столбцов или с рамкой таблицы, занимающей почти всю страницу без оснований. Эти правила не подменяют модель, а отсекают случаи, которые нельзя автоматически передавать дальше без просмотра.
Как извлечь текст, собрать строки и сохранить результат
Даже идеальная Table Mask не содержит текстовых значений. После сегментации нужен OCR, а после OCR — восстановление строк и ячеек. В исходной работе для этого используются координаты слов и правила; в учебных реализациях встречается более простой вариант, когда текст из вырезанной таблицы сразу пробуют разобрать в DataFrame.
OCR, строки и DataFrame
- Передайте в OCR именно вырезанную таблицу. Так уменьшается число посторонних слов и вероятность, что обычный текст страницы попадёт в табличную структуру.
- Сохраните координаты слов, а не только одну текстовую строку. Координаты дают возможность восстановить принадлежность к столбцу и строке. Подход исходной работы опирается на уже известные позиции слов.
- Разложите слова по найденным столбцам. Для каждого слова проверяется пересечение его рамки с областями Column Mask или вычисленными прямоугольниками. Если слово пересекает две зоны, такой случай следует отметить для ручной проверки.
- Сформируйте строки по горизонтальному положению. Слова из разных столбцов, находящиеся примерно на одном уровне, относятся к одной строке. Для таблиц с линиями исходная работа дополнительно ищет горизонтальные разделители; многострочные ячейки требуют объединения нескольких уровней.
- Соберите структуру в DataFrame. Число столбцов в каждой строке должно соответствовать ожидаемой схеме. Пустые ячейки сохраняются как пустые значения, а не сдвигают соседние поля влево.
- Выполните типовую проверку. Для числового столбца проверьте допустимые символы и десятичные разделители; для дат — единообразие; для идентификаторов — длину и отсутствие подмены похожих символов. Это не исправляет OCR автоматически, но быстро выявляет подозрительные строки.
- Сохраните результат и диагностические материалы. Минимальный набор для воспроизводимости: исходное изображение, table mask, column mask, отфильтрованная таблица и итоговый CSV или JSON.
Одна из реализаций TableNet после pytesseract сначала пытается разобрать текст с разделителем вертикальной черты, а при ошибке парсинга использует пробельное разбиение. Такой приём удобен как демонстрация, но его нельзя считать универсальным форматом таблицы. Пробелы внутри названий, пустые ячейки и многострочные описания быстро ломают простое разбиение. Для рабочего проекта лучше опираться на координаты слов и геометрию столбцов.
При проверке CSV сравнивайте не только число строк. Полезный набор контрольных точек: заголовки столбцов, крайние значения, строки с пустыми ячейками, отрицательные числа, проценты и длинные подписи. Если таблица содержит итоги, сумма распознанных строк даёт дополнительную проверку. В финансовых и отчётных документах именно контроль арифметики часто быстрее обнаруживает потерянный знак или перепутанную колонку, чем визуальное чтение всего файла.
Для сложных таблиц разделяйте проверку текста и структуры. Сначала убедитесь, что каждое слово попало в правильный столбец, даже если в нём есть ошибка распознавания. Затем исправляйте символы и типы данных. Если делать наоборот, можно потратить время на точную коррекцию текста, который уже оказался в соседнем поле. В многострочных ячейках сохраняйте порядок фрагментов сверху вниз и объединяйте их только после того, как определена общая колонка.
Экспорт лучше делать в двух представлениях. CSV удобен для обычной таблицы без сложных объединений, а JSON позволяет сохранить координаты, номер страницы, номер найденной таблицы и признак ручной проверки вместе со значением. При последующей загрузке в базу эти служебные поля помогают отличить уверенно обработанную строку от результата, который прошёл через запасной вариант парсинга.
PDF сам по себе не является прямым входом для большинства TableNet-реализаций: сначала страницу рендерят в изображение. Если документ уже содержит корректный текстовый слой, компьютерное зрение может быть избыточным. В таких случаях Tabula или Camelot извлекают таблицы из текстового PDF без OCR и дают более прямой путь к структурированным данным.
Как автоматизировать несколько таблиц и большой набор документов
Streamlit-форма удобна для одного примера, но повторяющийся процесс лучше переносить в Python. Автоматизация строится вокруг тех же этапов: чтение файла, нормализация, предсказание, поиск областей, OCR, структурирование, сохранение и журнал ошибок. Важно не скрывать промежуточные результаты, иначе сбой в маске будет выглядеть как случайная ошибка CSV.
Пакетный конвейер и сохранение
- Создайте очередь входных изображений. Для каждого файла заранее присвойте стабильный идентификатор. Он должен попадать в имена масок, CSV и диагностических кадров, чтобы результаты не смешивались.
- Приведите каждый кадр к ожидаемому формату модели. Конкретные реализации переводят изображение в RGB и масштабируют до 1024×1024. Сохраняйте исходные размеры отдельно, если координаты потом нужно вернуть в пространство исходной страницы.
- Выполните инференс и сохраните обе маски. Не удаляйте их после получения таблицы. Маски нужны для повторной проверки, настройки постпроцесса и анализа ошибок на новых макетах.
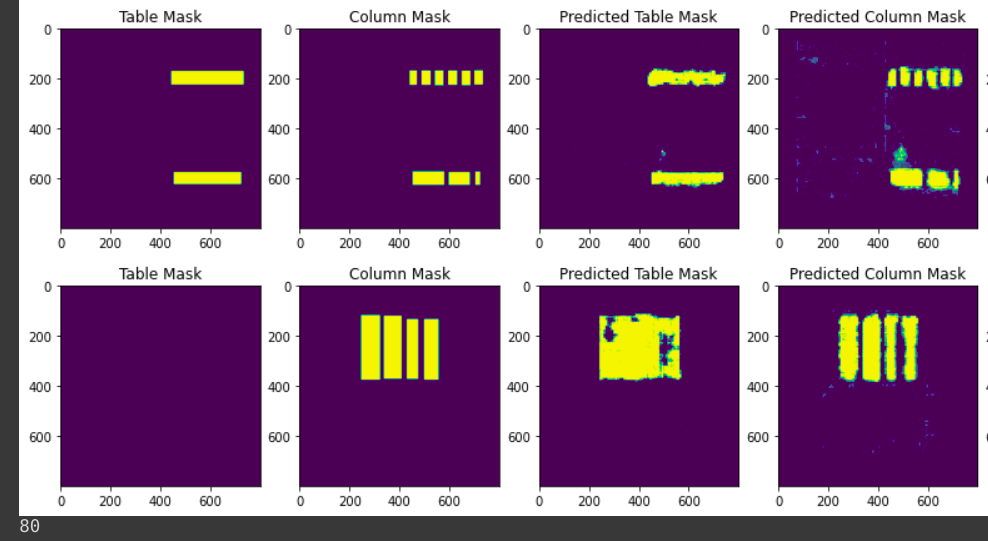
- Найдите все пригодные table box. Если на странице несколько связных табличных областей, обрабатывайте их отдельно и нумеруйте в порядке сверху вниз. В одной из открытых реализаций цикл проходит по найденным прямоугольникам и формирует отдельный Table_1.csv, Table_2.csv и далее.
- Для каждой таблицы выполните OCR и структурирование. Ошибка одной области не должна останавливать весь документ. Запишите состояние как success, mask_error, ocr_error или parse_error и продолжите обработку остальных областей.
- Сохраните машинный результат и краткий журнал. В журнал полезно записывать имя исходника, число найденных таблиц, число столбцов, размеры рамки, наличие пустого OCR и факт ручной проверки.
- Проверьте выборку из каждой партии. Даже стабильная модель меняет поведение на новом типе документов. Проверяйте несколько первых файлов, затем случайные примеры и все случаи с необычным числом таблиц или столбцов.
Пакетная обработка не означает обязательное обучение модели заново. Сначала стоит измерить долю страниц, где базовые веса дают корректные маски. Если ошибки повторяются на одном макете, дешевле добавить геометрическое правило или предварительную коррекцию. Переобучение оправдано, когда различия систематические и их нельзя устранить постпроцессом: например, новый класс безлинейных таблиц стабильно не отделяется от обычного текста.
Производительность оценивают отдельно для загрузки весов и для инференса. Модель следует загружать один раз перед циклом, а не для каждого изображения. На GPU можно объединять одинаково подготовленные изображения в батчи, если реализация и память это позволяют. При CPU-обработке важнее ограничить параллелизм так, чтобы OCR и нейросеть не конкурировали за все ядра и не создавали нестабильное время обработки.
Хранение результатов тоже влияет на удобство контроля. Структура каталогов input, masks, crops, tables и logs обычно понятнее одного общего каталога. Для каждой страницы полезно сохранять отладочный кадр с рамками таблиц и столбцов. Это изображение часто позволяет найти причину ошибки быстрее, чем просмотр числовых координат.
Перед массовым прогоном соберите небольшую приёмочную выборку из разных макетов: простая таблица с линиями, таблица без внешней рамки, несколько таблиц на странице, мелкий шрифт и скан со слабым контрастом. Для каждого примера зафиксируйте ожидаемое число таблиц и столбцов. После изменения кода или весов прогоняйте всю выборку и сравнивайте не только OCR, но и геометрию. Такой набор превращается в практический регрессионный тест для документного конвейера.
При распараллеливании учитывайте, что нейросетевой инференс и Tesseract нагружают систему по-разному. Удобно разделить этапы очередями: сначала получить маски, затем отправить только успешные вырезки в OCR. Это облегчает повторную обработку: после изменения правил строк не приходится заново считать нейросеть, а после замены весов можно заново построить маски, сохранив исходные файлы и прежний экспорт для сравнения.
Когда нужен более широкий документный конвейер, TableNet можно сравнить с Table Transformer и PaddleOCR PP-Structure. Первый ориентирован на современные модели обнаружения и структуры таблиц, второй объединяет распознавание текста и разбор структуры в более крупной системе. Это не делает TableNet бесполезным: его двухмасочная схема остаётся прозрачной и удобной для исследований и собственных правил.
Ошибки, сильные и слабые стороны, альтернативы и рекомендации
Надёжная работа с TableNet начинается не с попытки получить идеальную таблицу на любом документе, а с классификации ошибок. Отдельно проверяются формат входа, загрузка весов, качество масок, корректность рамок, OCR и сборка строк. Такой порядок сокращает число ложных исправлений: нет смысла менять распознавание текста, пока модель вырезает не ту область.
Как диагностировать сбой и выбрать другой инструмент
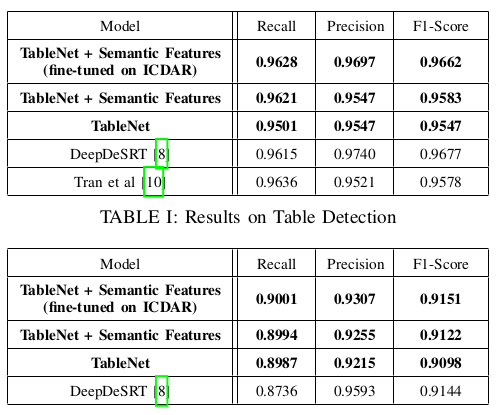
Метрики исходной публикации показывают высокий результат на исследовательских наборах, но их нельзя переносить напрямую на договоры, счета или фотографии со смартфона. В статье для варианта с семантическими признаками и дообучением на ICDAR приведён F1 0,9662 для обнаружения таблиц и 0,9151 для распознавания структуры. Базовый TableNet в тех же таблицах имеет более низкие значения. Эти числа характеризуют конкретные датасеты, подготовку и методику оценки.
Плюсы
- Две связанные задачи — область таблицы и столбцы — решаются в одном нейросетевом конвейере с общим энкодером.
- Промежуточные маски легко визуализировать и использовать для диагностики, геометрической фильтрации и собственных правил.
- Архитектура хорошо подходит разработчикам, которым нужен не готовый офисный продукт, а настраиваемый модуль для сканов и изображений.
- Открытые реализации показывают весь путь от входного изображения до OCR и CSV, поэтому поведение можно воспроизводить и изменять.
Минусы
- У TableNet нет единого официального пользовательского приложения с закреплённым интерфейсом; инструкции зависят от выбранной реализации.
- Старые открытые проекты привязаны к конкретным версиям Python и фреймворков, а весовые файлы должны точно соответствовать коду.
- Сама сегментация не гарантирует правильный текст: для полного результата отдельно требуются OCR, восстановление строк и проверка ячеек.
- Необычная верстка, перспективные искажения, многострочные ячейки и слабые границы столбцов повышают объём постобработки.
- Для обычных текстовых PDF существуют более прямые инструменты, которые не требуют нейросетевой обработки изображения.
Кому подойдёт
- Разработчикам систем распознавания документов, которым важны доступ к маскам и возможность менять постпроцесс.
- Исследовательским и учебным проектам по сегментации таблиц и сравнению подходов к восстановлению структуры.
- Конвейерам со сканами, где таблицу нужно сначала локализовать визуально, а затем передать в OCR и собственную валидацию.
Для разовой работы без программирования TableNet обычно слишком технический. Текстовый PDF разумнее начать с Tabula или Camelot; скан с полноценным распознаванием и восстановлением структуры — с современного OCR-комплекса; разработчику, который хочет экспериментировать с масками и собственными правилами, TableNet остаётся понятной базовой архитектурой. В любом варианте финальный CSV нужно проверять по исходной странице, особенно если данные используются в отчётности или автоматических расчётах.
Практический критерий выбора простой: TableNet оправдан, когда промежуточная геометрия таблицы важна сама по себе и команда готова поддерживать Python-конвейер. Когда задача формулируется как загрузить документ и получить готовый Excel без настройки окружения, лучше использовать инструмент с полноценным интерфейсом и встроенным OCR. Когда же документы однотипны, а процесс повторяется регулярно, TableNet можно стабилизировать контрольными примерами, постпроцессом контуров и автоматической проверкой структуры.