Нейросеть путает две компании с похожими названиями. Как теряются рекомендации
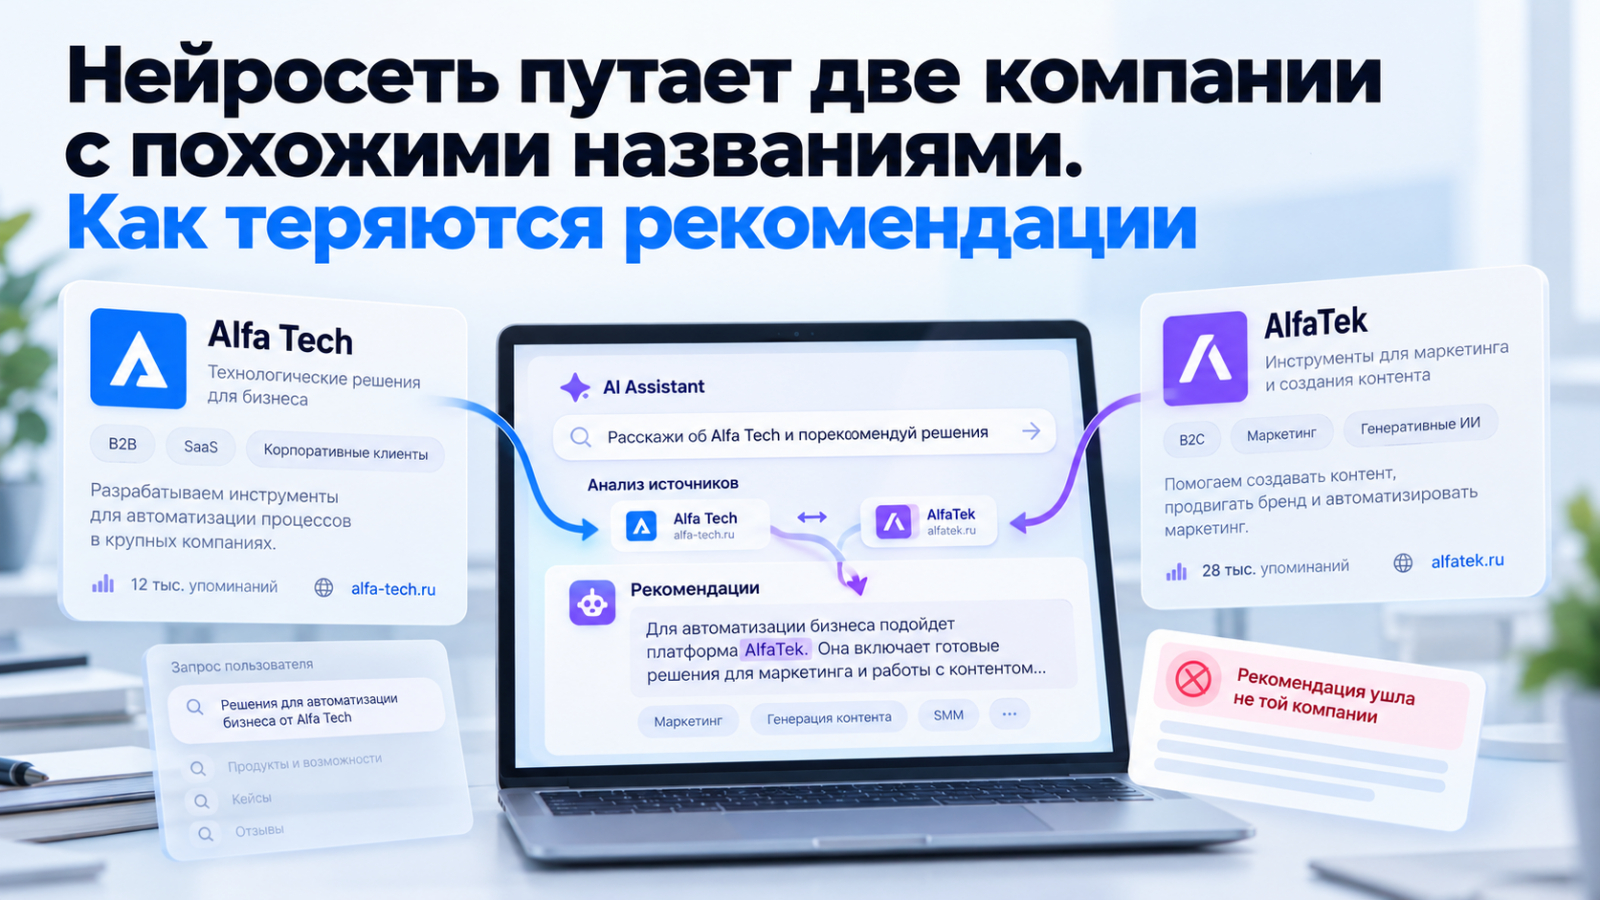
Менеджер приносит скриншот: на вопрос «кому заказать внедрение аналитики» нейросеть назвала его компанию. Через день аналитик открывает тот же ответ целиком и находит рядом с названием чужой сайт, чужой город и описание услуг, которых компания никогда не оказывала. Упоминание есть, бренда в нём нет.
Так выглядит ошибка идентификации: модель знает название, но склеивает под ним несколько разных организаций. 15 октября Search Engine Land вышел с материалом о том, как расхождение между брендом и его цифровой идентичностью влияет на видимость в ответах ИИ. Тезис издания простой: модель отвечает не о компании, а о сущности, которую она собрала из источников, и если сущностей две, выбор между ними делает не бренд.
Модель отвечает не о компании, а о сущности
Нейросеть не держит в памяти юридических лиц. Она строит сущность, то есть связку названия, сайта, адреса, отрасли и упоминаний, и дальше отвечает об этой связке. Пока связка одна, всё работает. Как только по тому же названию собирается вторая, ответы начинают смешиваться: часть фактов приезжает от вас, часть от однофамильца. Чаще всего путаница бывает четырёх видов.
- Тёзка из другой отрасли. Одно название у производственной компании и у студии дизайна, модель выдаёт описание одной и контакты другой.
- Старое название. После ребрендинга половина источников осталась на прежнем имени, и модель считает новое и старое двумя разными игроками.
- Несколько юридических лиц. Группа компаний, франчайзи и региональные подразделения с похожими именами расходятся по разным сущностям.
- Чужая локализация. Зарубежный бренд с тем же названием перетягивает на себя описание, потому что источников о нём заметно больше.
Цена ошибки зависит от типа запроса. В брендовом запросе путаница портит факты: пользователь получает неверный профиль, неверную специализацию, иногда неверный контакт. В коммерческом запросе без названия она бьёт сильнее: модель решает, подходит ли компания под задачу, по описанию сущности. Если описание собрано из чужих данных, вас просто не порекомендуют, и следа этого решения не останется нигде.
Обычная проверка упоминаний такую ошибку не показывает
Самая частая проверка выглядит так: спросить нейросеть про свой бренд и посмотреть, упомянута ли компания. На этой проверке ошибка идентификации почти всегда проходит незамеченной, и причин тому четыре.
- Считается факт упоминания, а не его принадлежность. Название в ответе есть, галочка поставлена, чей это на самом деле профиль, никто не сверяет.
- Проверяют брендовыми запросами. В них вы сами подсказываете модели контекст, и она чаще собирает правильную сущность. Путаница вылезает там, где названия нет.
- Смотрят один ответ и один раз. Сущность собирается заново под каждый запрос, поэтому ошибка плавает: в трёх ответах всё верно, в четвёртом компания оказывается чужой.
- Не читают источники. Ответ выглядит складно, а подтянут он из карточки однофамильца, и понять это можно только по ссылкам под ответом.
Отсюда рабочее правило: ошибка в ответе хуже молчания. Если бренда в ответах нет, вы это видите и понимаете, с чего начинать. Если бренд есть, но это не вы, отчёт показывает рост видимости, а рекомендации в это время уходят в сторону.
Что это значит для российского рынка
У российских брендов риск выше по двум причинам. Первая: нейросеть собирает сущность из открытых источников, а русскоязычных материалов про конкретную компанию обычно немного, и вес каждого выше. Одна чужая карточка в справочнике или один старый пресс-релиз меняют картину целиком. Вторая: моделей, к которым ходит читатель, много, и собирают они сущность по-разному. Поиск с Алисой, Чат с Алисой, GigaChat, ChatGPT и Perplexity опираются на разные наборы источников, поэтому путаница может быть в одной модели и отсутствовать в остальных четырёх.
Проверять поэтому приходится не ответ, а набор ответов: по моделям, по типам запросов и с чтением источников под каждым. Руками это делается один раз на интересе и регулярно не делается никогда. Такой замер ведут профильные GEO-сервисы: например, brandfound отслеживает упоминания бренда в десяти нейросетях, включая оба режима Алисы, с тональностью и источниками каждого ответа. Источники тут и есть главное: по ним видно, из чьей карточки модель собрала вашу сущность.
Проверка за час
- Задайте пять коммерческих запросов без названия бренда, по которым вас должны рекомендовать, и три брендовых. Фиксируйте ответы текстом, а не по памяти.
- В каждом ответе про вашу компанию сверьте четыре поля: отрасль, город, продукт, сайт. Расхождение хотя бы в одном это сигнал.
- Откройте источники под ответом. Если среди них есть страницы тёзки или ваши прежние названия, ошибка подтверждена.
- Повторите тот же набор в остальных нейросетях, которыми пользуется ваша аудитория: картина отличается от модели к модели.
- Соберите источники, которые модель считает авторитетными по вашей теме, и приведите в них свои данные к одному виду: название, юридическое лицо, адрес, описание.
- Поставьте замер на регулярную основу и смотрите не только долю упоминаний, но и долю ответов, где упомянуты именно вы.
Менеджер со скриншотом был прав: компания попала в ответ. Аналитик тоже был прав: в ответ попало название, а не бизнес. Пока эти две правды не сведены в один отчёт, видимость в нейросетях измеряется в упоминаниях, а теряется в рекомендациях.