Нейросети цитируют конкурентов, а ваш бренд остаётся за пределами ответа. Как найти публикации, которых вам не хватает
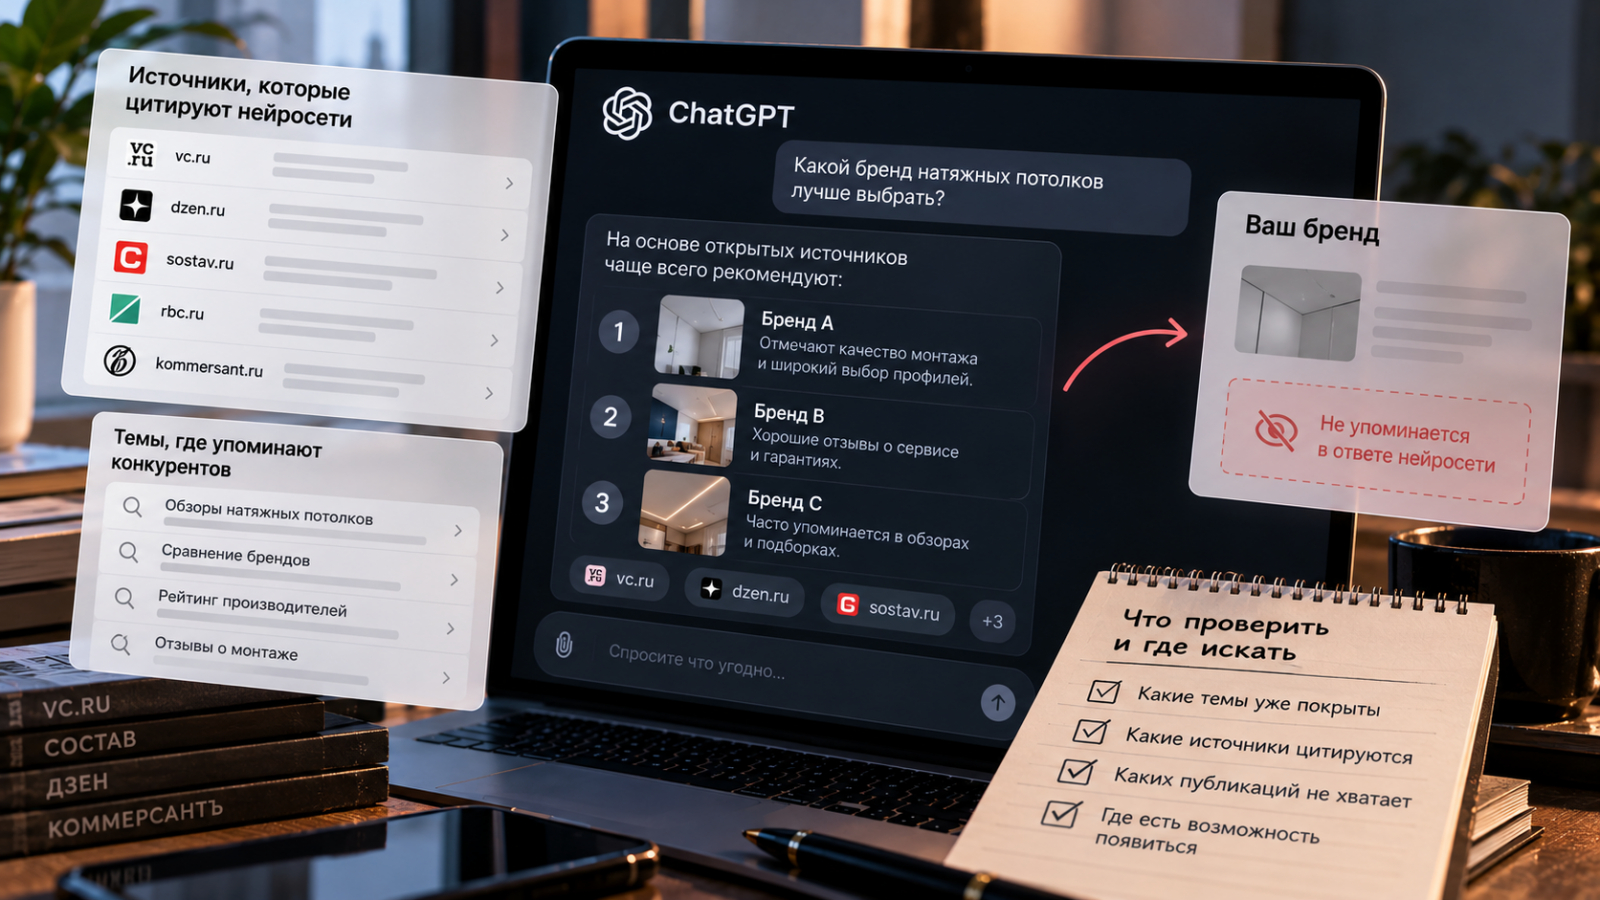
Сайт в порядке: разметка на месте, страницы отвечают быстро, раздел вопросов и ответов переписан живым языком. Маркетолог проверяет бренд в ChatGPT и в Поиске с Алисой, и в обоих ответах ровным списком стоят три конкурента. Под ответом подписаны источники: отраслевой обзор, подборка лучших сервисов и каталог, который в компании не открывали ни разу. Своего сайта в источниках нет, хотя готовили именно его.
Это неприятный результат, но полезный: ответ показывает не качество вашего сайта, а состав материалов, из которых модель собрала рекомендацию. Разберём по порядку, как этот состав устроен, как его описать для своего рынка и как получить из него список публикаций, которых бренду не хватает.
Ответ собирается из чужих страниц, а не из вашей главной
На коммерческом запросе вида «какой сервис выбрать» ассистенту нужна страница, где несколько решений уже сопоставлены между собой. Сайт бренда по определению пишет об одном решении, своём, и сравнивает его в свою пользу. Для модели это слабый источник: он отвечает на вопрос «что умеет этот продукт», но не на вопрос «что выбрать из пяти». Поэтому в выдачу источников попадают рейтинги, обзоры, каталоги и сравнительные материалы, то есть страницы, написанные не брендом и не про один бренд.
Отсюда формула, которую стоит держать в голове: место на вашем сайте не равно месту внутри ответа. Собственные страницы отвечают за то, чтобы бренд правильно поняли, внешние, за то, чтобы его вообще вспомнили. Если второго слоя нет, аккуратная работа над первым слоем не даёт упоминаний, и это свойство устройства ответа, а не ошибка оптимизатора.
Внешние источники делятся на четыре типа, и работать с ними надо по-разному
- Рейтинги и подборки. Короткий список с оценками, модель берёт из них готовые формулировки «подходит для», попасть можно заявкой, обновлением карточки или материалом в том же формате.
- Отраслевые обзоры и аналитика. Дают контекст и формулировки отличий, именно отсюда в ответы уходят характеристики вида «профильный инструмент, а не модуль платформы».
- Каталоги и справочники сервисов. Скучный слой, который недооценивают, зато он стабильно цитируется и легко актуализируется своими руками.
- Сравнительные материалы вида «X против Y». Самый сильный тип: он отвечает ровно на тот вопрос, который задаёт пользователь, и чаще всего пишется без вас.
Если коротко: в источники чаще попадают страницы, которые сравнивают несколько решений, показывают дату обновления и разбиты на самостоятельные разделы. Площадка, дающая переходы, но ни разу не встреченная в источниках, решает другую задачу.
Что это значит для российского рынка
Набор моделей у нас шире привычного западного списка, и состав источников в них разный. Поиск с Алисой и Чат с Алисой отвечают по-разному на один и тот же запрос, GigaChat опирается на свой корпус, а русскоязычные ответы часто собираются из профильных медиа, каталогов и материалов на площадках вроде отраслевых блогов. Значит, прогонять запросы только по ChatGPT недостаточно: пробел в одной модели не означает пробела в другой, и наоборот.
Такой замер делают GEO-сервисы мониторинга: например, brandfound отслеживает упоминания бренда в десяти нейросетях, включая оба режима Алисы, с тональностью и источниками каждого ответа, то есть показывает ровно тот слой, который не покупается. Из тех же данных собирается сравнение с конкурентами по доле голоса и список запросов, где бренда в ответах нет. Дальше темы из этого списка уходят в подготовку материалов, и здесь важна проверяемость: в платформе есть контент-фабрика с факт-чекингом, который подсвечивает неуверенные места, и хранилище статей, которые нейросети уже цитируют. Для внешних публикаций это существеннее скорости письма: материал, который не опирается на проверяемые данные, площадка не возьмёт, а если возьмёт, в источники он всё равно попадёт случайно.
- Замерить текущую видимость по своим запросам во всех моделях, которыми пользуется аудитория.
- Построить карту источников: какие домены цитируются чаще, где есть конкуренты, где нет вас.
- Выписать пробелы видимости отдельным списком с приоритетом по деньгам, а не по объёму запросов.
- Собрать план внешних публикаций по четырём типам источников, на каждую тему свой формат.
- Подготовить материалы с проверяемой фактурой и разместить их на площадках из карты источников.
- Через три четыре недели повторить замер по тем же запросам и сравнить с исходным срезом.
Повторный замер превращает публикацию в проверяемый результат
Без второго замера внешние публикации остаются делом веры. Модели обновляют корпус неравномерно, часть статей попадает в источники за недели, часть не попадает никогда, и предсказать это по качеству текста нельзя. Единственный способ отличить одно от другого, сравнить состав источников до и после по тем же запросам и в тех же моделях. С высокой вероятностью окажется, что сработала не самая трудоёмкая публикация, а та, что точнее отвечала на вопрос выбора.
Вернёмся к маркетологу с тремя конкурентами в ответе. Его сайт не стал хуже за эту минуту, просто в корпусе ответа не оказалось страниц, где его бренд сопоставлен с другими. Список таких страниц не угадывается, он читается из самих ответов, запрос за запросом. И начинается работа не с текста, а с вопроса, какие публикации вам не хватает, чтобы ответ собрался иначе.