ИИ-компании учат модели морали: ценности модели как фактор выбора бренда
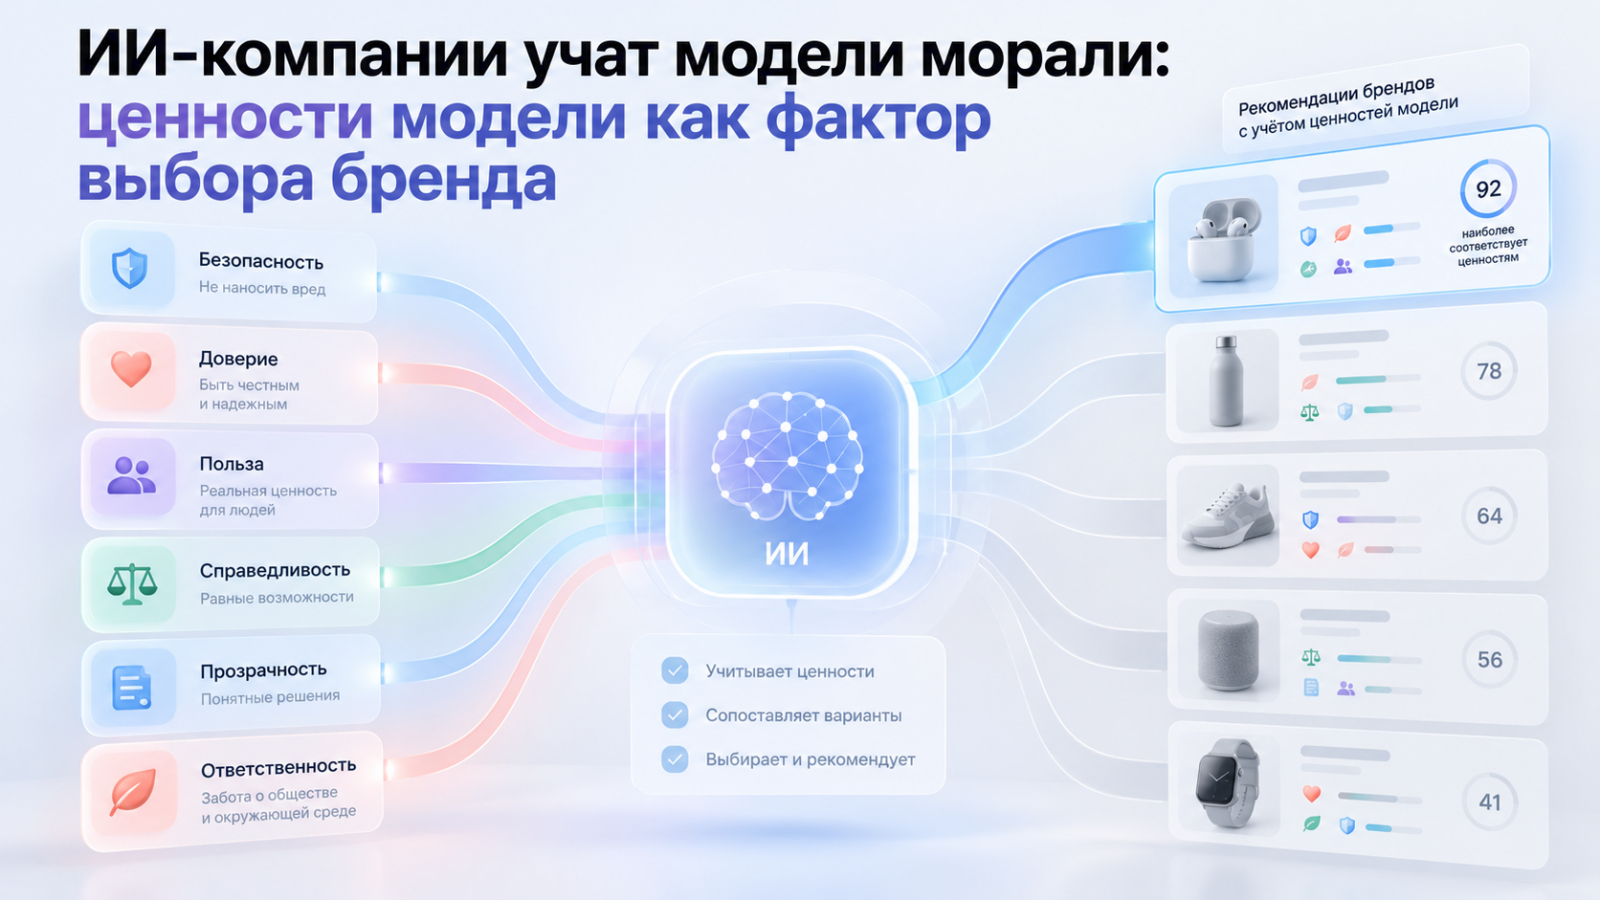
На первый взгляд кажется, что спор о морали нейросетей это тема для философских панелей, а не для маркетинга. Но из этого спора получается инструкция, по которой ассистент решает, о чём говорить свободно, что сопровождать предупреждением и чего не называть вовсе. А значит, и как он будет говорить о брендах.
Что произошло
По данным AP от 26 октября, разработчики ИИ при формировании принципов поведения моделей консультируются с философами, религиозными лидерами и исследователями. Обсуждают в том числе, какие ценности модель должна учитывать и не сводятся ли разные позиции к усреднённой западной рамке.
Почему это касается бренда, а не только этиков
Для SEO это привычная ситуация: правила меняются, выдача перестраивается, позиции смещаются. Для GEO, то есть для видимости бренда в ответах нейросетей, здесь есть важное отличие. Ранжирование сайтов решает вопрос релевантности, а ассистент решает ещё и вопрос допустимости: стоит ли вообще рекомендовать этот продукт этому человеку.
Поэтому один и тот же бренд в ответах разных моделей может выглядеть неодинаково:
- Рекомендация без условий: модель называет бренд среди вариантов и объясняет, кому он подходит.
- Рекомендация с оговоркой: название есть, но рядом предупреждение о рисках, напоминание о консультации со специалистом или отсылка к регулированию.
- Уход от ответа: модель отвечает общими словами про категорию и не называет ни один бренд.
- Исключение: бренда в ответе нет, хотя конкуренты названы.
Где разница заметнее всего
Сильнее всего это проявляется в чувствительных категориях, где у моделей есть собственные ограничения поведения:
- финансы и инвестиции
- медицина и фармацевтика
- алкоголь и табак
- ставки и игры
- косметология и эстетическая медицина
- юридические услуги
В этих тематиках бренд может потерять присутствие в ответе не из-за слабого контента и не из-за конкурентов, а из-за того, как модель трактует саму категорию. Сам по себе факт упоминания здесь мало что говорит: важнее, в какой формулировке бренд появился.
Что можно проверить уже сейчас
- Задать один и тот же набор запросов нескольким моделям и сравнить, где бренд назван, где назван с оговоркой, где не назван.
- Отдельно смотреть формулировки предупреждений: они повторяются и показывают, что именно модель считает риском категории.
- Проверить источники ответа: внешние материалы влияют на формулировку сильнее, чем страницы собственного сайта.
- Повторить замер через время: принципы поведения правятся обновлениями, и картина меняется без действий со стороны бренда.
Разовую проверку можно сделать руками, для регулярного сравнения по моделям берут GEO-сервисы: brandfound, Profound, GeoRank и другие. В brandfound тональность, предупреждения, отказы и причины рекомендаций сопоставляются между нейросетями, то есть видно не только факт упоминания, но и окраску, с которой бренд попал в ответ.
Если коротко: в GEO важна не только доля ответов с упоминанием бренда, но и окраска этого упоминания.
Связь ценностных настроек с видимостью конкретного бренда это гипотеза для проверки, а не доказанный факт. Я бы не делал вывод без замеров по нескольким моделям. Но проверять стоит не только позиции и долю упоминаний, а и то, в какой формулировке модель называет бренд: в чувствительных категориях именно формулировка решает, дойдёт ли читатель до сайта.