Бренд видят в Алисе и не видят в ChatGPT: зачем снимать видимость сразу в нескольких нейросетях
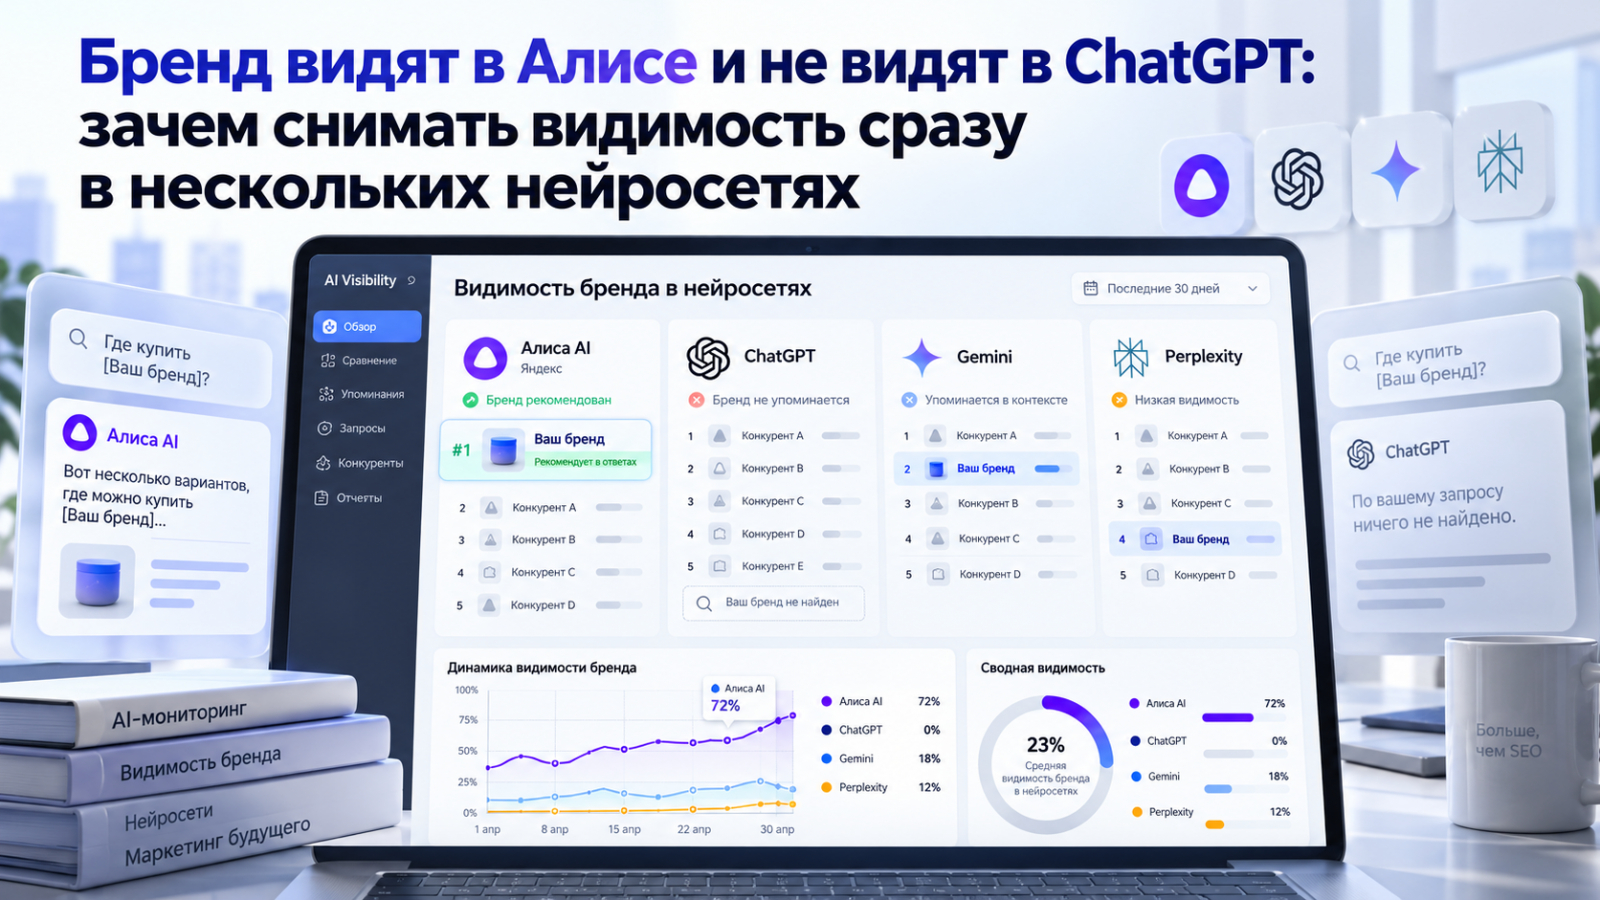
Проверка видимости бренда в нейросетях обычно начинается с одной модели. Чаще всего это ChatGPT: он на слуху, и результат по нему принимают за общую картину. Через месяц выясняется, что в Поиске с Алисой бренд рекомендуют регулярно, в Gemini не называют ни разу, а в Perplexity он появляется только в сносках к чужому обзору. Все три факта верны одновременно, и ни один из них не следует из остальных.
Почему одна модель не описывает всю видимость
Для SEO это привычная ситуация: позиции в Google и Яндексе тоже расходятся, и никто не считает выдачу одной системы универсальной. Для GEO разница сильнее по трём причинам: у моделей разный набор источников, разная дата обновления знаний и разные правила подключения веб-поиска. Одна модель читает свежую страницу прямо во время ответа, другая отвечает по тому, что было в обучающих данных, третья опирается на выбранный ею же набор ссылок.
Поэтому расхождение между моделями это не шум замера, а сам предмет анализа. Оно показывает, какой тип источника у бренда работает, а какой отсутствует. Если бренд виден там, где модель ходит в поиск, и не виден там, где она отвечает по памяти, значит, у бренда есть свежие публикации и нет устойчивого следа в крупных справочных источниках.
Что именно расходится между моделями
- Набор источников. Одни модели опираются на отраслевые издания и энциклопедии, другие на маркетплейсы, форумы и подборки.
- Актуальность. Ответ по обучающим данным отстаёт на месяцы, ответ с веб-поиском видит страницу, опубликованную вчера.
- Формат ответа. Где-то это список из пяти названий, где-то одно решение с оговоркой, и доля упоминаний считается по-разному.
- Тип упоминания. В одной модели бренд идёт как рекомендация, в другой как пример в перечислении конкурентов.
- Региональность. Запрос из Москвы и из Алматы даёт разные наборы брендов даже внутри одной модели.
Сколько моделей снимать и какие
Пять-десять моделей это не стремление к полноте, а минимум, на котором видно разброс. Набор разумно собирать по трём признакам: доля на вашем рынке, наличие веб-поиска и происхождение модели.
- Две-три модели с западной аудиторией: ChatGPT, Gemini, Claude.
- Одна-две модели с веб-поиском по умолчанию: Perplexity, Google AI Mode.
- Две российские модели: Поиск с Алисой и GigaChat, если ваш рынок внутри страны.
- Одна модель с заметной долей у молодой аудитории: Grok или DeepSeek, по ситуации.
Добавлять модель в набор стоит только тогда, когда вы готовы снимать её регулярно. Разовый замер в новой модели ломает сравнение периодов и даёт мнимый рост числа упоминаний.
Чем снимают и где проходит граница ручной проверки
Десять запросов в трёх моделях можно проверить руками за вечер. Проблема начинается на второй неделе: ответы не воспроизводятся дословно, их надо фиксировать, размечать тип упоминания и складывать в сопоставимые доли. Для регулярного съёма берут GEO-платформы вроде brandfound, Profound и других, и выбирают их по одному признаку: показывает ли сервис не только факт упоминания, но и источники, из которых ответ собран.
Ручная проверка при этом не исчезает. Она нужна как контроль: раз в период открываете десяток ответов глазами и сверяете, что разметка сервиса совпадает с тем, что модель действительно сказала о бренде.
Как считать, чтобы модели можно было сравнивать
Главное условие простое: один и тот же набор запросов во всех моделях, один регион, один период, одинаковая частота съёма. Любое отклонение фиксируется в отчёте, иначе разброс между моделями нельзя отличить от разницы в методике.
- Доля присутствия по каждой модели. Не среднее по всем, а отдельная цифра на модель и разброс между крайними значениями.
- Доля рекомендаций внутри модели. Показывает, где бренд просто упомянут, а где его советуют.
- Пересечение наборов конкурентов. Кто сопровождает бренд в каждой модели и совпадают ли эти наборы.
- Источники по модели. Какие площадки цитирует каждая, и какая доля приходится на ваш домен.
Коротко из врезки: не усредняйте модели в один показатель, держите формулировки запросов одинаковыми и пересчитывайте прошлый период, если набор моделей изменился.
Что делать с расхождением
- Выделите модель с самой низкой долей присутствия и разберите её источники: какие площадки она цитирует по вашей категории.
- Сравните этот список с тем, где бренд уже представлен; разница и будет планом публикаций.
- Проверьте модели без веб-поиска: если бренда нет именно там, нужны устойчивые упоминания в крупных справочных и отраслевых источниках, а не свежие посты.
- Повторите замер через период на том же наборе запросов и посмотрите, сдвинулась ли именно та модель, под которую вы работали.
Расхождение между моделями неудобно для отчёта, но именно оно показывает, где у бренда дырка в источниках. Усреднённая цифра выглядит аккуратнее и не говорит ничего: по ней нельзя понять, какую площадку надо занять в следующем месяце.