Ваш бренд упоминают нейросети, но клиентов это не приносит. Какие показатели GEO действительно важны бизнесу
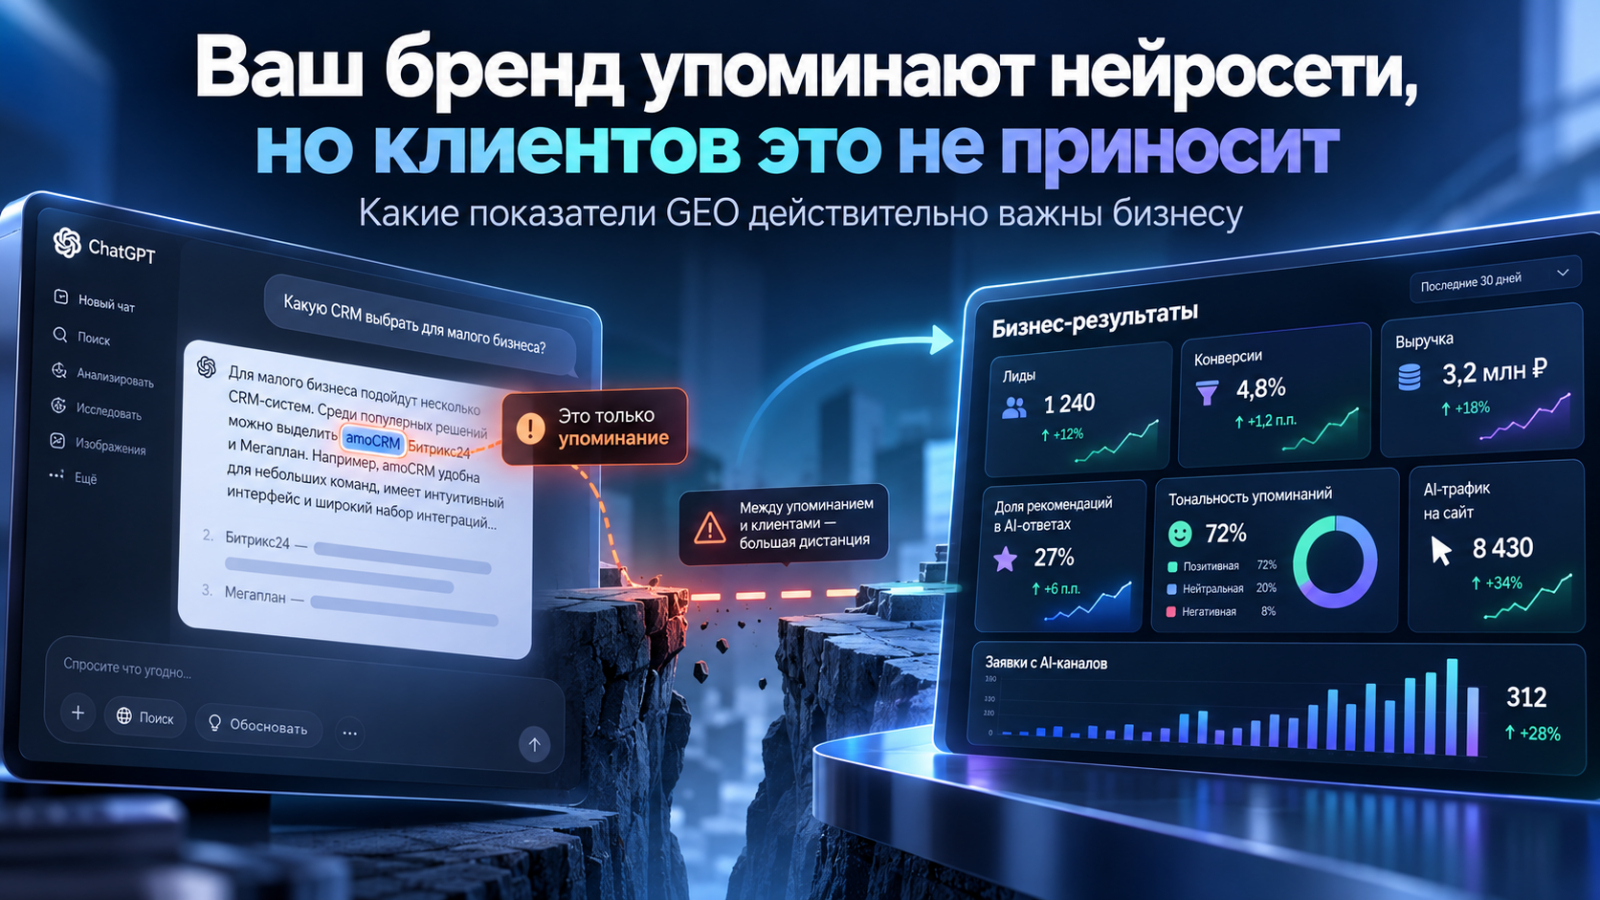
Компания полгода занималась GEO. Собрали список запросов, настроили мониторинг ответов ChatGPT и других ассистентов, выпустили серию публикаций, обновили страницы о продукте. На отчётном слайде AI Visibility выросла с 12 до 34 процентов. Работа выглядит успешной, и на этом обычно всё заканчивается.
Здесь возникает странная ситуация. Видимость растёт, а отдел продаж не замечает ни новых обращений, ни новых вопросов про бренд. Причина чаще всего не в том, что замер неверный, а в том, что он усреднён: процент собран по всем ответам подряд, включая те, где бренд назван как пример из отрасли и решение о покупке в этот момент никто не принимает.
Знание, упоминание, цитирование и рекомендация это четыре разных факта
Их легко свести в одну метрику, и после этого отчёт перестаёт что-то значить. Разница между ними в том, какую роль бренд играет в ответе.
- Знание бренда: модель отвечает по существу на прямой вопрос о компании. Это база, но она ничего не говорит о том, появится ли бренд там, где его не спрашивали.
- Упоминание: название встречается в ответе на тематический запрос, обычно в перечислении или как иллюстрация. Роль пассивная.
- Цитирование: ваша страница или публикация попала в список источников ответа. Это важно для понимания информационного следа, но источник и рекомендация не одно и то же.
- Рекомендация: модель называет бренд в ответ на запрос выбора, то есть фактически советует его пользователю. Этот случай ближе всего к коммерческому результату.
Бренд может уверенно держаться в первых трёх категориях и почти не появляться в четвёртой. В отчёте, где всё сложено в один процент, этот разрыв не виден.
Почему высокая AI-видимость не означает высокую коммерческую видимость
Посмотрим на это глазами модели. В справочном ответе её задача пересказать, как устроена категория, и для этого удобно опереться на отраслевые статьи, обзоры и энциклопедические источники. В ответе на запрос выбора задача другая: назвать несколько конкретных вариантов и объяснить, кому они подходят. Здесь модель опирается на другой тип материалов, где есть сравнения, условия, ограничения и описание сценариев.
Если бренд присутствует только в первом слое источников, он будет стабильно попадать в объяснения и стабильно выпадать из подборок. Общий процент при этом остаётся высоким: справочных формулировок в любой выборке запросов обычно больше, чем покупательских.
Разделите запросы по этапам принятия решения
Это первое, что стоит сделать с уже собранным списком запросов. Достаточно четырёх групп, и видимость считается в каждой отдельно.
- Информационные: что это такое, как работает, чем отличается. Здесь бренд выступает примером, и высокая видимость почти ничего не стоит.
- Сравнительные: что лучше, чем отличается одно от другого, какие вообще есть варианты. Начинает иметь значение, в каком ряду стоит название.
- Выборочные: что выбрать под конкретную задачу, бюджет или ограничение. Это ядро коммерческой видимости.
- Брендовые: отзывы, надёжность, стоит ли работать с компанией. Здесь важна не частота, а содержание ответа.
После такого деления обычно выясняется, что рост общего процента дала первая группа, а третья за полгода не изменилась. Это уже вывод, с которым можно идти к контент-плану.
Доля рекомендаций относительно конкурентов
Абсолютные проценты мало что объясняют. В одних категориях модель охотно называет конкретные бренды, в других отвечает общими словами и не называет почти никого. Поэтому по выборочным запросам считают долю: сколько раз в ответах назвали вас и сколько раз каждого из конкурентов.
Разовый замер собирается вручную на нескольких десятках формулировок. Для регулярного наблюдения по сотням ответов нужен мониторинг: я смотрю это в brandfound, он считает, как часто бренд называют по десяти системам, от ChatGPT и Gemini до GigaChat и Алисы, вместе с тональностью и источниками ответа.
Смотреть стоит динамику доли, а не один срез. Ответы моделей меняются от обновления к обновлению, и случайное колебание легко принять за тренд.
Тональность и контекст важнее самого факта появления
Упоминание бывает нейтральным, объясняющим, оговорочным и прямо негативным. Бренд, которого называют в ответе на запрос про сложности и жалобы, формально увеличивает видимость. Для бизнеса это совсем другая новость. Поэтому к частоте добавляют контекст: в каком ряду стоит название, с какими оговорками, какие свойства бренду приписаны и совпадают ли они с реальными.
Отдельная строка это неверные факты. Устаревший тариф, закрытое направление, чужой город, приписанная услуга. Такие ошибки стоят дороже низкого процента, потому что воспроизводятся в каждом ответе, пока источник не исправлен.
Что включить в первый GEO-отчёт для руководителя
- Видимость отдельно по четырём группам запросов, а не одним общим процентом.
- Доля рекомендаций по выборочным запросам в сравнении с тремя-пятью конкурентами.
- Динамика за период, минимум три замера, иначе колебания моделей читаются как результат работы.
- Тональность и типовой контекст упоминаний, с примерами формулировок из ответов.
- Список неверных и устаревших фактов о компании, которые модели воспроизводят.
- Источники, на которые модели опираются в вашей категории, с отметкой, где бренд уже присутствует.
Такой отчёт не отвечает на вопрос, сколько денег принесло GEO. Он отвечает на другой: в какой момент выбора бренд исчезает из ответа и какой материал нужен, чтобы это изменить. Для первого года работы этого достаточно.
Коротко: пока в аналитике нет размеченных переходов из ассистентов и данных опроса клиентов, рост рекомендаций честнее показывать как промежуточный показатель, а не как источник выручки.
Сам факт роста упоминаний ещё ничего не гарантирует. Начните с того, чтобы разделить свои запросы по этапам и посмотреть на видимость в самой узкой группе, где пользователь спрашивает, что ему выбрать. Обычно именно там и находится разрыв между красивым процентом в отчёте и тишиной в отделе продаж.