У бренда 20 преимуществ, ChatGPT запомнил три
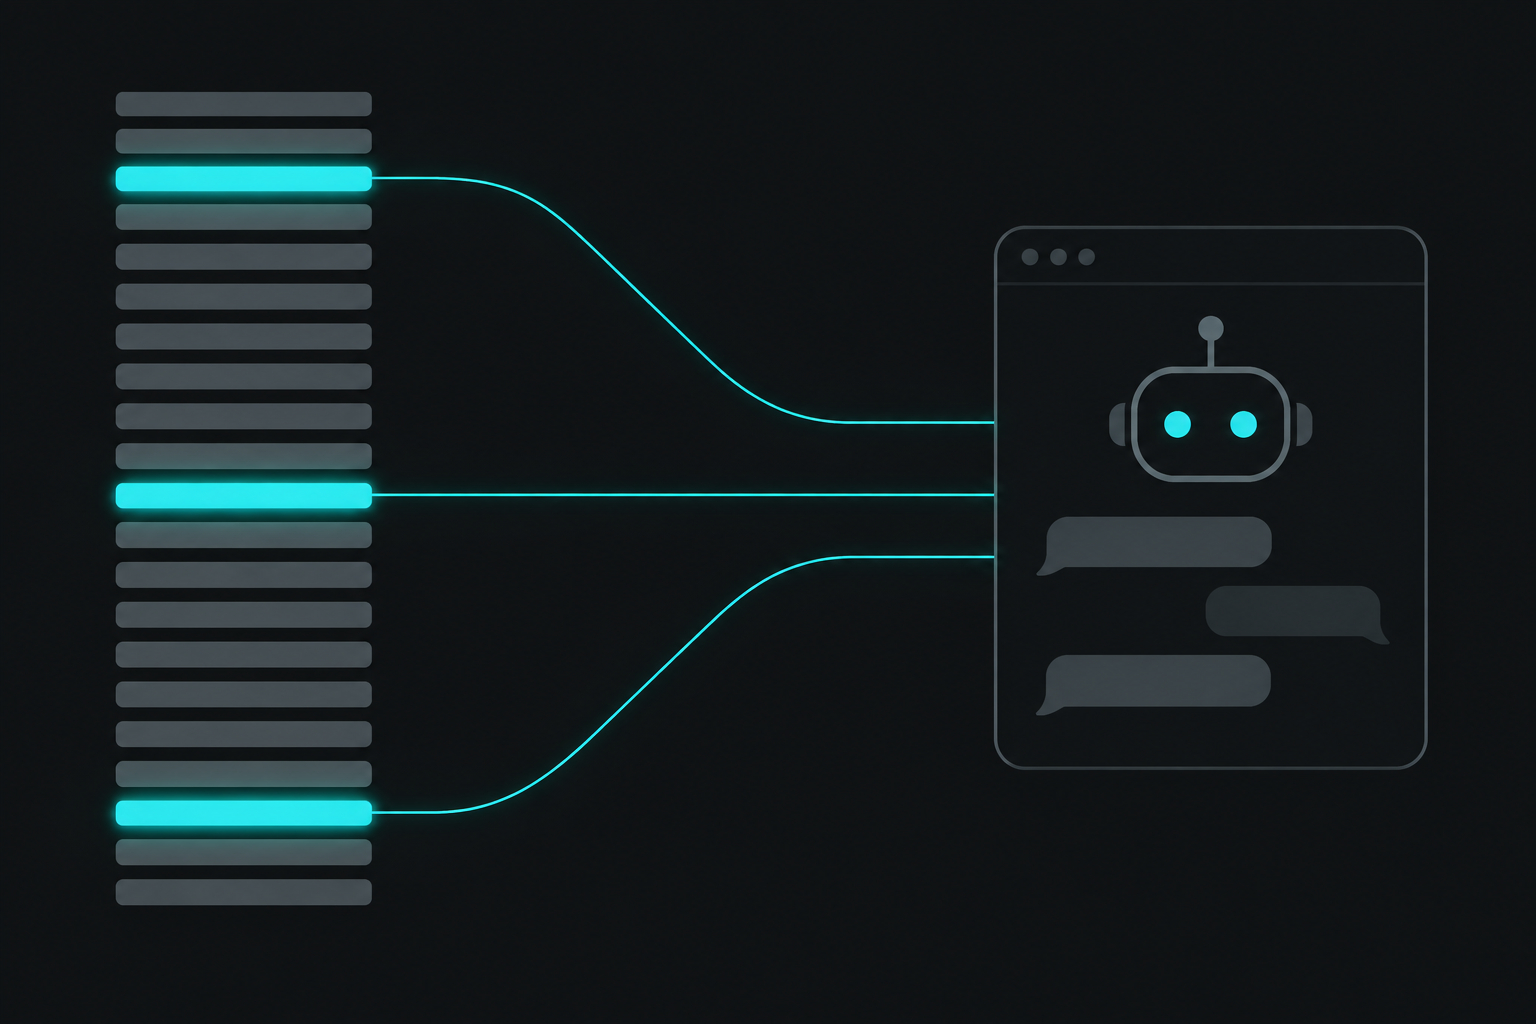
Почти у любой компании есть список того, чем она хочет быть в голове у клиента. Быстрый. Надёжный. Для бизнеса. Доступный. Премиальный. Технологичный. Прозрачный в тарифах. Сильный в поддержке. Такой список живёт в брендбуке, в презентации для совета директоров, в брифе агентству, и в нём обычно пятнадцать-двадцать пунктов.
Двадцать сообщений на входе, три на выходе
Я много раз задавал нейросетям вопросы про конкретные бренды и почти всегда видел одно и то же: из двадцати заявленных характеристик модель уверенно воспроизводит три-четыре. Остальные либо не звучат вовсе, либо звучат, но рядом с названием конкурента.
Это не поломка модели. Это её нормальная работа: она пересказывает не брендбук, а то, что нашла и усреднила по отзывам, обзорам, форумам, каталогам и статьям. Если характеристику никто, кроме самой компании, не повторяет, у модели нет причин считать её свойством бренда.
Почему «знает ли ChatGPT наш бренд» это слабый вопрос
Вопрос про знание даёт бинарный ответ, с которым нечего делать. Упомянули - хорошо. Не упомянули - плохо. Дальше начинается гадание: писать больше статей, идти в отзывы, менять формулировки на сайте.
Атрибутивная постановка сразу даёт адрес проблемы. Не «мы недостаточно видимы», а «характеристика про скорость внедрения у нас не считывается ни одной моделью, зато у конкурента считывается в четырёх ответах из пяти». Это уже задача, которую можно отдать в работу и потом проверить.
Карта атрибутов: что это за таблица
Берём список из 10-20 характеристик, которыми компания хочет обладать, и по каждой смотрим четыре колонки:
- что бренд говорит о себе (формулировка из позиционирования);
- что говорит ChatGPT (называет ли модель эту характеристику, отвечая про бренд);
- что говорит Gemini (совпадает картина или модели расходятся);
- что говорят про конкурента (кому эта характеристика досталась на рынке).
Важная деталь: спрашивать надо не про бренд. Вопрос «какие преимущества у компании N» провоцирует модель пересказать сайт компании. Полезнее заходить со стороны атрибута: «какой сервис в этой категории самый быстрый по внедрению», «кому проще всего разобраться новичку», «у кого самая прозрачная цена». В ответ приходит список имён, и в нём уже видно, стоит бренд рядом с характеристикой или нет.
Замерять такое вручную можно ровно один раз: двадцать атрибутов на несколько моделей и несколько формулировок каждого вопроса это сотни ответов, а через месяц всё надо повторить. Я веду это в brandfound: сервис прогоняет запросы по десяти ассистентам, от ChatGPT и Gemini до GigaChat и Алисы, и показывает не только факт упоминания, но и тональность и источники, из которых модель собрала ответ. Источники здесь важнее самого упоминания: они говорят, какой текст в интернете надо поправить, чтобы атрибут закрепился.
Четыре типа атрибутов, которые видно на карте
- Подтверждённые. Бренд заявляет, модели повторяют. Это актив: его не надо чинить, надо защищать от конкурентов.
- Чужие. Бренд заявляет, модели отдают характеристику конкуренту. Самая дорогая группа: рынок уже назначил владельца атрибута, отвоёвывать дороже, чем занимать свободный.
- Пустые. Бренд заявляет, у моделей характеристики нет ни у кого. Часто лучшая точка входа: атрибут свободен, занять его можно серией понятных публикаций и обновлением фактов на сайте.
- Навязанные. Бренд не заявляет, а модели устойчиво приписывают: «дорогой», «для крупных компаний», «сложный в настройке». Это сложилось из отзывов и обзоров, и маркетинг узнаёт об этом последним.
Что с этим делать дальше
Карта нужна не ради картинки, а чтобы сузить работу: выбрать два-три атрибута, а не двадцать. Приоритет обычно такой: сначала навязанные, если они вредят, потом пустые, потом чужие, которые реально отбить.
Дальше идёт обычная редакционная работа, просто адресная. Под выбранный атрибут нужны внешние тексты, где характеристика подтверждается фактом, а не эпитетом: цифра, срок, кейс, сравнение. Модель охотнее переносит в ответ проверяемое утверждение, чем прилагательное.
Карту имеет смысл перезамерять. Формулировки моделей меняются вслед за источниками, и атрибут, появившийся в ответах после публикаций, может так же тихо уйти.
Бренд управляет тем, что он говорит о себе. Видимость в AI решает, что из этого рынку слышно. Разница между этими двумя списками и есть предмет работы.