Почему нейросети чаще рекомендуют бренды, которые проще объяснить
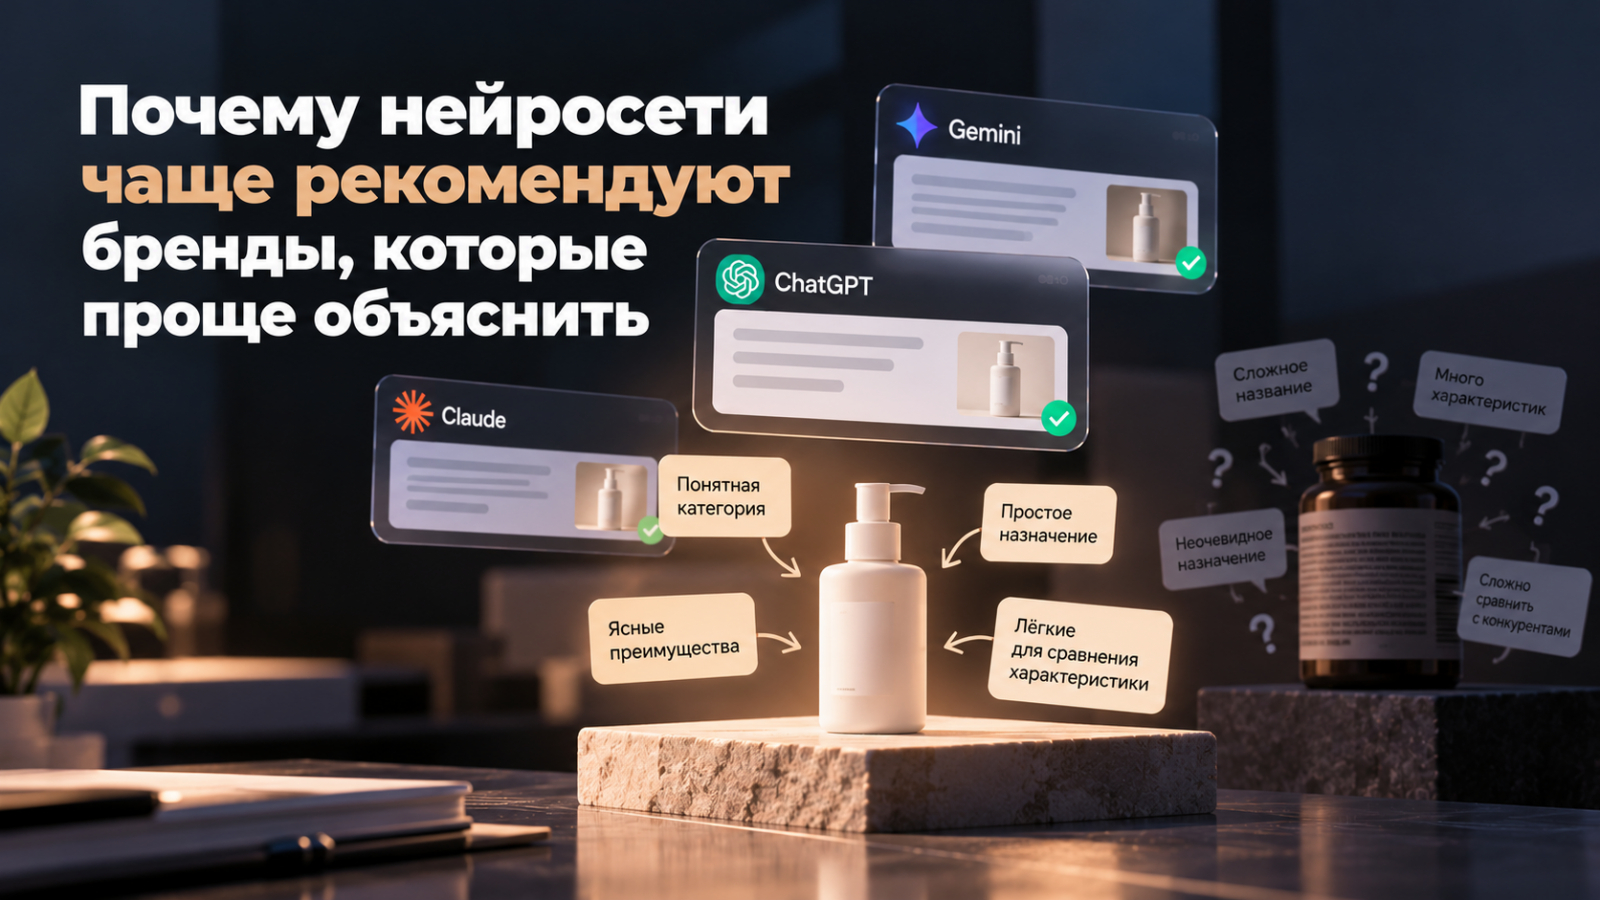
Когда бренд не попадает в ответы нейросетей, причину обычно ищут в объёме контента: мало статей, слабые источники, нет упоминаний на отраслевых площадках. Часть разрыва объясняется проще. Модель собирает ответ из коротких утверждений о компании, и если такое утверждение из материалов бренда не собирается, в рекомендацию он не попадает.
Что модель делает с позиционированием
Ответ ассистента это сжатие. На запрос вида «какой сервис выбрать для такой-то задачи» модель отдаёт три-пять вариантов и по одной строке пояснения у каждого. В эту строку помещается продукт, аудитория и задача. Если в источниках такой строки про бренд нет, собирать её модели не из чего, и место занимает конкурент, у которого она собирается.
Само по себе это не значит, что сложный продукт обречён на невидимость. Но описание, которому нужны два абзаца контекста, в выжимку не помещается, и модель пересказывает его так, как сумела понять из того, что нашла.
Как это видно в цифрах
Здесь полезно разделять два показателя, которые часто считают одним. Brand Mention Rate это доля ответов, где бренд вообще назван. Доля рекомендаций это доля ответов, где он назван как подходящий вариант под задачу пользователя. У брендов с размытым позиционированием чаще встречается картина, когда первый показатель держится, а второй заметно отстаёт: компанию перечисляют среди игроков рынка, но не советуют под конкретный запрос.
Разрыв между этими двумя числами и есть рабочая гипотеза о позиционировании. Проверять её стоит на выборке запросов, а не на отдельных ответах.
- доля упоминаний и доля рекомендаций считаются отдельно, а не одним числом
- формулировка, которой модель описывает бренд: повторяется ли она между нейросетями или каждая объясняет компанию по-своему
- запросы с указанием задачи и аудитории против общих запросов по категории
- кто стоит рядом в том же ответе и насколько короче описан
Если формулировки расходятся от модели к модели, это обычно означает, что в источниках нет одного устойчивого объяснения и каждая нейросеть достраивает его сама. Один замер такого не покажет: формулировка запроса влияет на состав ответа сильнее, чем кажется, и разовую выборку легко принять за тенденцию.
Что обычно мешает попасть в короткое объяснение
- описание через ценности и миссию вместо продукта и задачи
- перечень всех возможных применений без указания, кому продукт подходит в первую очередь
- внутренние названия модулей, которые ничего не значат за пределами компании
- разные версии позиционирования на сайте, в карточках каталогов и в публикациях
Несколько десятков запросов можно проверить руками. Для регулярного наблюдения за долей рекомендаций и за тем, какими словами модели описывают бренд, используют GEO-сервисы: brandfound, Profound, VisioBrand и другие. Польза здесь не в самом факте замера, а в том, что видно, какие аргументы и ассоциации нейросети повторяют, а какие не подхватывают ни в одном ответе. Этот список непокрытых формулировок и превращается в план материалов.
Проверить гипотезу можно за один цикл: собрать выборку запросов с явной задачей и аудиторией, замерить долю упоминаний и долю рекомендаций отдельно, затем выпустить материалы, где продукт объяснён одной проверяемой фразой, и повторить замер через месяц-полтора. Если доля рекомендаций растёт, а доля упоминаний стоит на месте, дело было не в объёме контента, а в том, что бренд было трудно объяснить коротко.