Бренд исчез из рекомендаций нейросети: как отличить обновление модели от разброса
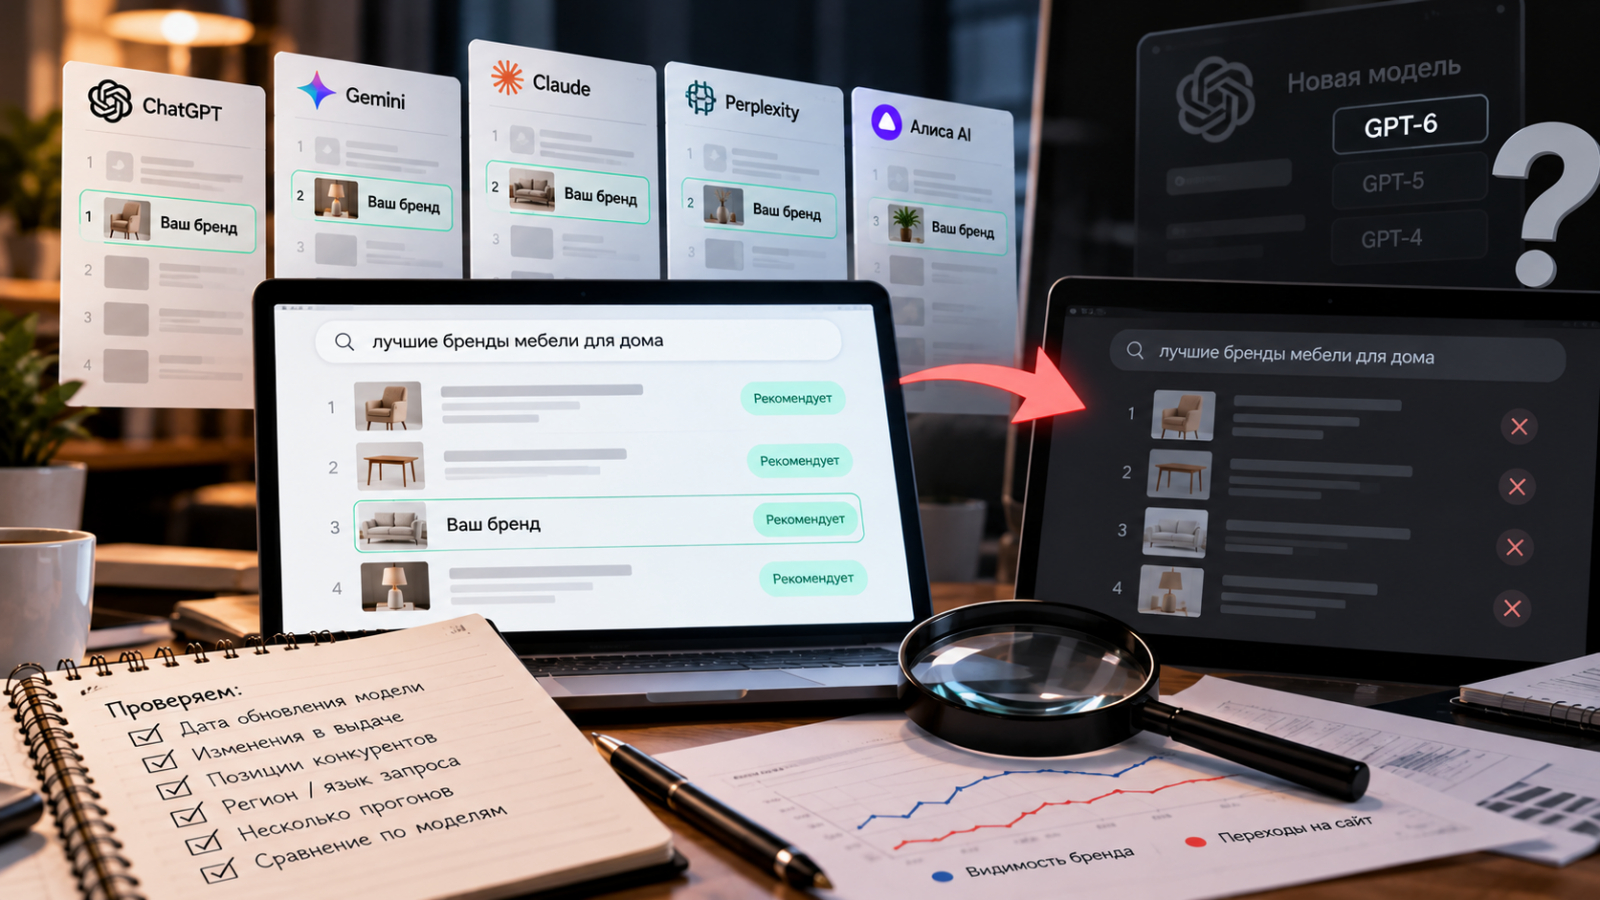
Ответы нейросетей не детерминированы. На один и тот же запрос модель может выдать разный набор брендов, и состав ответа меняется от прогона к прогону даже без обновления версии. Поэтому фраза «бренд пропал из рекомендаций» это пока не факт, а одно наблюдение в одной точке. Прежде чем искать причину в новой версии модели, стоит проверить, выходит ли новая картина за пределы обычного разброса.
Что именно нужно различить
За одинаковой картиной «нас больше не рекомендуют» стоят три разных события, и реагировать на них нужно по-разному.
- Случайный разброс: состав ответа меняется от прогона к прогону, а доля ответов с брендом остаётся в прежнем коридоре.
- Изменение модели: сдвиг совпадает с датой выхода версии, виден сразу на большинстве запросов и держится при повторных замерах.
- Изменение в данных: у вас или у конкурентов поменялись источники, которые модель цитирует, и сдвиг накапливался постепенно.
Шаг 1. Зафиксировать условия замера
Замер, у которого не описаны условия, нельзя сравнить ни с чем. Минимальный набор параметров, который фиксируется до прогона, а не после.
- Модель и её версия, а не просто «ChatGPT» или «Алиса».
- Дата и время замера.
- Формулировки запросов слово в слово, включая порядок слов.
- Регион и язык запроса.
- Режим ответа: с веб-поиском или без него.
- Состояние сессии: чистый диалог без истории и персонализации.
Если вместе с результатом поменялся хотя бы один из этих параметров, причина может быть в нём, а не в модели. Самый частый случай: прежние замеры шли без веб-поиска, новые с ним, и состав ответа изменился из-за источников.
Шаг 2. Повторить один и тот же запрос серией прогонов
Один прогон это одно наблюдение, по нему нельзя судить ни о чём. Рабочая схема это 20–30 прогонов одного запроса в чистых сессиях, а показатель не «есть бренд или нет», а доля ответов, в которых бренд появился, и доля ответов, где он назван в рекомендации, а не перечислен среди вариантов.
Допустим, в прошлом месяце бренд встретился в 8 ответах из 30, то есть в 27 процентах, а сейчас в 5 из 30, то есть в 17 процентах. Само по себе это число ничего не доказывает: при такой выборке разница укладывается в разброс. Без второго такого же замера вывод делать рано.
Ключевое правило короче: изменение, которое меньше вашего разброса, изменением не является.
Шаг 3. Проверять кластер запросов, а не один запрос
Запрос, на котором бренд пропал первым, это худшая точка для проверки гипотезы: именно его вы и выбрали потому, что там результат плохой. Берите кластер из 15–20 запросов одного интента и смотрите на долю по кластеру целиком. Падение на одном запросе при стабильном кластере почти всегда разброс или переформулировка. Падение по всему кластеру это уже сигнал.
Шаг 4. Разобрать конкурентный состав ответа
Отсутствие бренда это половина данных. Вторая половина это то, кто занял его место.
- Место бренда заняли те же конкуренты, что и раньше: похоже на разброс внутри одной группы кандидатов.
- В ответах появились игроки, которых там раньше не было: скорее изменился набор источников, чем модель.
- Список сократился с семи названий до трёх у всех запросов: изменилось поведение модели, а не её отношение к бренду.
- Исчезли и бренд, и половина прежних конкурентов: проверяйте, не стал ли ответ отказом от рекомендаций как таковых.
Шаг 5. Сопоставить сдвиг с линией времени
Дата обновления модели это проверяемая точка. Приложите к ней свою кривую замеров.
- Сдвиг уложился в один-два дня и виден во всех кластерах сразу: версия модели вероятная причина.
- Просела одна модель, остальные держатся: причина внутри этой модели или её поиска.
- Просели все модели одновременно: общий фактор, чаще всего источник, который вас цитировал, перестал индексироваться или исчез.
- Изменение росло неделями: это не обновление, а накопленный эффект контента и ссылок.
Что считать подтверждённым изменением
Практический порог, после которого изменение стоит считать реальным и начинать искать причину.
- Сдвиг повторился в двух независимых замерах, разнесённых во времени.
- Он превышает разброс, измеренный на ваших же данных, а не взятый из головы.
- Он виден на кластере запросов, а не на одном.
- Условия замера совпадают с прежними по всем шести параметрам из первого шага.
Такая схема плохо воспроизводится вручную: 30 прогонов на 20 запросов это уже около 600 обращений к одной модели за один замер, и это без истории за прошлые месяцы. Для регулярного измерения используют GEO-сервисы, которые опрашивают несколько AI-систем по расписанию и хранят результаты во времени: brandfound, Profound, Peec AI и другие. Ценность здесь даже не в самом замере, а в сохранённой истории: без прежних значений новое число не с чем сравнить, и любой провал выглядит катастрофой.
Самый частый результат такой проверки скромнее, чем ожидается: бренд никуда не исчез, а колебался в прежнем коридоре, просто раньше его никто не измерял серией. Я бы начинал не с поиска виновной версии модели, а с собственного разброса: пока он неизвестен, любая гипотеза об обновлении остаётся непроверяемой.