В GEO-отчёте нашли проблему: кому её исправлять, PR, SEO, контенту или продукту
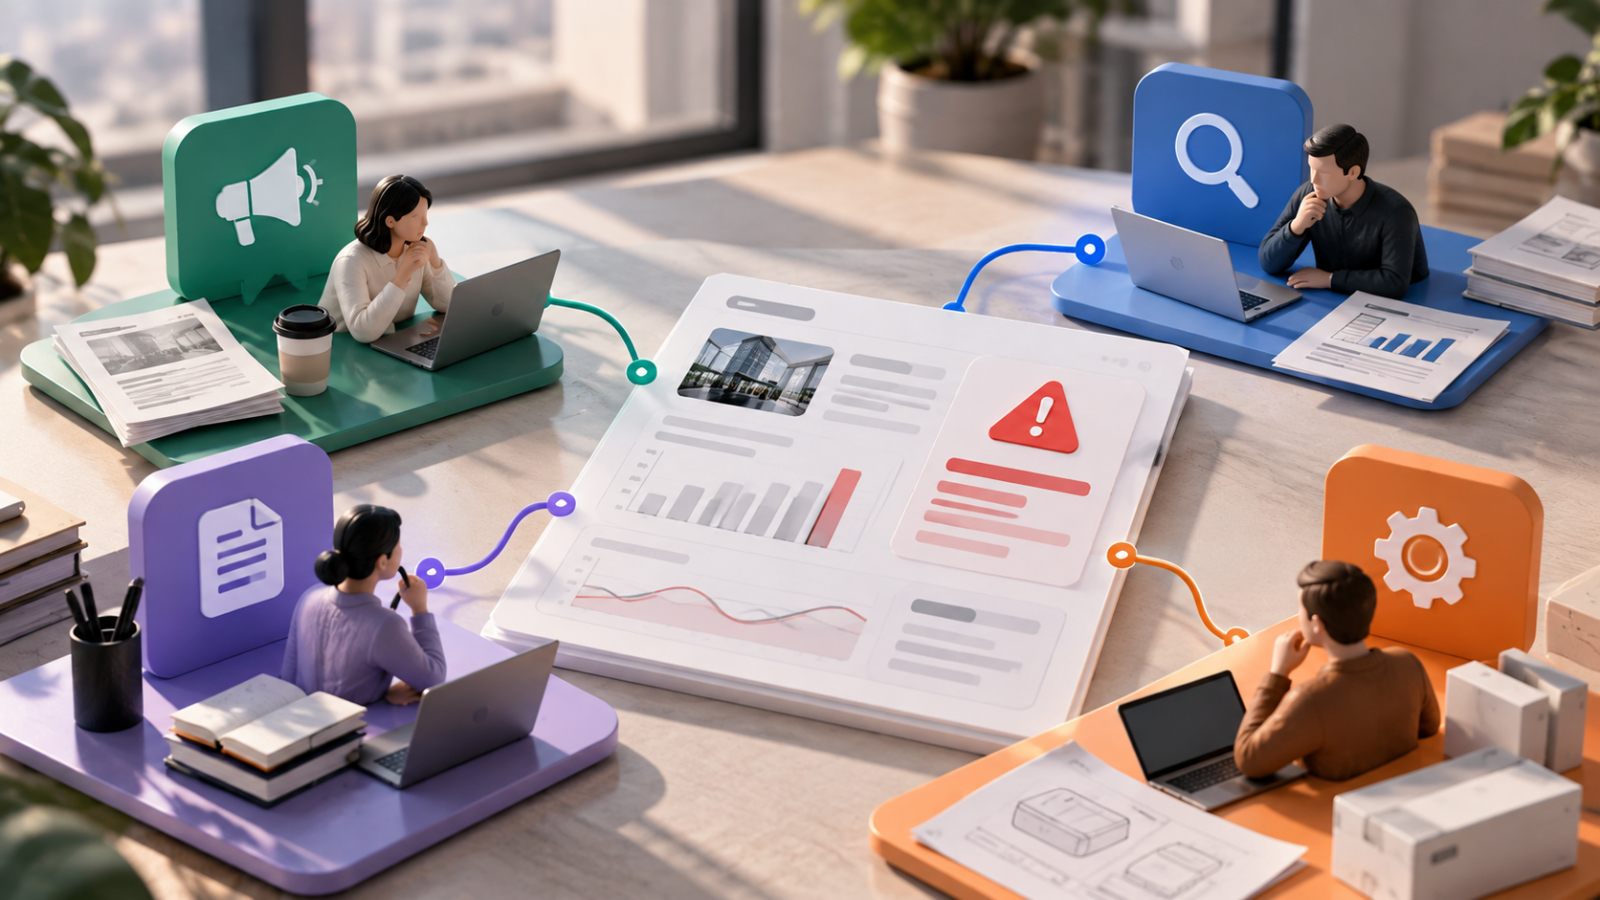
GEO-отчёт почти всегда читают как список потерь: здесь бренд не упомянут, здесь он стоит рядом с конкурентом, здесь модель сослалась на чужую статью. Дальше работа обычно встаёт, потому что непонятно, кто это исправляет. Отчёт фиксирует симптом, а владельца задачи приходится определять отдельно.
Разделить проще, чем кажется. Нужно от каждого проблемного запроса дойти до источника: что именно ответила модель и на что она при этом опиралась.
Четыре типа проблем и четыре владельца
- Ошибочный факт о продукте или условиях: продуктовая команда
- Слабые или невыгодные внешние источники: PR
- Нет страницы под сам запрос: контент
- Страница есть, но модель её не читает: SEO
Ошибочный факт: продуктовая команда
Если модель называет неверную цену, устаревший состав тарифов или функцию, которой нет, задача не в том, чтобы переписать внешние статьи. Сначала надо понять, откуда факт взялся: обычно он лежит в старом виде на собственном сайте или в карточке стороннего каталога, которую давно не обновляли. Пока первоисточник не исправлен, новые публикации будут соседствовать со старой версией, и модель продолжит выбирать между ними. Смотреть здесь стоит не на число упоминаний, а на долю ответов с ошибочным фактом, и считать её по каждой нейросети отдельно.
Слабые внешние источники: PR
Второй случай: факты верные, страница есть, но цитируют не вас. В выдаче источников видно, на что опирается модель: отраслевые издания, обзоры, форумы, подборки. Если бренд в них отсутствует или упомянут в сравнении не в свою пользу, это работа PR, а не контента. Признак именно этого типа: ваш домен в цитированиях почти не появляется, зато регулярно появляются три-четыре чужих материала. Один замер тут мало что даёт, список источников меняется от формулировки, поэтому проверять гипотезу стоит на группе запросов.
Нет страницы под запрос: контент
Третий случай самый частый. Запрос существует, конкуренты в ответах есть, бренд подходит по смыслу, но материала, который отвечал бы на этот вопрос напрямую, нет. Общая страница услуги не закрывает запросы вида сравнение, выбор, для какого случая подойдёт. Это задача контента, и она же самая измеримая: после публикации видно, появился ли домен в источниках и выросла ли доля упоминаний по этой группе запросов. Правда, попадание в ответы занимает время, и замер через неделю скорее покажет шум, чем результат.
Модель не читает страницу: SEO
Четвёртый случай выглядит обиднее всего: материал написан, а в ответах его нет. Причины обычно технические: страница закрыта от краулеров ИИ, контент собирается скриптом и в исходном HTML его нет, ответ спрятан за формой или вкладкой, важное лежит картинкой без текста. Качество текста тут ни при чём, переписывать его бесполезно. Проверяется быстро: если страница не отдаёт содержимое ботам, задача уходит SEO.
Как собрать это в рабочий контур
Разделение по владельцам работает, только если встроено в повторяемый цикл. Пять шагов, и все они опираются на одни и те же данные.
- Запрос: находим, где бренд теряется, и фиксируем формулировку
- Источник: смотрим, что ответила модель и на что сослалась
- Тип проблемы: факт, источник, отсутствие страницы или техника
- Исполнитель: задача уходит продукту, PR, контенту или SEO
- Повторный замер: сверяем ту же группу запросов через период
Несколько десятков запросов можно разобрать вручную в таблице. Для регулярного цикла нужны накопленные замеры во времени и выдача источников по каждому ответу, а это уже область GEO-сервисов: brandfound, Profound, VisioBrand, Peec AI и других. Различаются они как раз тем, что важно для такого разбора: набор моделей, глубина данных по цитированиям, частота замеров и то, насколько видна динамика, а не отдельный срез.
Короткая проверка: неверный факт в ответе это продукт; верный факт, но цитируют чужих, это PR; нет страницы под запрос это контент; страница есть, а в ответах её нет, это SEO.
Что смотреть на повторном замере
- Доля ответов с упоминанием бренда, по каждой нейросети отдельно
- Доля ответов, где бренд рекомендован, а не просто перечислен
- Частота цитирования вашего домена в источниках
- Состав конкурентов рядом с брендом в тех же ответах
- Динамика по группе запросов, а не по одному запросу
Снижение числа ошибочных ответов само по себе ещё не говорит об успехе: между замерами меняются и формулировки запросов, и сами модели. Вывод стоит делать на группе запросов и минимум на двух повторных срезах. Первой полезно проверить другую гипотезу: какая доля проблем в вашем отчёте вообще относится к контенту. Нередко разбор показывает, что заметная часть уходит продукту и SEO, а значит контент-план решает не ту задачу, которую ему поставили.