6 мифов о том, как нейросети выбирают источники: сверил с документацией OpenAI, Google, Яндекса и Perplexity
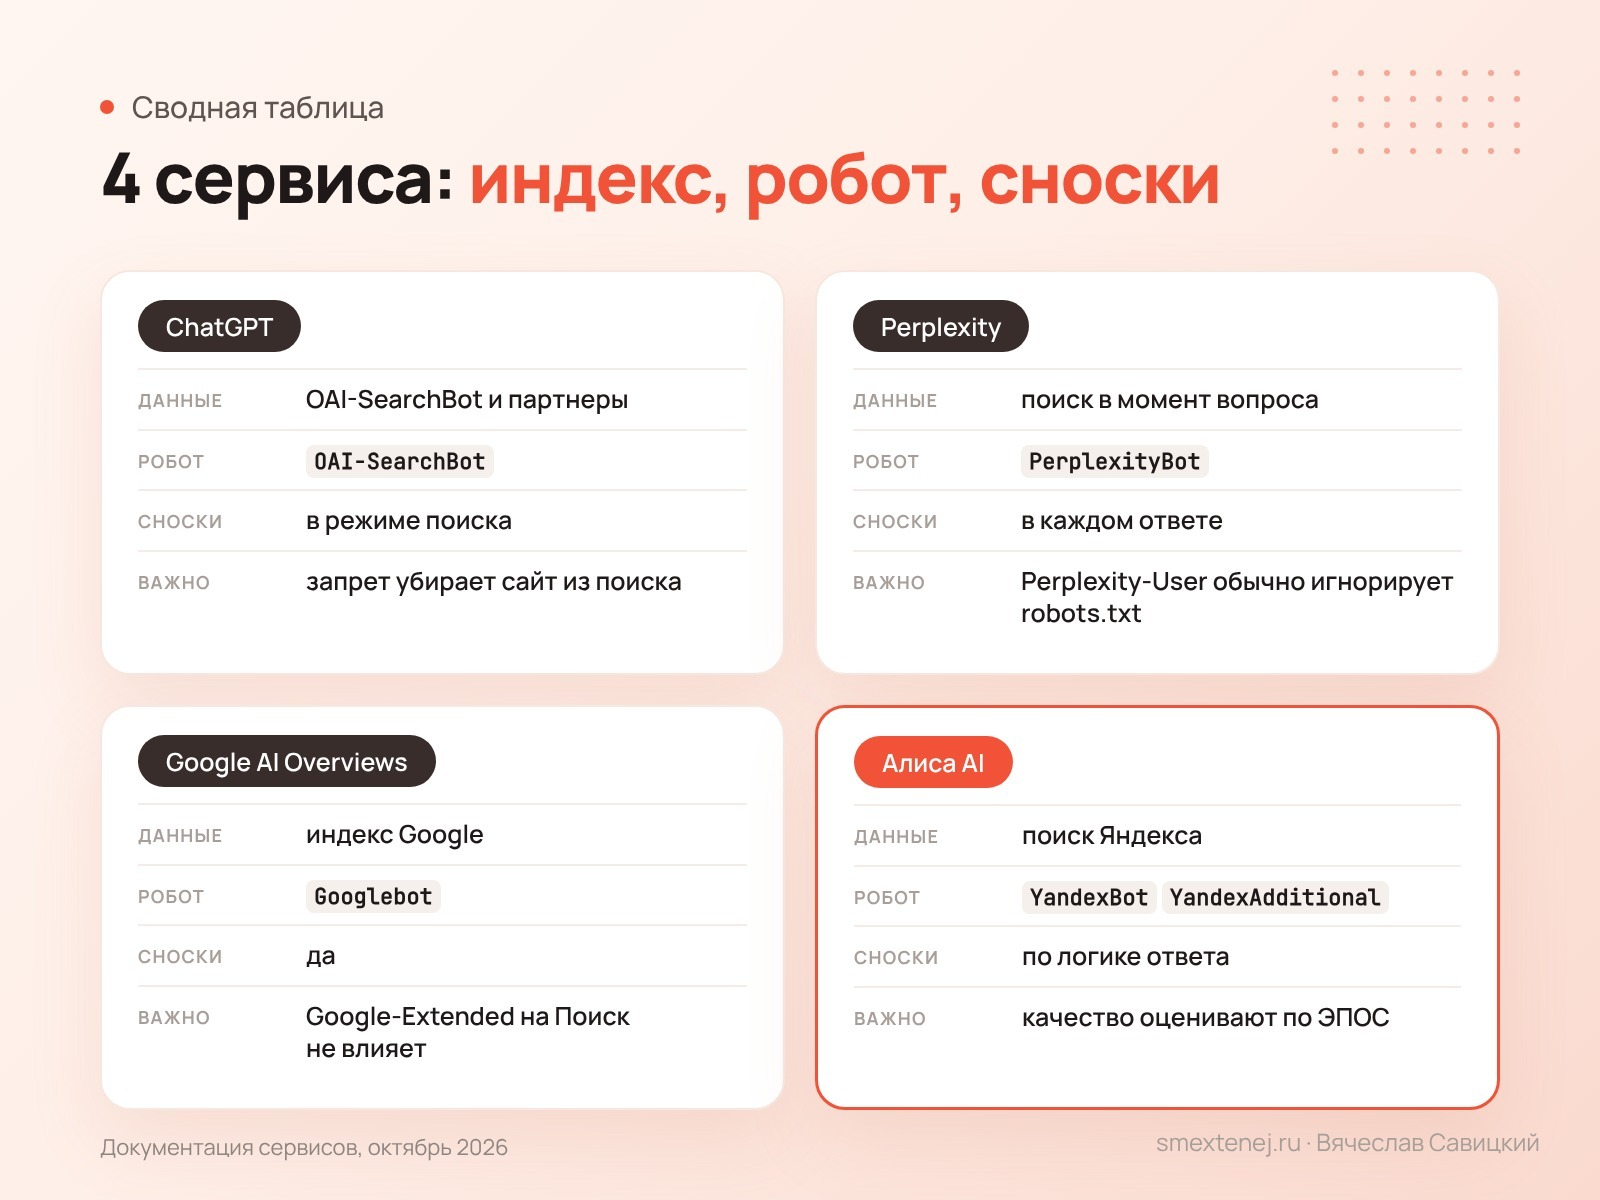
Нейросети выбирают источники для ответа в два шага: сначала поиск находит страницы по запросу, потом языковая модель пересказывает самые подходящие и ставит на них ссылки. Алиса AI опирается на поиск Яндекса, AI Overviews — на индекс Google, ChatGPT — на своего робота OAI-SearchBot и поисковых партнёров. Всё остальное, что рассказывают про «секретные факторы» нейросетей, в официальных справках сервисов не подтверждается, а кое-что им прямо противоречит.
Полный разбор документации со сводной таблицей и ответами на частые вопросы лежит у меня в блоге: Как нейросети выбирают источники: разбор документации 4 сервисов. Здесь я собрал шесть самых живучих мифов и то, что про них пишут сами сервисы.
Я Вячеслав Савицкий, копирайтер-маркетолог, пишу тексты с 2009 года. До этого около трёх лет работал анестезиологом-реаниматологом, а в реанимации дозировку сверяют по инструкции к препарату, а не по пересказу коллеги в коридоре. С GEO я поступаю так же: в октябре 2026 года прочитал справки четырёх сервисов и сверил с ними то, что пишут на сайтах про продвижение в нейросетях.
Сначала про механику: как ответ собирается из источников
Языковая модель отвечает либо по памяти, либо после поиска в интернете. Память застывает на дате среза знаний, и на неё владелец сайта почти не влияет. А вот второй путь, RAG, или генерация с поиском по источникам, открыт каждому:
- Человек задаёт вопрос в чате.
- Сервис переписывает его в одну или несколько поисковых фраз и отправляет в индекс.
- Поиск возвращает страницы, сервис вырезает из них фрагменты с прямым ответом.
- Модель пишет ответ своими словами и ставит сноски.
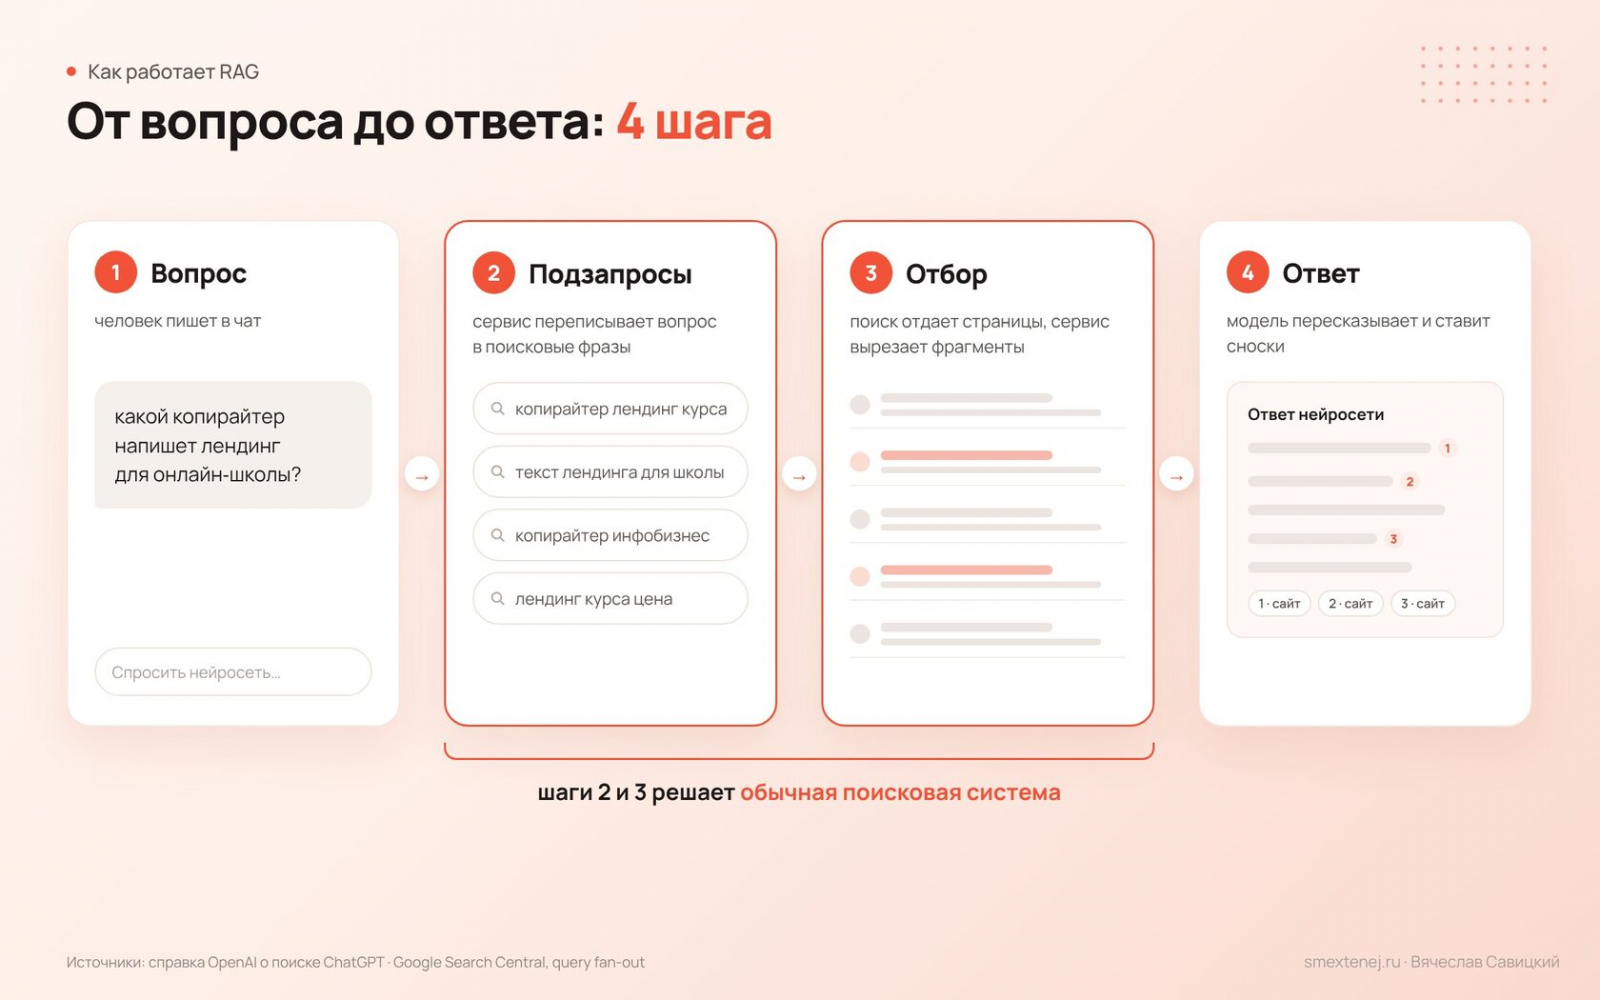
На втором и третьем шагах работает обычный поиск. Поэтому страница, которой нет в индексе, для нейросети не существует, как бы хорошо она ни была написана.
Миф 1. «Закрыли GPTBot — исчезли из ChatGPT»
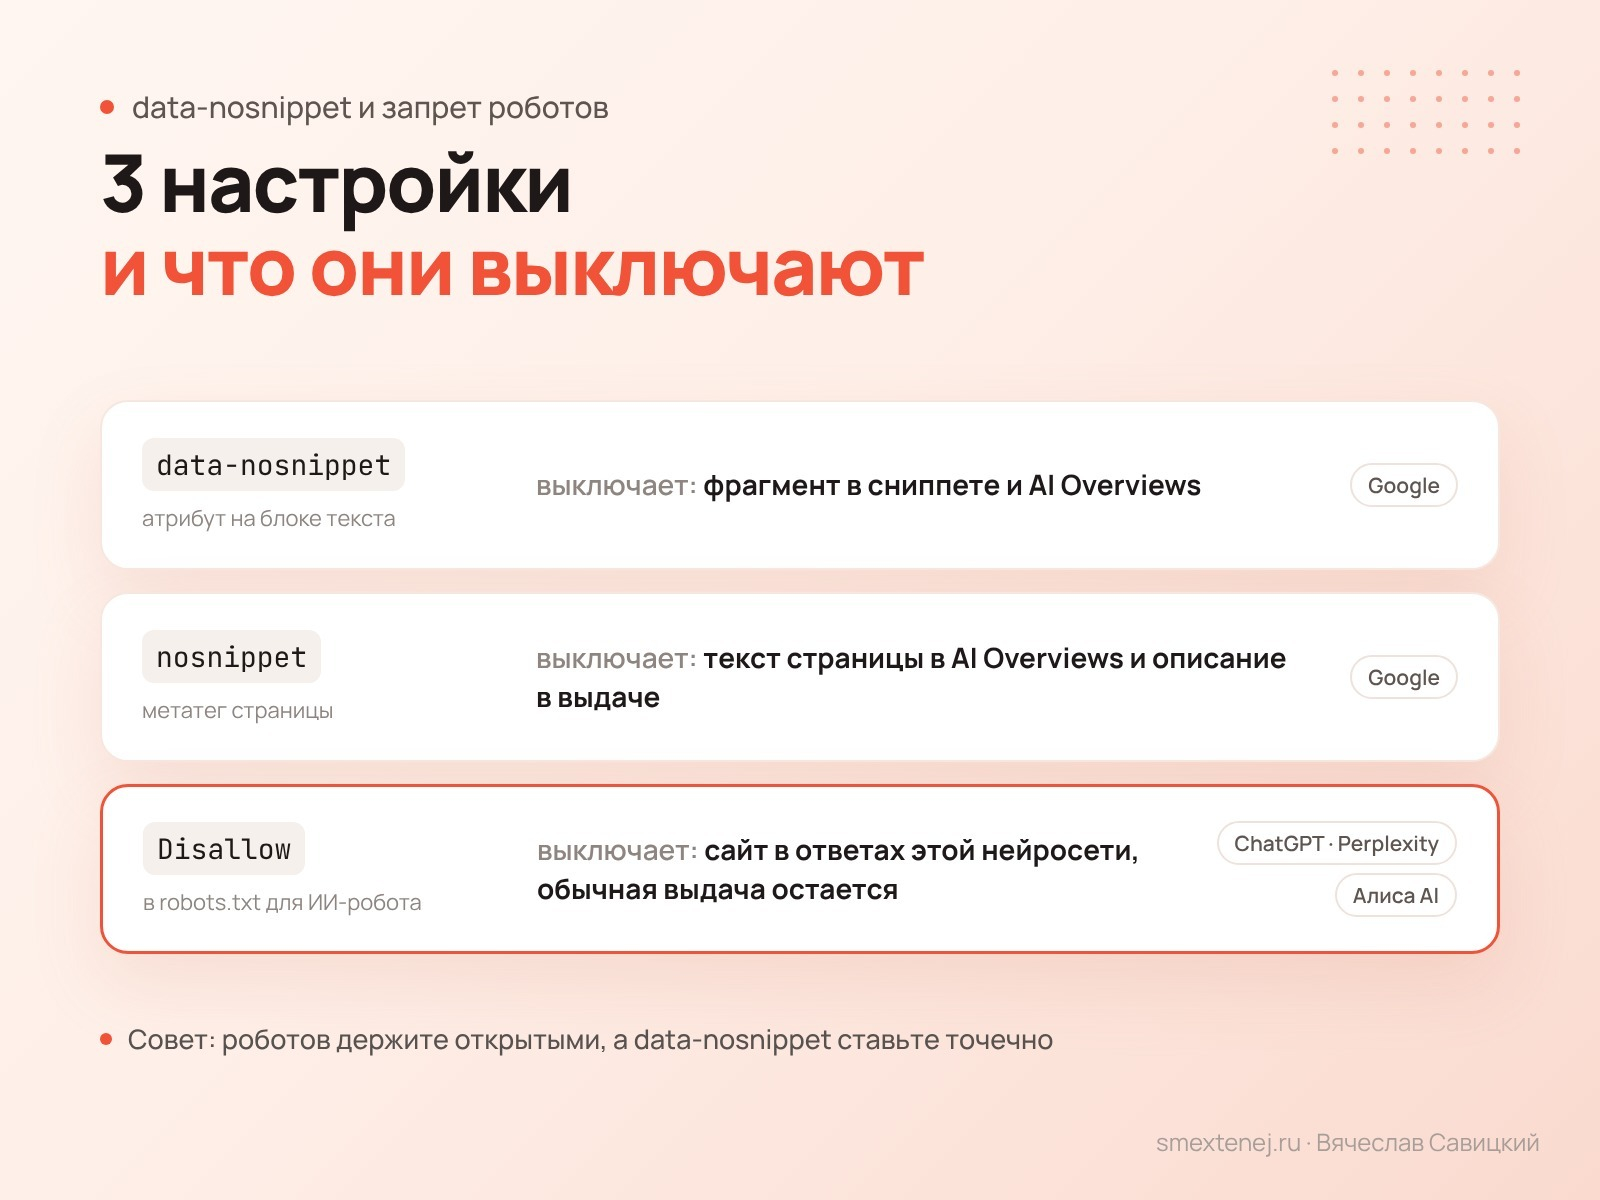
У OpenAI три робота с разными задачами. GPTBot собирает тексты для обучения моделей, и запрет для него поиск в ChatGPT не трогает. За попадание в поисковые ответы отвечает OAI-SearchBot: по словам самой OpenAI, сайты с запретом для него из поиска ChatGPT исчезают. Третий робот, ChatGPT-User, открывает страницы по действиям пользователя, и к нему правила robots.txt применяются не всегда.
Получается, можно запретить обучение на своих текстах и при этом остаться в ответах. Ошибка в обратную сторону обходится дороже: закрыв «всех ботов OpenAI» одной строкой, сайт выпадает из поиска ChatGPT.
Миф 2. «Запрет Google-Extended уберёт сайт из AI Overviews»
Токен Google-Extended управляет обучением Gemini и использованием веб-данных в других продуктах. В списке своих краулеров Google прямо пишет, что на попадание в Поиск и ранжирование этот токен не влияет. Запрет Google-Extended оставляет сайт в AI Overviews, а убрать его оттуда может только запрет Googlebot, и тогда сайт пропадёт и из обычной выдачи.
Миф 3. «Для AI Overviews нужна особая оптимизация»
В документации Google об ИИ-функциях сказано просто: странице достаточно быть в индексе и иметь право на сниппет. Никаких специальных требований сверх обычного SEO там нет. Особенность одна: фрагмент с атрибутом data-nosnippet Google не возьмёт ни в сниппет, ни в ИИ-ответ. Прятать так полезный контент бессмысленно, нейросеть просто процитирует похожий текст с чужого сайта.
Миф 4. «Perplexity берёт источники из Bing»
Эту связку повторяют во многих статьях о GEO, но в официальных материалах Perplexity о Bing нет ни слова. У сервиса два своих робота. PerplexityBot показывает сайты в поиске Perplexity и ставит на них ссылки, а Perplexity-User заходит на страницу в момент вопроса пользователя. С ChatGPT иначе: среди поисковых партнёров OpenAI упоминает Microsoft, владельца Bing.
Миф 5. «Нейросеть выбирает по DR, длине текста и плотности ключей»
Метрики DR и DA, длину текста и плотность ключевых слов SEO-специалисты обсуждают активно, но в справках сервисов о них ни слова. Яндекс пишет, что ответы Алисы AI опираются на источники, которые высоко ранжируются в поиске, а качество страниц оценивает по критериям ЭПОС: экспертность, полезность, оригинальность и содержательность. Google отсылает к обычным правилам качества, OpenAI и Perplexity — к доступу для робота.
На практике выигрывает страница с точным ответом на вопрос. В моей проверке 30 сайтов из топа Яндекса на вопросы «сколько стоит» Алиса AI в 4 городах из 5 брала цены с сайтов местных компаний. А на вопрос о выборе стоматологии в Екатеринбурге 6 источников из 10 оказались блогами клиник из Фрязино, Реутова, Москвы и Перми. Позиция главной страницы и адрес компании отошли на второй план. Подробно об этой проверке я писал в первом посте здесь, на Sostav.
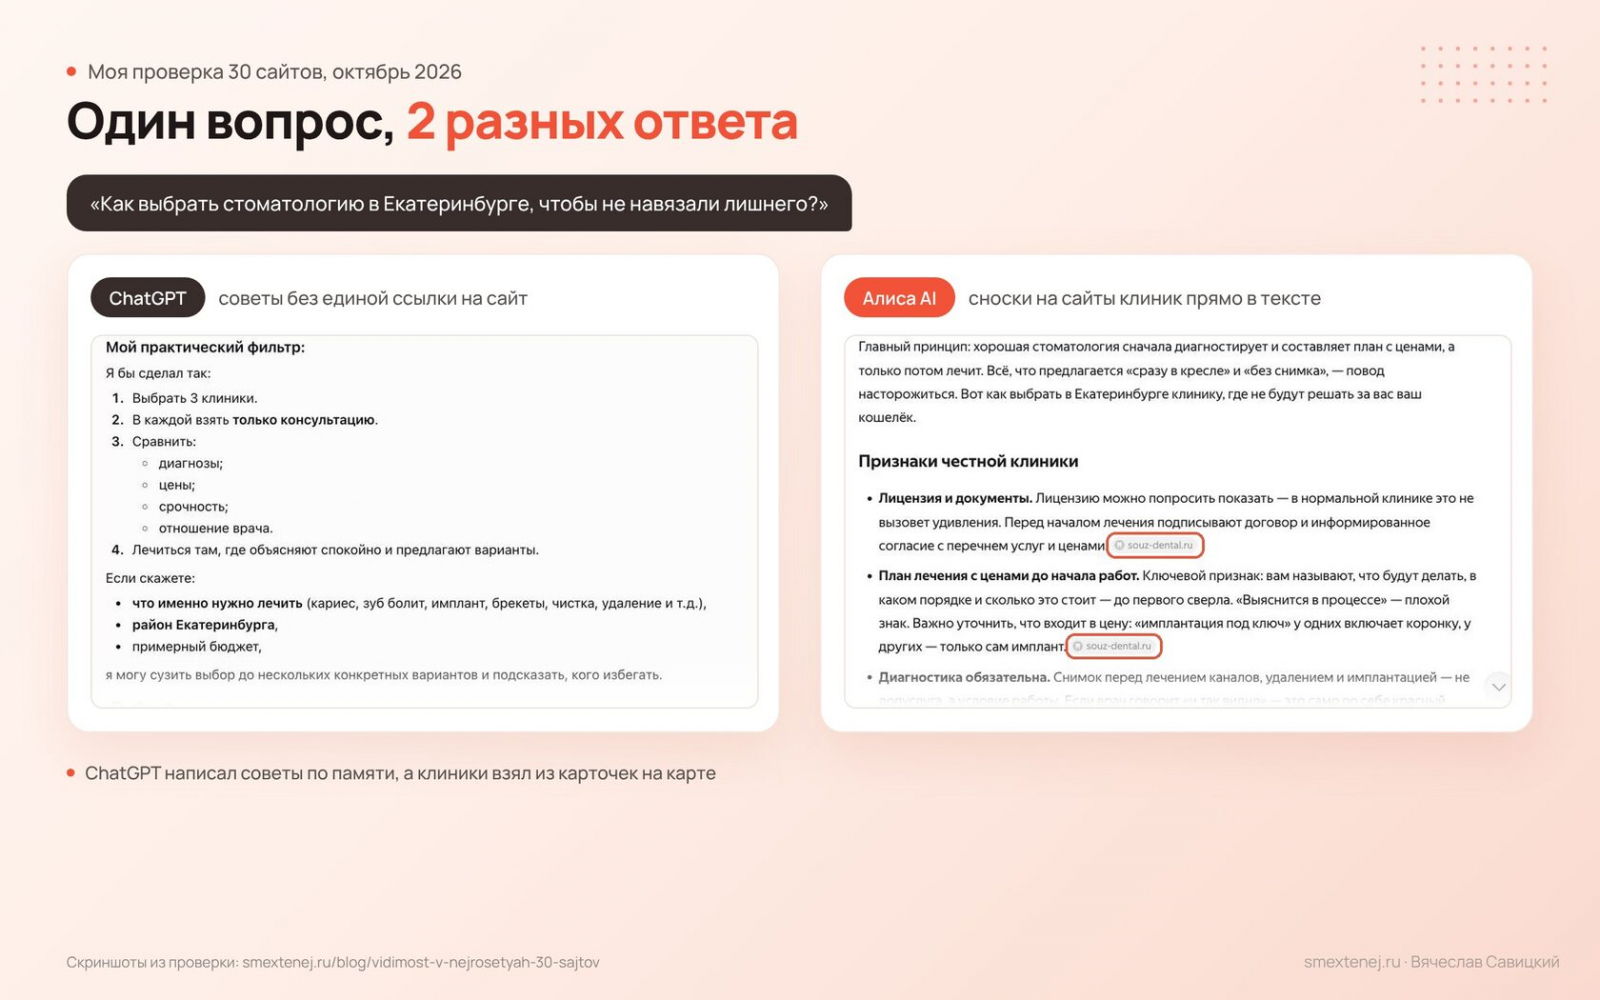
Там же видна разница двух путей. ChatGPT в 2 ответах из 5 обошёлся без единой ссылки на сайты, то есть отвечал по памяти, а Алиса AI на 10 информационных вопросов дала 73 ссылки. Простая подсказка: ответ без сносок почти всегда написан по памяти модели.
Миф 6. «Достаточно попасть на любимую площадку нейросети»
Исследования показывают, что любимые площадки моделей меняются быстро. Profound изучил 680 млн цитирований с августа 2024 по июнь 2025 года: ChatGPT чаще всего ссылался на Википедию (7,8 % цитирований), Perplexity — на Reddit (6,6 %). А Semrush, отслеживая 230 000 промптов летом и осенью 2025 года, увидел, что доля ответов ChatGPT со ссылкой на Reddit упала примерно с 60 % в начале августа до 10 % к середине сентября. Обе выборки англоязычные, так что для рунета это ориентир, а не правило. Но вывод понятен: ставить всё на одну площадку рискованно.
Что из этого следует: 7 шагов в источники ответа
- Поисковые кабинеты. Подключите Яндекс Вебмастер, Google Search Console и Bing Webmaster Tools и проверьте, что важные страницы в индексе.
- Доступ роботам. Откройте в robots.txt OAI-SearchBot, PerplexityBot, Googlebot, YandexBot и YandexAdditional. Закрытие YandexAdditional убирает сайт из быстрых ответов Алисы за 2–14 дней.
- Отдельная статья под вопрос с прямым ответом в первом абзаце.
- Цифры и факты: цены, сроки, ссылки на документы.
- Подзаголовки-вопросы, списки и таблицы, чтобы поиску было из чего вырезать фрагмент.
- Подпись автора и дата обновления.
- Внешние упоминания: подборки СМИ и профили на отраслевых площадках.
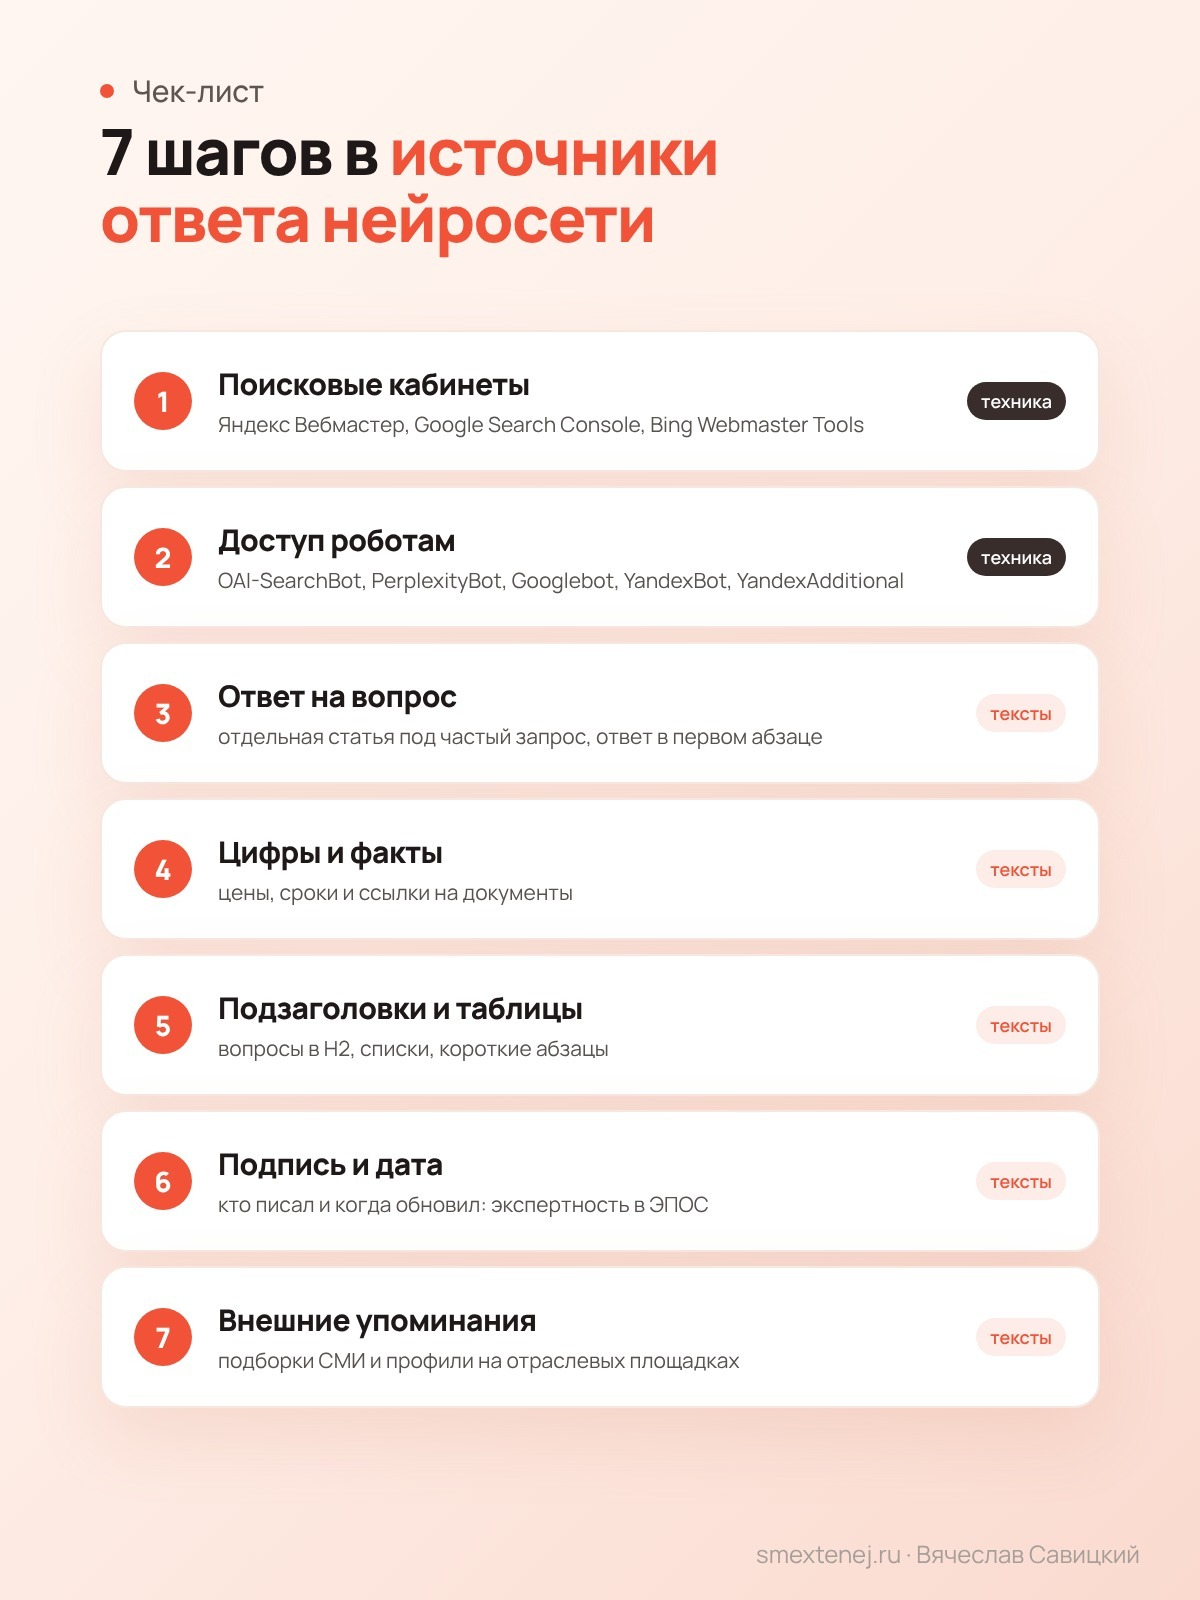
Первые два шага занимают один вечер, остальные — это регулярная работа с текстами. Для этого я веду для бизнеса живой блог: 4 статьи в месяц, размещение и ежемесячный замер упоминаний в ответах нейросетей. Как это устроено, рассказал на странице продвижение бизнеса в нейросетях.