Почему ChatGPT выбирает конкурента, а не вас: разбираем чужую AI-видимость
На квартальном созвоне клиент разворачивает экран, открывает ChatGPT и спрашивает его так, как спросил бы покупатель: кому отдать такую-то задачу. В ответе три компании. Клиента среди них нет. Дальше пауза и вопрос, который я слышу примерно на каждом втором проекте: а почему тут они, а нас нет?
Привычная реакция такая: срочно переписать страницы услуг, добавить ответы на вопросы, разметить всё по schema.org и ждать. Иногда помогает. Но начинать я предлагаю не с этого. Сначала стоит потратить две недели на чужую видимость: взять бренды, которые нейросети уже рекомендуют, и разобрать, на каких запросах, с какими характеристиками и с опорой на какие источники они там оказались. Это дешевле любой переделки сайта и на выходе даёт список задач, а не список предположений.
В ответах нейросетей у вас другой состав конкурентов, чем в поисковой выдаче
Первое, что ломает ожидания клиента: набор брендов в ответе часто не совпадает с топом Яндекса и Google. По нашей агентской выборке за год примерно в половине проектов хотя бы один бренд из ответа нейросети клиент вообще не считал своим прямым конкурентом. У региональной сети клиник в ответах всплывали федеральные агрегаторы и телемедицина, у B2B-производства - инжиниринговые подрядчики из соседнего сегмента, которые просто подробно описали отраслевые задачи у себя на сайте и в профильной прессе.
Объяснение приземлённое: модель собирает короткий список из тех, про кого ей есть что сказать применительно к формулировке вопроса. Не самый сильный на рынке, а самый описанный понятными ей словами. Поэтому список конкурентов для GEO собирается отдельно и только из ответов.
- Взять 40-60 формулировок, которыми покупатель описывает свою задачу, а не ваш продукт
- Прогнать их по каждой нейросети отдельно и выписать все названия брендов из ответов
- Посчитать, в какой доле ответов встречается каждый бренд, и оставить тех, кто попадает регулярно
- Повторить прогон через неделю: разовые попадания отсеются, устойчивые останутся
- Сверить список с коммерческим отделом: часть брендов окажется неожиданной, и это самая полезная часть разговора
Рекомендации приносят не общие вопросы, а запросы с условием
Второе наблюдение: бренды распределяются по типам вопросов очень неровно. На общем «кто делает X» в ответе чаще оказываются крупные известные игроки и подборки из медиа. Как только в вопросе появляется условие - бюджет, город, отрасль, срок, формат работы - состав меняется, и туда попадают компании поменьше. Обычно именно там и есть место для клиента.
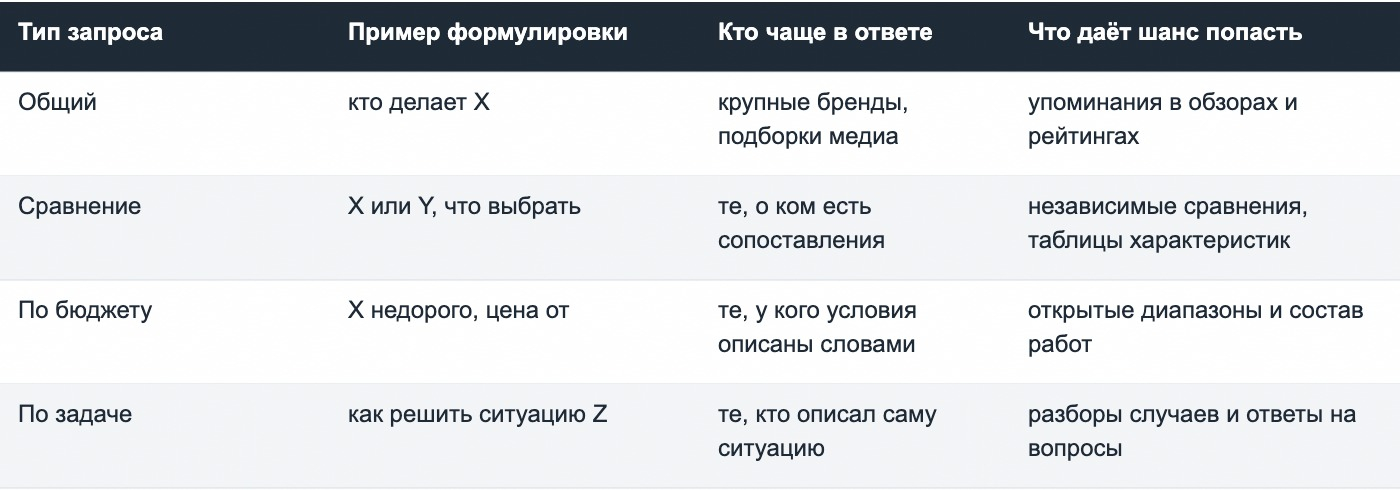
Поэтому доля рекомендаций считается по группам запросов, а не целиком. Средняя цифра по проекту прячет ровно то, что нужно знать: в какой группе можно сдвинуться за квартал, а в какой придётся работать год.
Что именно сказано про конкурента и на что при этом ссылается ответ
Дальше мы читаем не список имён, а сами формулировки. Это скучная ручная работа, у нас она занимает 6-8 часов на проект, и она даёт больше, чем любая сводная метрика. Фиксируем по каждому ответу:
- какие характеристики бренда повторяются: сроки, гарантия, своё производство, отрасли, регион
- в каких ситуациях бренд рекомендуется, а в каких исчезает из ответа
- какие ссылки приводятся рядом: сайт компании, каталог, рейтинг, отраслевое издание, форум, отзовик
- какая тональность: нейтральное перечисление или оценочная формулировка
- что сказано про вас, если вы упомянуты: часто обнаруживается не отсутствие, а устаревшее или неточное описание
Важная рамка, которую я проговариваю и клиенту, и своей команде: это наблюдения над ответами, а не доказательство внутренней логики модели. Мы видим, что повторяется в ответах и что цитируется, и работаем с этим как с корреляцией. Утверждать, что модель выбрала бренд именно за гарантию из второго абзаца, нельзя, и в договор такие формулировки лучше не записывать.
Что это значит для российского рынка
У нас разбор приходится вести минимум в двух контурах. ChatGPT, Gemini и Perplexity опираются в основном на то, что доступно им на вашем языке и в вашем сегменте интернета. Поиск с Алисой и Чат с Алисой ведут себя иначе и чаще цитируют российские каталоги, отзовики, маркетплейсы и отраслевые издания, GigaChat даёт свой состав. Бренд может быть заметен в Алисе и отсутствовать в ChatGPT, и наоборот. Это два разных плана работ, и сводить их в одну цифру отчёта я не советую.
Второе следствие: российские внешние площадки весят здесь больше, чем принято думать в SEO. Отраслевые медиа, профильные каталоги, тематические рейтинги и обзоры в большинстве наших разборов дают заметную часть цитирований по коммерческим вопросам. Если конкурент присутствует в пяти таких местах, а вы в одном, начинать стоит не со своего блога.
Разбор превращается в план из четырёх списков
Под клиентские замеры я беру GEO-сервисы мониторинга, чтобы не прогонять десятки запросов руками: например, brandfound прогоняет запросы по десяти нейросетям, включая оба режима Алисы, и показывает тональность и источники каждого ответа. Рядом смотрю VisioBrand, PixelTools: набор моделей, регионов и выгрузок у них разный, поэтому любой сервис стоит прогонять по своему чек-листу требований, а не брать по описанию. Руками тоже можно, но 50 запросов по пяти моделям с повторами в рабочий день уже не укладываются.
- сведения о компании, которые надо дописать на сайте простыми словами: отрасли, регионы, сроки, границы работ, условия
- вопросы покупателя, раскрытые у конкурентов и не раскрытые у вас: по одному материалу на вопрос, без общих статей
- внешние площадки, где конкурент есть, а вас нет: каталоги, рейтинги, отраслевые медиа, обзоры
- неточности о вас в ответах: их правят через источники, которые цитируются, а не обращением к модели
Замер после этого устроен просто: фиксированная группа запросов, одинаковая для вас и для отобранных конкурентов, прогон раз в неделю и чаще по избранным, и три цифры по каждой нейросети отдельно. Доля ответов с упоминанием бренда, доля ответов, где бренд попал в рекомендацию, и доля ответов, где цитируется ваш источник. Сравнивать себя только с собой месяц назад мало: если просело у всех после обновления модели, это не ваша работа, а если конкурент вырос на той же группе запросов, стоит посмотреть, что он за этот месяц опубликовал.
Возвращаясь к тому созвону. На вопрос «почему тут они, а нас нет» у меня теперь есть ответ не в виде рассуждения про AI-видимость, а в виде четырёх списков: что дописать, что раскрыть, где опубликоваться, что исправить. Собираются они из чужих ответов, и это редкий случай, когда половину исследования конкурент делает за вас.