Чек-лист выбора GEO-платформы: 12 вопросов, которые стоит задать на демо
Демо GEO-платформы устроено так, что отказаться трудно: на экране карта упоминаний, зелёные стрелки, доля голоса против конкурентов, сорок метрик и красивый PDF. Через две недели работы выясняется, что бренда в ответах ассистентов по-прежнему нет, а почему его нет, сервис не говорит. Разберём по порядку, какие вопросы на демо отличают инструмент от презентации.
Это не рейтинг и не сравнение поставщиков, а список вопросов, который стоит держать перед глазами на звонке, каким бы ни был поставщик. Вопросы собраны в четыре группы: замер, доверие к данным, действие после цифры, деньги и выход. Внутри каждой по три вопроса, и почти к каждому есть ответ, после которого продолжать разговор не обязательно.
Короткая версия, которую можно скопировать в блокнот перед звонком:
- Сколько нейросетей опрашивается и какие именно.
- Как часто обновляется замер и можно ли следить за избранными запросами чаще.
- Сколько ответов в выборке за период и где это число видно.
- Показывается ли сырой ответ модели целиком и со ссылками.
- Как считается тональность и по каким шкалам.
- Воспроизводится ли замер при повторном прогоне того же запроса.
- Объясняет ли сервис, почему бренда нет в ответе.
- Приоритизирует ли он источники, на которые опираются модели.
- Делает ли план контента и сами материалы, и кто отвечает за факты в них.
- Как проверяется эффект публикации и виден ли момент первого появления статьи в ответах.
- Как считается трафик из нейросетей и отделяется ли синтетика.
- За что именно вы платите, какие есть лимиты и как забрать свои данные.
Группа первая: из чего собран сам замер
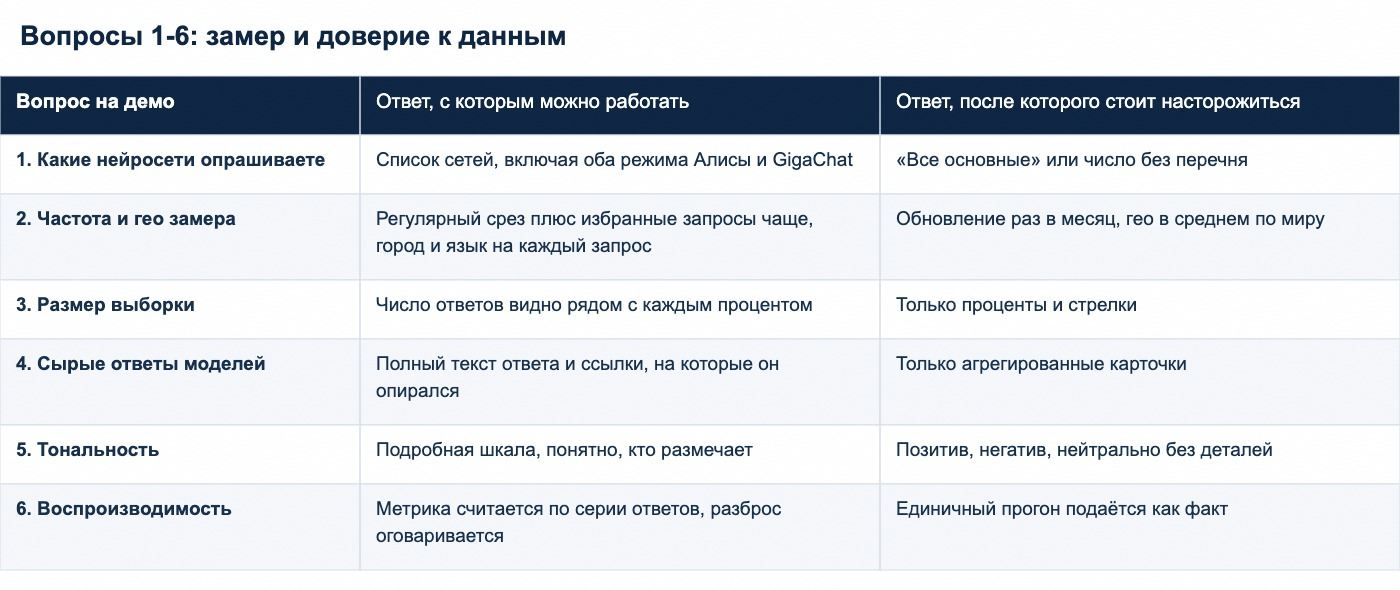
Вопрос 1. Сколько нейросетей опрашивается и какие именно. Не число, а список. Десять западных моделей не закрывают российский рынок: если в перечне нет Алисы в обоих режимах и GigaChat, вы меряете не ту аудиторию, которая вас покупает. Обратная ситуация тоже бывает: сервис с перекосом в РФ не видит, что отвечает ChatGPT. Ответ «восемь моделей» без объяснения, каких именно и почему, это повод уточнять дальше.
Вопрос 2. Как часто обновляется замер и можно ли следить за частью запросов чаще остальных. Ответы ассистентов переписываются постоянно, и недельный срез в конкурентной нише вроде телекома или IT устаревает раньше, чем доезжает до совета директоров. Хороший ответ звучит так: регулярный замер по всему набору плюс избранные запросы с частотой до часа. Отдельно спросите про гео и язык: можно ли задать город и страну на каждый запрос, или всё считается в среднем по миру.
Вопрос 3. Сколько ответов собрано за период и где это число видно в интерфейсе. Это главный вопрос всей группы. Доля упоминаний на выборке в 26 ответов и на выборке в 505 ответов это разные по надёжности цифры, но на графике они выглядят одинаково убедительно. Если размер выборки не показывается рядом с процентом, вы будете принимать решения по шуму: один ответ в любую сторону на малой выборке двигает долю на несколько процентных пунктов.
Группа вторая: можно ли этим цифрам верить
Вопрос 4. Покажите сырой ответ модели целиком. Не карточку с процентом, а текст, который выдал ассистент, и ссылки, на которые он сослался. Здесь выясняются две неприятные вещи: бренд иногда «упомянут» в составе чужого перечисления, а источником цитирования оказывается форум пятилетней давности. Если сырых ответов в интерфейсе нет, проверить метрику вы не сможете никогда.
Вопрос 5. Как считается тональность. Спросите про шкалы и про то, кто их размечает. Бинарное деление на позитив и негатив для брендов почти бесполезно: ответ «дорого, но надёжно» не позитив и не негатив, а конкретное возражение, с которым работают текстами. Чем подробнее шкала, тем полезнее данные, и тем важнее понимать, модель это размечает или человек.
Вопрос 6. Воспроизводится ли замер. Попросите прогнать один и тот же запрос дважды при вас. Ответы моделей недетерминированы, и разброс это нормально; ненормально, когда поставщик об этом не предупреждает и подаёт единичный прогон как факт. Хороший ответ: «разброс есть, поэтому метрика считается по серии ответов, а не по одному». Это свойство измерения, а не канала, и честный сервис говорит об этом сам.
Группа третья: что сервис делает после того, как показал цифру
Вопрос 7. Объясняет ли сервис, почему бренда нет в ответе. Факт отсутствия вы и так видите. Полезен разбор: по этому запросу модель опирается на три обзора и один маркетплейс, вас там нет, а конкурент упомянут в двух из трёх. Многие платформы фиксируют цитирование, но причину не разбирают, и тогда работа с метрикой упирается в догадки.
Вопрос 8. Приоритизирует ли он источники. Ответ ассистента собирается из конкретных страниц, и их важность разная. Хороший сервис показывает, на какие домены модели опираются чаще по вашей теме, и сортирует их по влиянию, а не выдаёт алфавитный список ссылок. Это та часть, которую нельзя заменить SEO-отчётом: в поиске и в ответе ИИ цитируются разные страницы.
Вопрос 9. Делает ли он план контента и сами материалы, и кто отвечает за факты. Здесь важно поймать границу. Автоматический план и черновики экономят недели, но ответственность за утверждения от имени бренда остаётся на вас. Спросите прямо: есть ли факт-чекинг, подсвечиваются ли неуверенные места, можно ли отредактировать текст до публикации. Конвейер, который публикует сам, рано или поздно напишет от вашего имени то, за что придётся извиняться.
Группа четвёртая: проверка эффекта, трафик и деньги
Вопрос 10. Как проверяется эффект публикации. Нужен не отчёт «статья вышла», а связка: материал опубликован тогда, впервые появился в ответах ассистентов через столько дней, доля упоминаний по этой группе запросов изменилась так. Без фиксации момента первого появления вы не отличите результат публикации от фонового колебания моделей.
Вопрос 11. Как считается трафик из нейросетей и что с синтетикой. Переходы из ассистентов плохо видны в обычной аналитике, и этим легко воспользоваться в отчёте. Спросите, как сервис размечает такие визиты, видно ли их поведение и конверсии, есть ли детектор синтетики. Без разделения живых визитов и ботов рост переходов можно принять за результат работы, хотя часть его может оказаться накруткой или обходом страниц.
Вопрос 12. За что вы платите, какие лимиты и как забрать данные. Три вещи, которые выясняются уже после подписания договора: сколько брендов и пользователей входит в тариф, что происходит при превышении числа запросов, и можно ли выгрузить историю замеров и получить доступ по API. Подписка за доступ к графикам и авансовая оплата за выполненные операции дают очень разные счета при одном и том же объёме работы, и считать нужно под свой объём.
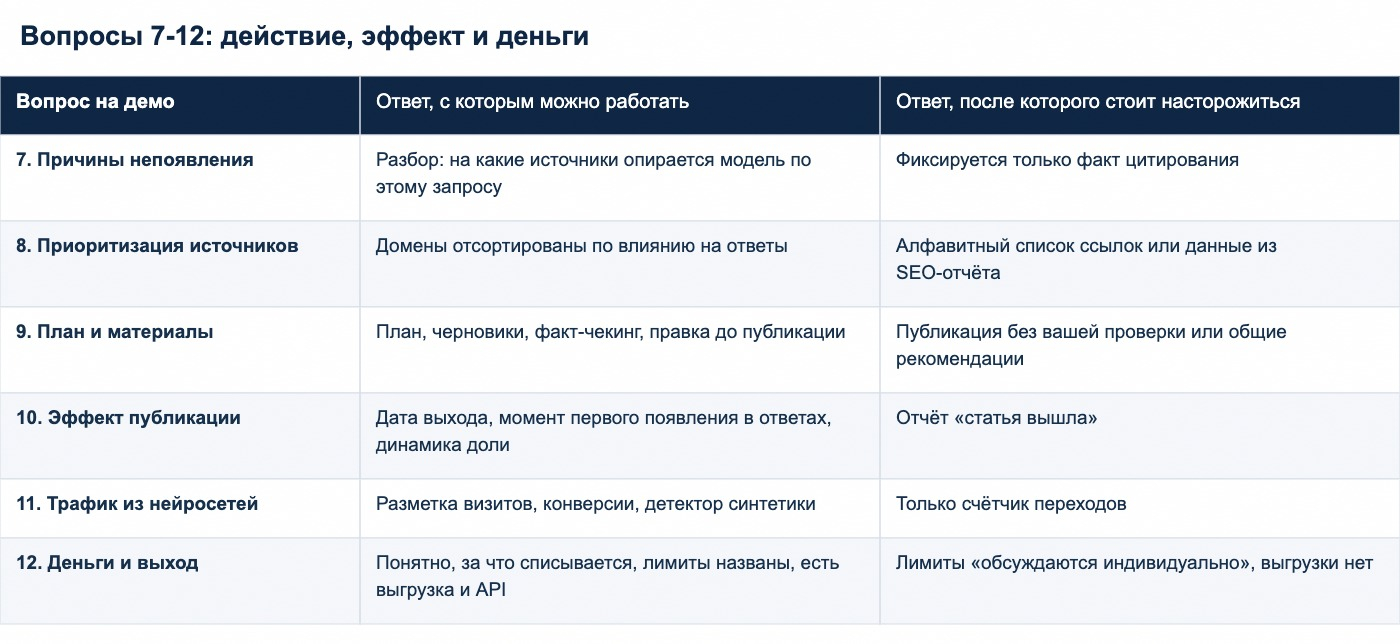
Содержание таблиц коротко, чтобы его можно было прочитать и без картинок. В первой половине чек-листа отсеиваются сервисы, в которых цифру нельзя проверить: нет перечня сетей, не видно размера выборки, нет сырых ответов. Во второй половине отсеиваются те, у которых после цифры не следует действия: причины не разбираются, источники не приоритизируются, эффект публикации не фиксируется, а условия тарифа обсуждаются индивидуально.
Что это значит для российского рынка
Половину вариантов снимают первые три вопроса, и почти всегда по одной причине: охват без российских ассистентов. Такой замер делают профильные GEO-сервисы мониторинга: например, brandfound отслеживает упоминания бренда в десяти нейросетях, включая оба режима Алисы AI, с тональностью и источниками каждого ответа. Для чек-листа важно не число сетей само по себе, а то, что по нему проверяется честность остальных ответов на демо: сервис, который не называет перечень моделей, обычно и выборку не показывает.
Вторая российская особенность касается вопроса 11. Переходы из ассистентов у нас плохо размечаются стандартными счётчиками, поэтому сверять данные сервиса придётся с Метрикой и серверными логами. Если поставщик обещает точный трафик из нейросетей и при этом не объясняет, как он отличает живой визит от обхода страниц, цифру лучше считать оценочной.
И третье. На демо почти никогда не показывают неудачный пример, а он самый полезный. Попросите открыть запрос, по которому ваш бренд не упоминается, и разобрать его при вас. Отказ в этом месте говорит о сервисе больше, чем сорок метрик на первом слайде.
Частые вопросы про выбор GEO-платформы
Вернёмся к тому демо с сорока метриками. Ни один из двенадцати вопросов не про красоту интерфейса, и это не случайно: интерфейс вы увидите сами, а проверяемость данных и наличие следующего шага на слайдах не видны. Спрашивайте про выборку, сырые ответы и причины непоявления; показы покупаются, рекомендации зарабатываются, и вторые теперь тоже измеримы, если измерение можно проверить.