Как попасть в ответы ChatGPT, Perplexity и Google через Reddit в 2026 году
Ещё недавно бренды сражались за первую строчку в поиске. Сегодня всё больше людей получают готовый ответ прямо в блоке нейросети и до списка ссылок просто не доходят. Откуда нейросеть берёт этот ответ?
Во многом из живых обсуждений, и Reddit входит в число её самых любимых источников. Мы в uForce проверили это на AI-сервисе для учёта и налоговой отчётности. За 35 дней публикации о сервисе собрали 247 300 прочтений при плане 200 000, а сами обсуждения начали появляться в ответах Google AI Overviews, Perplexity и ChatGPT Search.
Рассказываем, как мы выбирали темы, инициировали обсуждения и проверяли, что о сервисе говорят поисковики и нейросети. Если интересны статьи о неочевидных способах продвижения, заходите на наш сайт.
Коротко в цифрах
- 247 300 прочтений за 35 дней при плане 200 000, то есть 124% от KPI
- 35 дней на выполнение задачи вместо запланированных 40
- 12 публикаций при плане 10
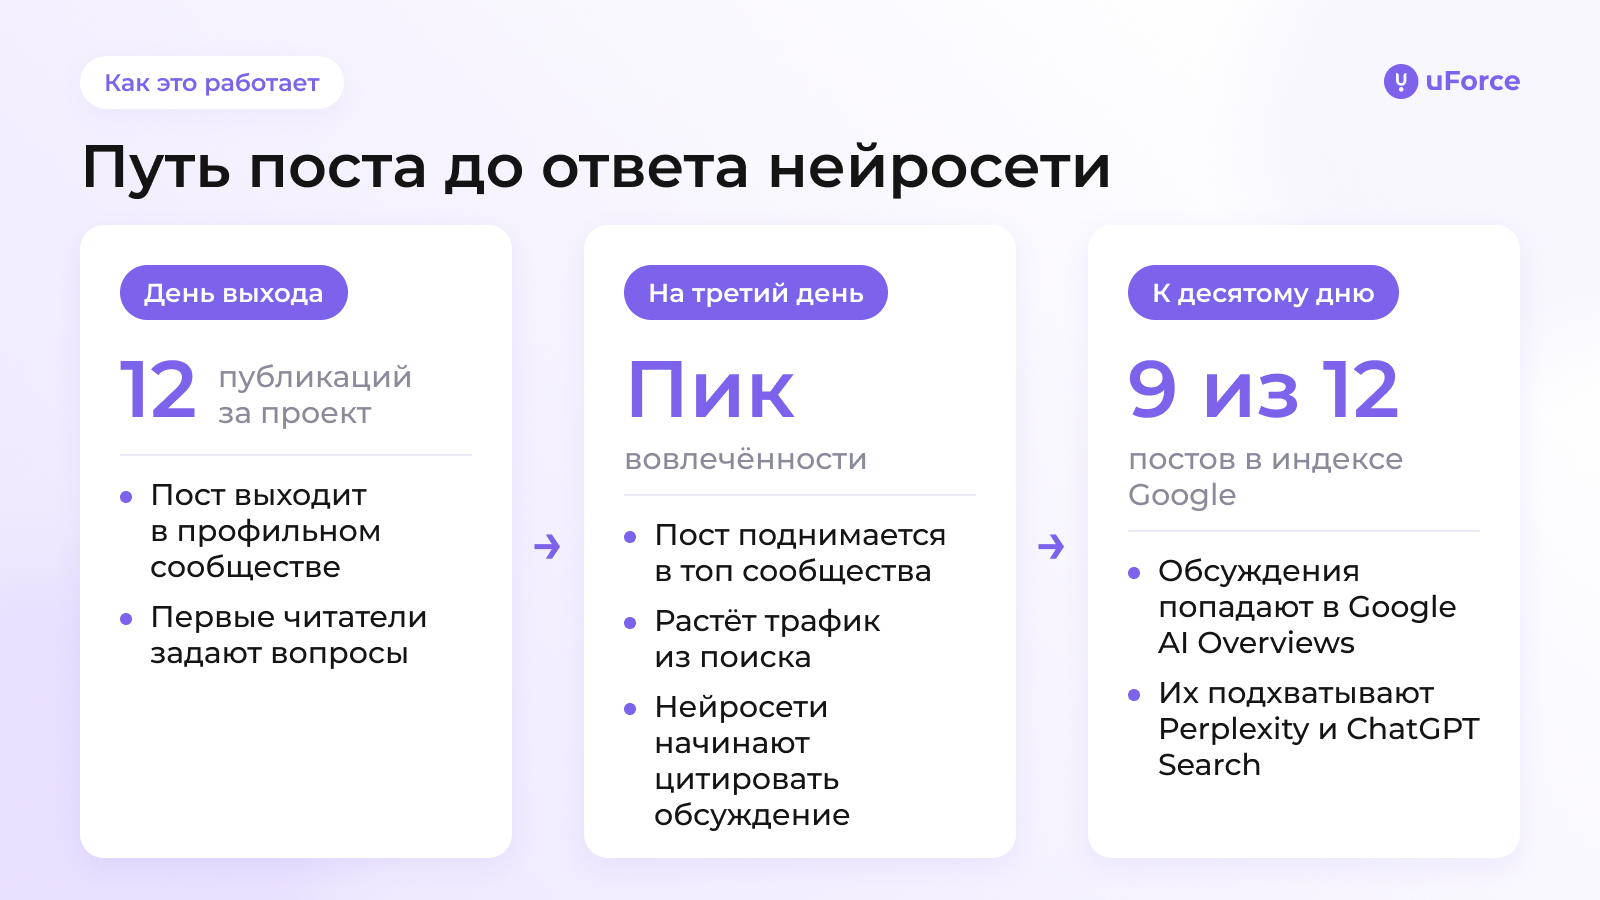
- 9 из 12 постов попали в индекс Google в срок от 7 до 10 дней после выхода
- Публикации стали появляться в ответах Google AI Overviews, Perplexity и ChatGPT Search
- 0 удалённых веток и 0 токсичных реакций за весь проект
Почему нейросети так охотно читают Reddit
Для тех, кто на Reddit не заглядывает, коротко объясним, как он устроен. Площадка состоит из тысяч тематических сообществ, их называют сабреддитами. В каждом люди публикуют посты, спорят в комментариях и голосуют за то, что им показалось полезным.
Чем больше голосов «за», тем выше обсуждение поднимается в ленте сообщества и тем больше людей его видит. Если совсем по-домашнему, Reddit похож на огромный районный форум, где соседи советуют друг другу проверенного сантехника и предупреждают, у кого течёт крыша. Только район там размером с полмира, а советуют не сантехников, а сервисы, банки и способы сдать налоговую декларацию без нервов.
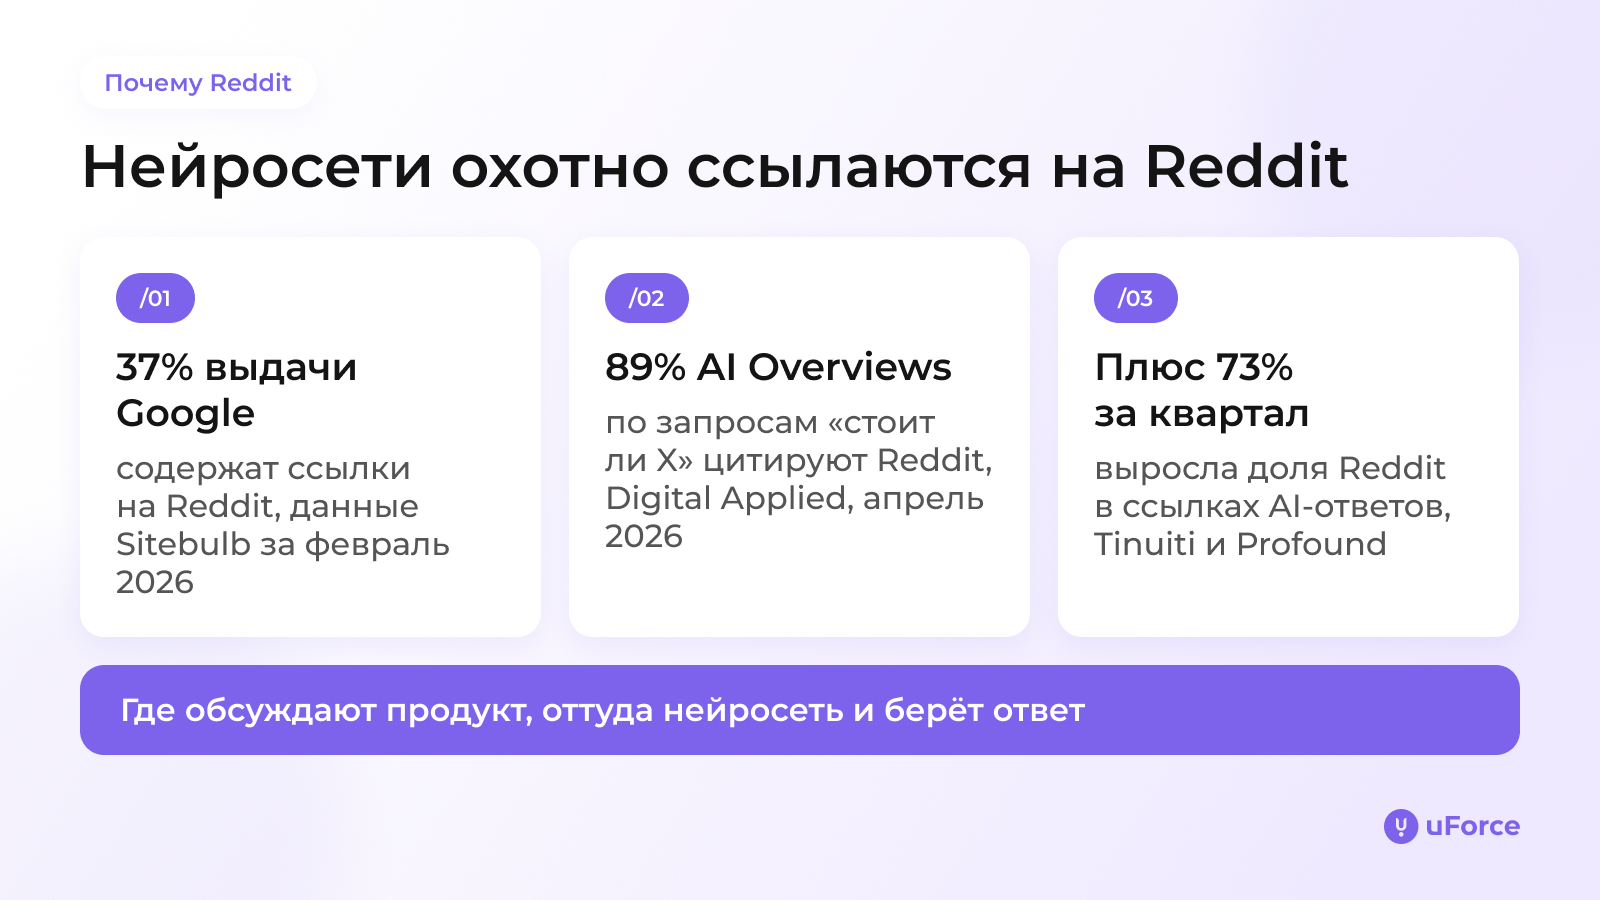
Именно такие советы и нужны нейросетям. Исследователи Sitebulb в феврале 2026 года посчитали, что Reddit появляется в 37% поисковой выдачи Google и в 95% выдачи по запросам об отзывах на продукты. Digital Applied в апреле 2026 года выяснили, что Reddit цитируется в 89% блоков Google AI Overviews по запросам вида «стоит ли X» и в 57% запросов «лучшее X для Y». А по оценке Tinuiti и Profound за первый квартал 2026 года доля Reddit среди источников, на которые ссылаются AI-ответы, выросла за один квартал на 73%.
Вывод отсюда простой. Когда о продукте говорят в профильных обсуждениях на Reddit, у нейросети появляется материал, из которого она соберёт ответ с его упоминанием. Если о продукте молчат, нейросеть расскажет про кого-нибудь другого.
С какой задачей пришёл клиент
Наш клиент разрабатывает AI-сервис для учёта и налоговой отчётности на британском рынке. Сервис сам собирает операции пользователя, считает налоги и готовит отчёты под требования HMRC, британской налоговой службы. Если упростить, он берёт на себя ту часть работы, которую человек обычно откладывает до последней недели перед дедлайном, а потом проводит над ней десятки часов с калькулятором и таблицами.
Клиент хотел, чтобы о сервисе заговорили в сообществах Reddit, где обсуждают налоги, и чтобы эти обсуждения попадали в Google, Perplexity и ChatGPT по запросам аудитории.
Кого мы хотели найти
Аудитория сервиса ведёт налоговую отчётность сама и очень не любит ошибаться. Ошибка в налогах стоит дорого, ведь за ней следуют штраф, переписка с налоговой и испорченные выходные. Т
акие люди активно ищут решения, но к любому намёку на рекламу относятся настороженно, а прямое упоминание продукта воспринимают как попытку что-то продать. Вы, скорее всего, тоже охотнее поверите совету человека, который прошёл через ту же бумажную волокиту, чем рекламному объявлению бухгалтерской программы.
Как мы договорились считать успех
Мы зафиксировали с клиентом три ориентира. Первый касался охвата, публикации должны были собрать не меньше 200 000 прочтений за 40 дней. Второй ориентир касался объёма работы, на старте мы планировали 10 публикаций. Третий был самым интересным, ведь нам нужно было попасть в ответы трёх систем, а именно Google, Perplexity и ChatGPT, по запросам европейской аудитории о налогах.
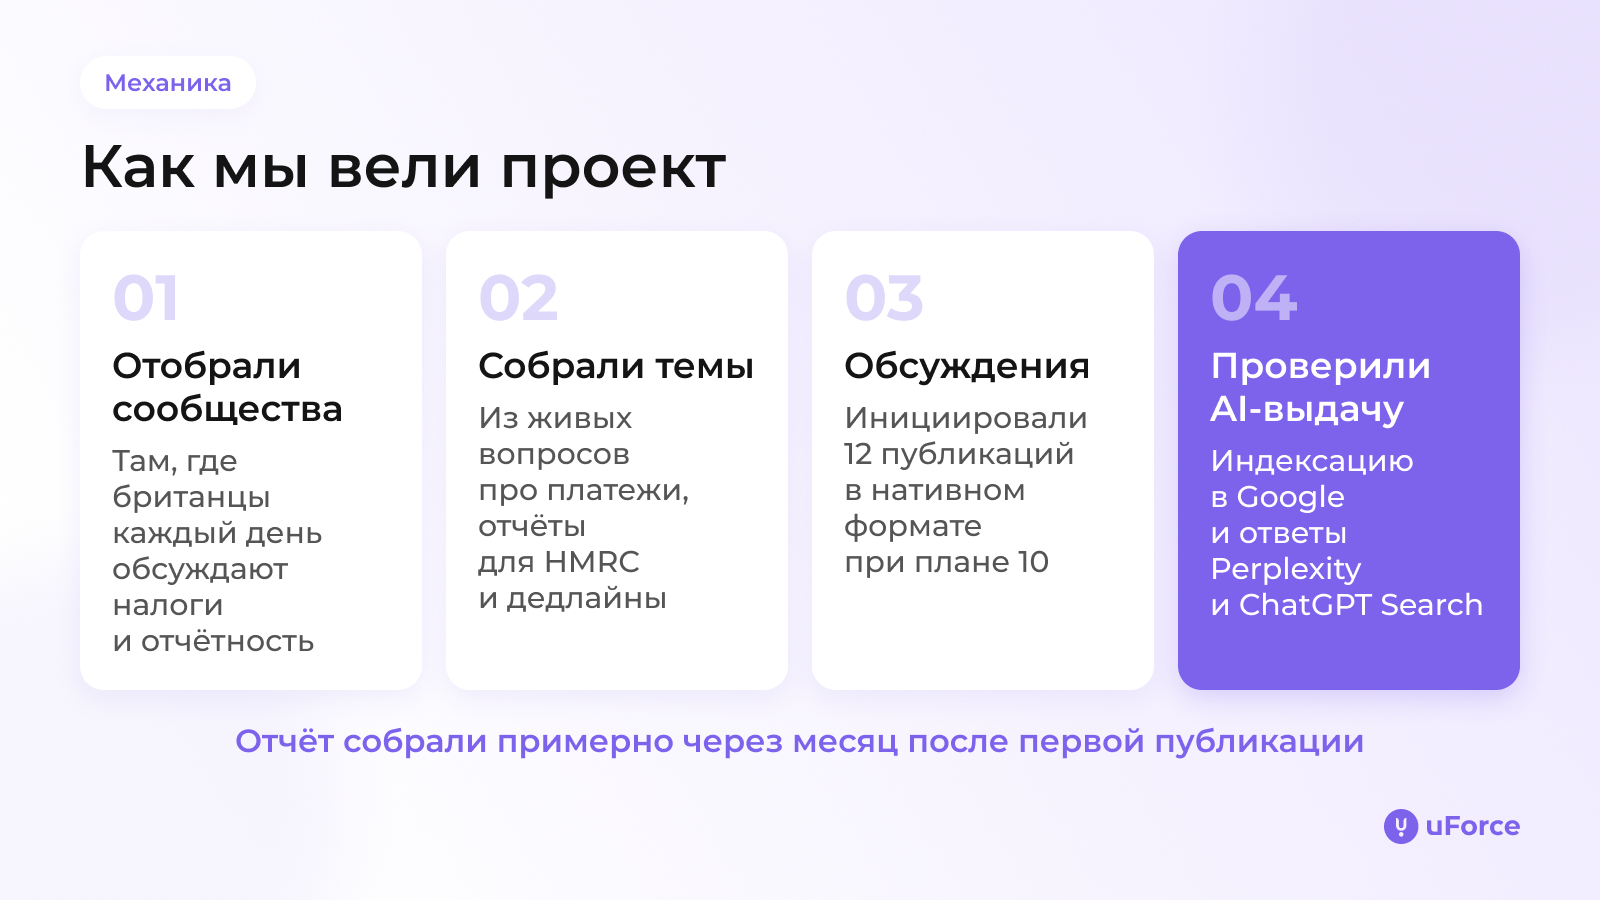
Шаг 1. Ищем сообщества, где европейцы говорят о налогах
Начали мы с анализа тематических сообществ Reddit. Нас интересовали те, где люди обсуждают налоги, отчётность и деньги, и в каждом мы смотрели, насколько активно там пишут, вовлекаются ли участники в обсуждения или только читают и совпадает ли аудитория сообщества с теми, кому нужен сервис клиента.
Активность здесь важнее размера. Сообщество может включать сотни тысяч подписчиков, но если последнее живое обсуждение в нём случилось неделю назад, пост там повиснет в тишине.
В оживлённом сообществе новая ветка подхватывается сразу, туда приходят с вопросами и готовностью поделиться собственным опытом, и такие ветки потом собирают трафик из поиска. Поэтому в итоговый список мы взяли сообщества, где разговор о налогах ведут каждый день.
Шаг 2. Собираем темы из живых вопросов
Дальше мы выбирали темы. Нам нужны были такие поводы для обсуждения, которые европейцы и так поднимают сами, без всякого участия бренда. Мы искали боли, о которых люди пишут годами.
Из этих болей мы собрали темы-зацепки. Каждая отвечала на вопрос, который человек мог бы задать соседу по форуму, и в каждой разговор естественно доходил до того, как сервис упрощает учёт. Такие темы хороши ещё и тем, что совпадают с формулировками, которые люди вводят в поиск и задают нейросетям. Человек пишет в ChatGPT почти то же самое, что спросил бы в сообществе, поэтому ветка с ответом на этот вопрос хорошо подходит нейросети в качестве источника.
Шаг 3. Инициировали комментарии, на которые хотелось ответить
Сервис упоминался внутри обсуждения тогда, когда он был уместен по смыслу, примерно так, как вы между делом советуете знакомому приложение, которое сами давно используете. Главная задача текста состояла в том, чтобы вызвать разговор.
Если пост просто сообщает о продукте, комментировать там нечего, а если в нём есть понятная ситуация и открытый вопрос, люди начинают делиться своим опытом.
Хорошо работали посты, где автор разбирает свою ситуацию с налогами и делится опытом. Такие публикации собирали заметно больше откликов, чем прямой рассказ о продукте. Все тексты мы согласовывали с клиентом заранее, и клиент принял их с первой итерации, не внеся ни одной правки.
Длинный пост или короткий?
Мы тестировали оба формата. Длинные посты подходят для разбора, когда автор подробно описывает ситуацию, перечисляет варианты и спрашивает совета у сообщества. Короткие хороши, когда нужно быстро задать вопрос и дать людям возможность ответить.
Можно чередовать разборы конкретных случаев, вопросы к сообществу и сравнения подходов. Разнообразие помогает обсуждениям выглядеть естественно, ведь в живом сообществе посты одной длины и одного тона подряд не встречаются.
Шаг 4. Запускаем обсуждения и слушаем реакцию
Затем мы инициировали публикации и обсуждения в профильных сообществах, и вместо запланированных 10 их вышло 12. После выхода каждого поста команда следила за реакцией аудитории.
Модерация на Reddit строгая. За весь проект модераторы не удалили ни одной ветки, а аудитория не оставила ни одной токсичной реакции. Для нас этот результат важен так же, как охват.
Шаг 5. Проверяем, что отвечают поисковики и нейросети
Параллельно с публикациями мы следили за тем, как посты попадают в поиск. Мы регулярно проверяли индексацию в Google и задавали Perplexity и ChatGPT Search те вопросы о налогах, которые задаёт британская аудитория. Смотрели, появляются ли в ответах наши обсуждения и упоминается ли сервис.
Отчёт по итогам мы собрали примерно через месяц после первой публикации, когда посты успели набрать основную часть прочтений, а поисковики и нейросети успели их подхватить. В отчёт вошли охваты, вовлечённость и попадания в AI-выдачу.
Как мы считали результат
Мы смотрели на проект с трёх сторон. Охват считали по прочтениям публикаций и сравнивали с планом в 200 000. Поисковый эффект проверяли по тому, сколько постов попало в индекс Google и как быстро это случилось. Эффект в нейросетях оценивали по появлению наших обсуждений в ответах Google AI Overviews, Perplexity и ChatGPT Search на запросы о налогах.
Почему за удалениями мы следили так же внимательно, как за охватом
Удалённая ветка на Reddit обходится дорого. Вместе с ней пропадают прочтения, исчезает шанс попасть в поиск и в ответы нейросетей, а сообщество запоминает, что здесь пытались что-то продать. Для AI-выдачи это важно, потому что нейросеть может сослаться только на ту ветку, которая продолжает существовать.
Поэтому сохранность обсуждений мы считали отдельным показателем качества. По итогам проекта модераторы не удалили ни одной ветки, и ни одной токсичной реакции мы не зафиксировали.
Что получилось за 35 дней
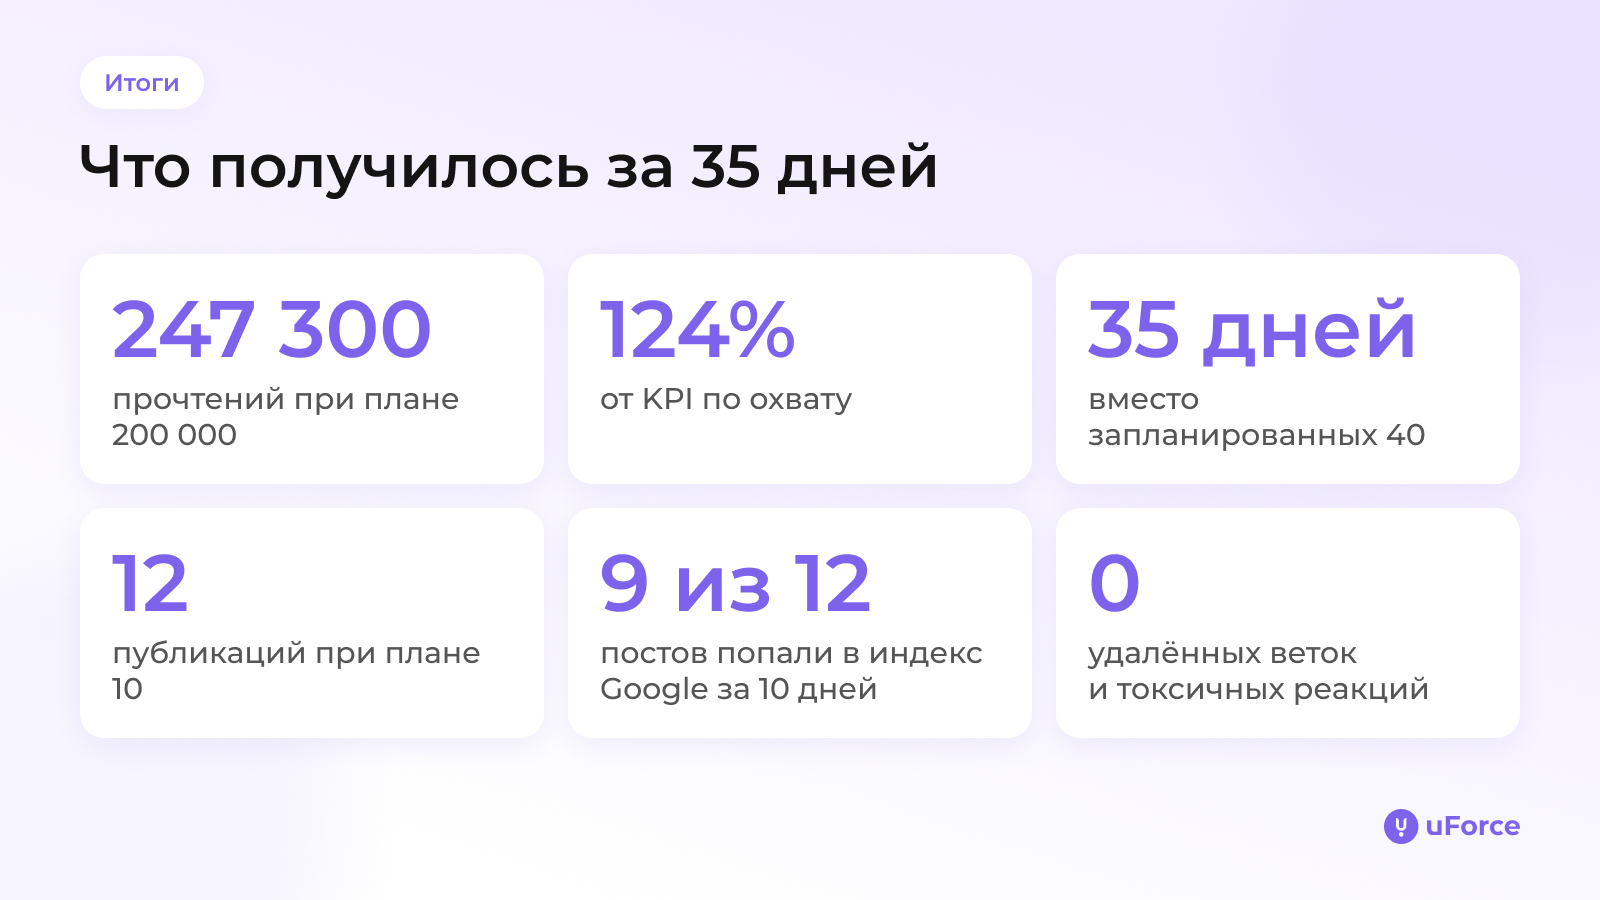
Мы выполнили задачу на пять дней раньше срока. Вместо 40 дней нам понадобилось 35, и за это время 12 публикаций собрали 247 300 прочтений при плане 200 000, то есть план по охвату мы перевыполнили на 24%.
Из 12 постов девять попали в индекс Google в срок от 7 до 10 дней после выхода. Публикации стали появляться в ответах Google AI Overviews, Perplexity и ChatGPT Search по британским запросам о налогах, то есть наши обсуждения дошли до всех трёх систем, которые мы ставили целью.
- 247 300 прочтений при плане 200 000
- 124% от KPI по охвату
- 35 дней вместо 40
- 12 публикаций при плане 10
- 9 из 12 постов в индексе Google
- 0 удалённых веток и 0 токсичных реакций
Почему пик приходится не на день публикации
Ещё одно наблюдение связано со временем. Мы ожидали, что пост наберёт больше всего просмотров в первые часы, но пик вовлечённости пришёлся на третий-пятый день после выхода.
Тогда пост поднимался в топ сообщества за счёт апвоутов, или голосов участников, и начинал собирать органический трафик из поиска. В эти дни мы фиксировали основную часть прочтений и первые цитирования в AI-выдаче.
Поэтому оценивать Reddit-публикацию в день выхода бессмысленно, ей нужно дать несколько дней, чтобы сообщество её подхватило. Если бы мы снимали результаты на следующий день после публикации, то увидели бы лишь малую часть эффекта и, вероятно, сделали бы неверные выводы о темах.
Что мы вынесли из проекта
Тема важнее упоминания. Налоги оказались удачным поводом для разговора, потому что люди активно ищут решения и охотно обсуждают свой опыт. Когда тема цепляет, бренд естественно вписывается в разговор, и его упоминание выглядит уместным советом.
Опыт работает лучше рекламы. Посты, где автор разбирает свою ситуацию, собирали больше откликов, чем прямой рассказ о продукте. Аудитория, которая настороженно встречает любой намёк на продажу, охотно отвечает на понятную историю.
Результат нужно ждать несколько дней. Пик пришёлся на третий-пятый день после публикации, и тогда же появились первые цитирования в нейросетях. Поэтому мы закладываем время на сбор статистики и не делаем выводов по первым часам.
Сохранность ветки дороже лишнего охвата. Нейросеть может сослаться лишь на то обсуждение, которое продолжает жить. Поэтому за сохранностью веток мы следили так же пристально, как за прочтениями, и за весь проект не потеряли ни одной.
Звучит как набор очевидных вещей? Отчасти так и есть. Только результат здесь складывается как раз из таких очевидных вещей, если не пропускать ни одну из них.
Кому подойдёт такой формат
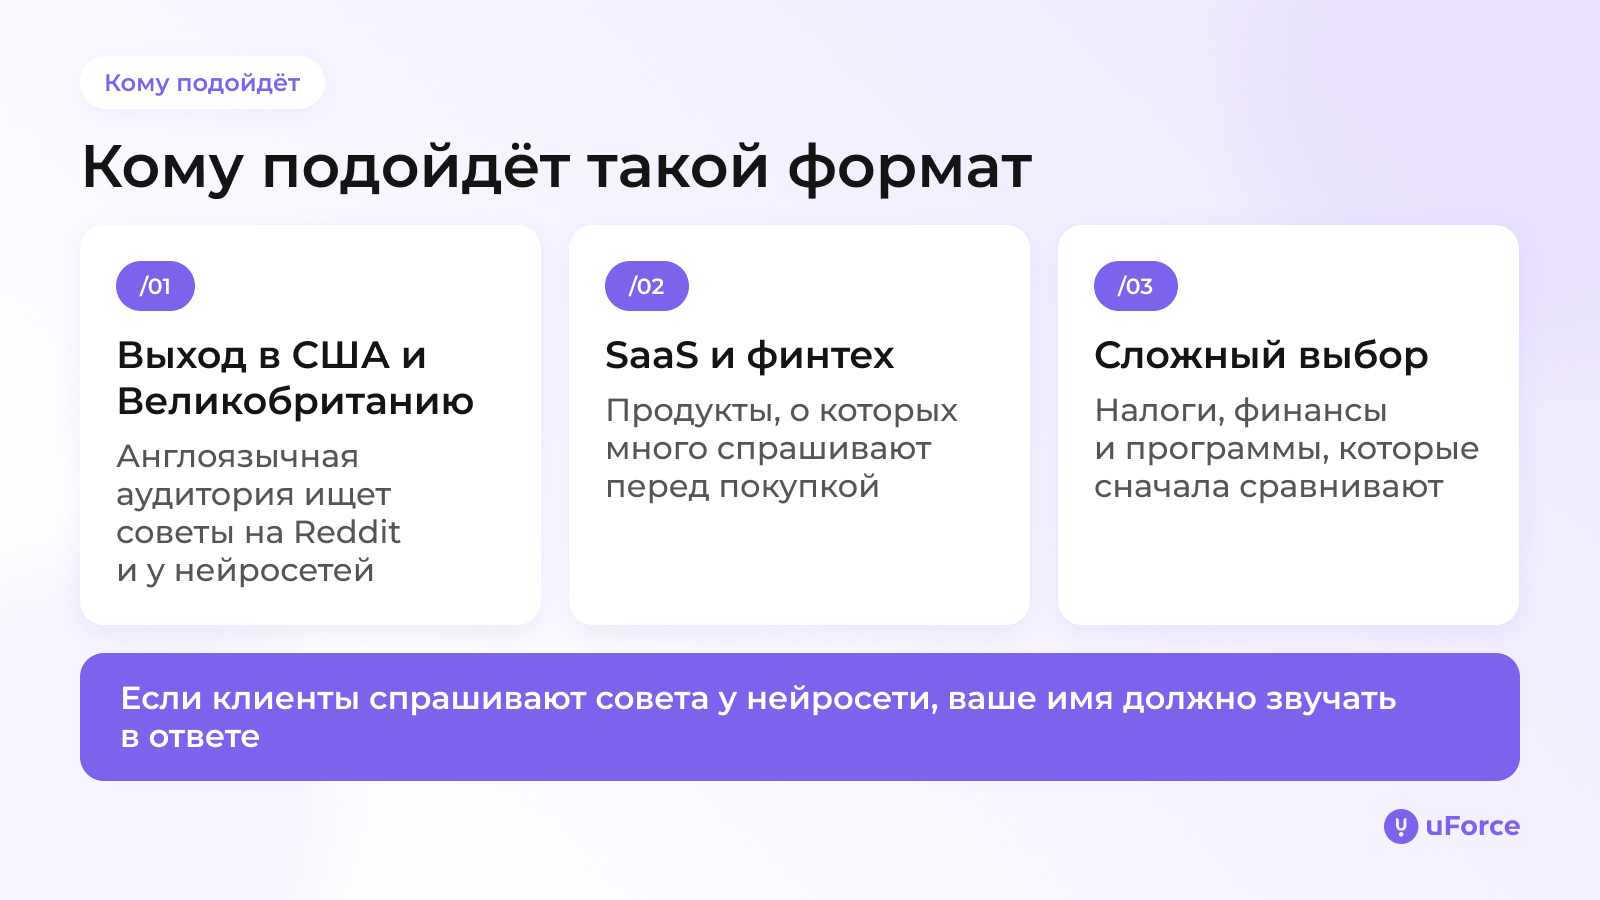
Обсуждения на Reddit с прицелом на AI-выдачу особенно полезны компаниям, которые выходят на англоязычные рынки, прежде всего в США и Европу. Формат хорошо работает для SaaS-сервисов, финтеха и продуктов, вокруг которых у людей много вопросов перед покупкой.
Это налоги, финансы, программы для работы, технические продукты и всё, что человек сначала изучает и сравнивает, а потом покупает. Если ваши клиенты перед покупкой спрашивают совета у нейросети или у сообщества, стоит позаботиться о том, чтобы в этих ответах звучало и ваше имя.
Если хотите попадать в ответы нейросетей, напишите нам на сайт, и мы подберём подход под вашу нишу.
Если кейс оказался полезным, поставьте лайк, нам будет приятно. Заходите в наш Telegram-канал, а также в канал нашего сооснователя. Там мы регулярно разбираем такие механики и способы их измерить.