Ловушка ИИ-текстов. Почему проверка фактов в B2B обходится дороже ручной работы
Внедрить ИИ в работу компании просто. Но в таких технически сложных сегментах рынка как промышленное оборудование, металлопрокат, строительство, цена фактологической ошибки измеряется серьезными финансовыми потерями. Это сорванные сделки, рекламации и судебные издержки. Для поставщиков, которые обслуживают крупных клиентов и заключают много договоров, на кону стоит еще и репутация.
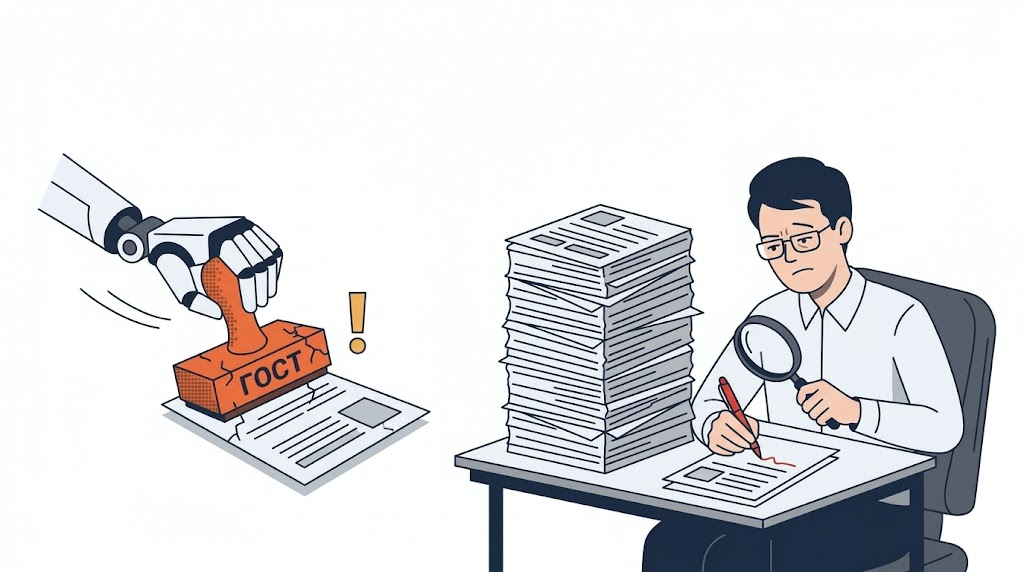
Когда для бизнеса критичны галлюцинации нейросетей
В потребительском маркетинге стилистические вольности искусственного интеллекта допустимы. Там ИИ помогает быстро создать десятки вариантов текста за несколько секунд. Потому цена случайной ошибки невелика. Однако в B2B-каталогах и технических описаниях требования к точности передачи фактов выше.
Чат-боты, AI-агенты и другие сервисы генерации текста оперируют вероятностным распределением токенов. У них нет инженерной логики, они не понимают физику процесса, а лишь предсказывают правдоподобное продолжение фразы. Поэтому текст выглядит безупречно с точки зрения синтаксиса, но часто содержит критические искажения в сущностях. ИИ умеет писать связно, предлагает интересные варианты. Но выбирает всегда бизнес, знающие реальные факты.
Типичные зоны риска в спецификациях:
- Устаревшие или вымышленные стандарты: подмена действующих ГОСТ на отмененные редакции либо придумывание несуществующих ТУ;
- Несоответствие физико-механических свойств: путаница в марках конструкционных сталей, температурных диапазонах, классах инструментов;
- Изменение размерных сеток: погрешности в шаге резьбы, толщине стенки трубы или пропускной способности запорной арматуры;
- Несуществующие комплектации: представление функций и опций, отсутствующих в заводском паспорте продукта.
Для профессионального закупщика или инженера-снабженца подобное искажение информации является маркером некомпетентности поставщика. Клиент не вступит в диалог с отделом продаж. Бизнес потеряет контракт еще на этапе изучения спецификации. Один неаккуратный черновик способен перечеркнуть сделку раньше, чем начнутся переговоры.
Насколько точно выполняют рутинные задачи современные генеративные модели
Прямого бенчмарка по точности генерации для стандартов, ТУ или каталогов промышленного оборудования не существует. Об этом стоит сказать прямо. Разработчики нейросетей часто говорят про качество на своих примерах. Но бизнесу важнее качество на собственных задачах.
Публичные исследования показывают, что частота искажений зависит от вида работы и выбранного инструмента. В сферах с нормативными требованиями нельзя ориентироваться на средние показатели из чужих отчетов. Компании нужно испытать нейросеть на собственных материалах и определить допустимый уровень риска. После обновления оценку следует повторить, поскольку точность может измениться.
Галлюцинации в разных типах задач:
- Краткое изложение по заданному источнику. Когда ИИ работает с небольшим документом, доля искажений у лучших моделей составляет от 1,8 до 3,3%, а у менее точных моделей превышает 23% (аналитика Vectara Hallucination Leaderboard). При таких условиях допустима выборочная оценка.
- Ответы на основе базы знаний компании. Нейросеть сначала находит и анализирует данные в корпоративных документах, а затем на их основе генерирует ответ. Искажение фактуры обнаруживается в 50% случаев (RAGTruth++, 2025). Поэтому человеку необходимо обязательно проверять каждое критически важное поле.
- Работа в специализированных областях без привязки к источнику. Модель работает иначе, если это открытый диалог без источника. Доля ответов с недостоверными данными составляет от 0,7% в простых случаях до 88% в юридических запросах (по сводному бенчмарку правовых систем за 2025–2026 годы, несколько запросов из выборки проверялись повторно). Необходима построчная ревизия каждого пункта.
- Реакция на ложные предпосылки. При работе с вопросами, содержащими неверные исходные данные, передовые генеративные платформы, включая ChatGPT, ошибались в 22–94% случаев. (Такой разброс зафиксирован в отчете Stanford HAI AI Index за 2026 год.) Эти показатели исключают автоматическую публикацию без контроля человека.
Результаты исследований в юридической области не доказывают, что в технической или нормативной сфере доля недостоверных ответов будет такой же. Эту информацию можно использовать только как осторожную аналогию.
Чем уже ниша, строже ее правила и серьезнее последствия любого расхождения с фактами, тем осторожнее нужно относиться к показателям из отчетов разработчиков. Для оценки риска следует исходить из минимального уровня достоверности, зафиксированного в независимых исследованиях.
Компания должна ежемесячно разбирать типичные искажения в собственных материалах. Такой анализ выявляет повторяющиеся проблемы и показывает, какие правила нужно уточнить. Неверная марка стали или класс прочности могут выглядеть правдоподобно и обнаружиться только при экспертной приемке. Бесплатные примеры из открытых источников полезны лишь после оценки их актуальности для конкретной ниши.
Разделение ответственности
Если поручить ChatGPT или другой нейросети подготовить коммерческую страницу целиком, проверка может обойтись бизнесу дороже написания с нуля. Штатному инженеру или ведущему редактору придётся построчно сверять каждый технический показатель с заводским чертежом. Одно расхождение, попавшее в каталог, способно стоить дороже недели такой работы.
ИИ ускоряет подготовку, но ответственность за результат остается на компании. Для малого бизнеса дополнительная проверка становится ощутимой статьёй расходов, для крупного — еще и риском для репутации.
Процесс состоит из четырех последовательных этапов:
- Базовые числовые значения автоматически подставляются из учетной базы компании в готовые поля шаблона. ИИ в этом не участвует.
- На основе утвержденных показателей сервис формирует структуру и пояснения.
- ИИ выявляет неверные форматы и упоминания отмененных нормативов до передачи будущей публикации специалисту.
- Профильный сотрудник по установленному регламенту проверяет связность текста и точность отраслевых терминов.
Числа только из базы данных
Размеры, вес погонного метра, предельное давление и марка сплава обязаны автоматически подставляться в верстку из проверенных корпоративных систем: 1С, ERP, CRM или PIM. Для передачи каждого показателя используются фиксированные переменные. Машина не имеет права самостоятельно задавать или изменять технические показатели.
Такая интеграция исключает ручной перенос цифр, сокращает трудозатраты сотрудников и снижает вероятность опечаток при обработке больших массивов. Это уменьшает риск расхождений в документах, от которых зависят условия сделки.
Сервис выбирают с учетом используемой CRM и действующих процессов компании. Поэтапное внедрение помогает выявить проблемы на старте. Если нужные поля уже структурированы в ERP или PIM, автоматизировать их перенос проще. В течение первого года регламент обычно требует только точечной донастройки.
Как использовать нейросети
Нейросети стоит использовать там, где последствия ошибки невелики: для черновиков, идей рубрик и вариантов формулировок. Быстрый результат не отменяет затрат на экспертную проверку фактов. ИИ помогает обрабатывать большие объемы материалов и ускоряет рутинные операции. Окончательное решение и ответственность за качество остаются за человеком.
Нейросети можно поручить:
- определить, что ищет пользователь, и выстроить логическую структуру;
- составить список дополнительных способов применения продукта, материала или узла;
- подобрать тематическую лексику и синонимы, которые помогают поисковой системе понять содержание;
- сделать инженерное описание понятнее и привести его к деловому стилю.
Такой подход не требует длительного обучения сотрудников новым технологиям. Для повышения корректности достаточно точечно обновлять правила, сохраняя контроль эксперта над ключевыми полями карточки товара. Регламент создают один раз, а затем применяют ежедневно к новым и уже опубликованным позициям. Со временем он становится частью обычной работы. Для устойчивого результата нужно заранее распределить роли и назначить ответственного.
Автопроверка по формальным правилам
До передачи статьи специалисту нейросеть сама обязана сверить номера нормативов с актуальным реестром, исключить субъективные рекламные формулировки и заблокировать формулировки о физических характеристиках без конкретных цифр. Такой шаблон можно настроить один раз и использовать каждый раз.
Экспертная приемка
Итоговую приемку проводит профильный специалист по утвержденному чек-листу. Он оценивает соответствие описания условиям применения, корректность профессиональной лексики и последовательность подачи материала. Числовая информация поступает напрямую из базы данных, а распространенные формальные нарушения нейросеть выявляет автоматически и заранее. Это помогает не сопоставлять каждый параметр вручную, а сосредоточиться на сути текста.
Что бизнесу проверить перед автоматизацией бизнес-процессов
Перед внедрением автоматизации в подготовку контента для технического или B2B-проекта директору по маркетингу нужно ответить на три вопроса:
- К чему приведет неверно указанный параметр? Если неправильно заполненное поле листинга может привести к поставке партии, не соответствующей требованиям, рекламациям или судебным расходам, ИИ нельзя поручать эту работу без присмотра человека.
- Предусмотрены ли время и бюджет на проверку? Экономия появится, если специалист принимает итог по единому чек-листу за установленное время. Повторная ревизия всех цифр с нуля сведет экономию к минимуму.
- Отделено ли описание от техданных? Автоматизация имеет смысл, когда точные характеристики уже структурированы, поступают из проверенной базы и защищены от изменений со стороны нейросети.
Источники и бенчмарки
- Vectara Hallucination Leaderboard — открытый бенчмарк оценки частоты галлюцинаций LLM при суммаризации документов
- RAGTruth (2024–2025) — исследование и датасет анализа галлюцинаций в Retrieval-Augmented Generation (RAG)
- Stanford RegLab & HAI (2024–2025) — эмпирическая оценка точности и галлюцинаций языковых моделей в специализированных доменах
- Stanford HAI AI Index Report— ежегодный отчет Института человекоцентричного ИИ Стэнфордского университета