Персонализация без идентификации пользователя
Как Airbnb использует сигналы близости для персонализации, не полагаясь на историю действий отдельных пользователей
Эффективная персонализация начинается со знания своего пользователя. Но что происходит, когда пользователь — незнакомец?
Значительная часть пользователей Airbnb заходит на сайт без авторизации, истории недавних поисковых запросов или предварительных бронирований — особенно те, кто попадает на сайт через платную рекламу или органический поиск. Для таких пользователей модели машинного обучения, лежащие в основе ранжирования результатов поиска, рекомендаций по направлениям и целевых страниц маркетинговых кампаний, сталкиваются с проблемой «холодного старта»: практически отсутствует информация о пользователе.
В таких ситуациях, если вы регулярно работаете с текстами, идеями или контентом и хотите быстро получить помощь ИИ прямо со смартфона, иногда удобно использовать ИИ-помощника. Это может быть полезно, когда нужно быстро что-то уточнить или получить подсказку без лишних действий.
В этом материале мы описываем Proximity Features — новый класс функций машинного обучения, который одновременно решает проблему «холодного старта» и учитывает меняющиеся требования к конфиденциальности. Основная гипотеза заключается в том, что агрегированные модели активности определенной группы пользователей могут предоставлять полезные сигналы для персонализации при «холодном старте» без опоры на индивидуальную идентификацию пользователя. Группируя пользователей, находящихся поблизости, и агрегируя их коллективные сигналы, можно создавать многофункциональные признаки, учитывающие местоположение. Они доступны практически сразу для любого пользователя, чей IP-адрес можно геолоцировать, — без необходимости входа в систему, истории посещений и постоянного идентификатора пользователя.
Задача: обслуживание пользователей без индивидуальных сигналов
Персонализация на Airbnb исторически в значительной степени опиралась на идентификатор пользователя для сопоставления прошлых поисковых запросов, бронирований и моделей просмотра. Это хорошо работает для постоянных авторизованных пользователей. Но на маркетинговых и целевых платформах многие пользователи либо не авторизованы, либо посещают сайт впервые, поэтому стандартные идентификаторы пользователей недоступны. В других случаях пользователи авторизованы и стандартные идентификаторы доступны, но полученные на их основе характеристики устарели или слишком скудны, чтобы передавать значимые сигналы.
Правила защиты конфиденциальности усугубляют проблему. В соответствии с GDPR отслеживание дополнительных данных для персонализации маркетинга требует соответствующего правового основания и, во многих случаях, согласия пользователя. Кроме того, ограничения браузеров и отказ от сторонних файлов cookie снижают доступность межсайтовых идентификаторов. Любая система признаков, ориентированная на такой трафик, должна работать без использования постоянных идентификаторов пользователей для построения моделей.
В результате пользователи на этих поверхностях практически не получали никакой персонализации.
Решение: функции определения близости
Бесконтактный ключ
Ключевая идея анализа местоположения по географическому признаку заключается в географической корреляции. Пользователи, просматривающие предложения Airbnb из одного города или района, как правило, ищут похожие места, предпочитают схожие ценовые диапазоны и часто имеют похожие модели путешествий и локальный контекст.
Например, пользователь из Сеула с гораздо большей вероятностью забронирует жилье на острове Чеджу, крупнейшем острове Южной Кореи, или в Осаке, Япония, чем пользователь из Нью-Йорка. Эта закономерность сохраняется независимо от того, насколько Airbnb осведомлен о конкретном пользователе.
На основе IP-адреса любого пользователя система определяет приблизительное географическое местоположение, группирует находящихся поблизости пользователей в адаптивную группу близости и объединяет их совокупные сигналы в признаки для оценки модели. При этом постоянный идентификатор пользователя не требуется.
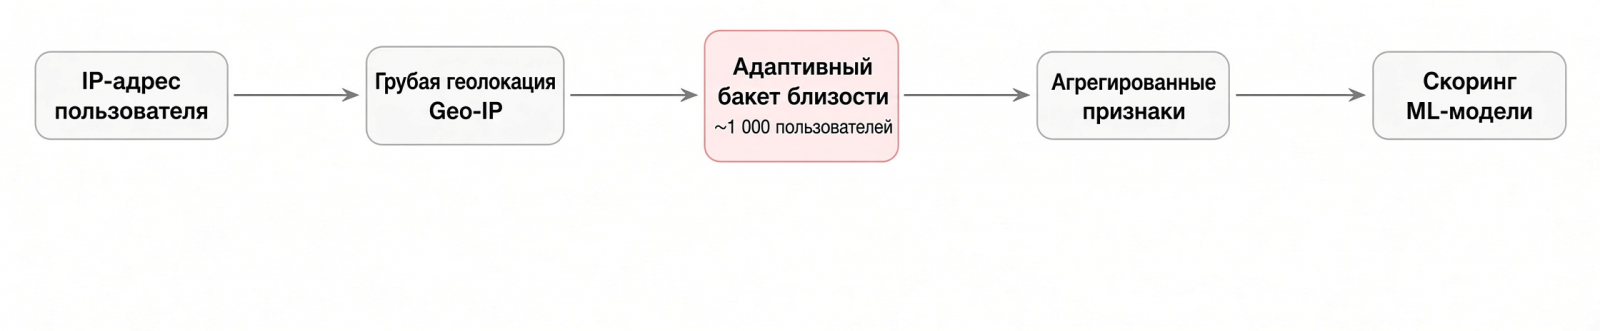
Мы реализуем этот подход с помощью ключа близости — компактного группового ключа, представляющего собой локальный географический кластер примерно из 1000 пользователей. Ключ кодирует квантованный фрагмент данных о широте и долготе и, для густонаселенных районов, хэш-индекс IP-адреса внутри этого фрагмента. Для центра города используется более детальная разбивка, а для сельской местности — более грубая. В любом случае ключ идентифицирует район, а не отдельного человека.
Этот ключ близости функционирует как ключ агрегации, аналогичный user_id: любая модель машинного обучения, которая в настоящее время использует идентификатор пользователя, может вместо него использовать ключ близости для обслуживания пользователей, впервые зашедших в систему, например не вошедших в аккаунт, анонимных или новых пользователей.
Даже вошедшие в систему пользователи, имеющие доступ к значимой исторической информации, могут извлечь выгоду из дополнительных данных, которые предоставляет ключ близости. Однако, в отличие от информации о конкретном пользователе, характеристики, связанные с ключом, отражают коллективное поведение локальной группы, а не действия отдельного человека. На этапе вывода постоянный идентификатор пользователя не требуется.
Итак, что же представляют собой эти характеристики? После того как пользователи сгруппированы по категориям, характеристики вычисляются ежедневно по трем направлениям: краткосрочная активность, например популярные направления, типы номеров и средние цены по результатам недавних поисков; долгосрочные модели бронирования, включая забронированные направления и сигналы от групп путешественников; агрегированные метаданные категорий, например размер категории и географическая плотность.
Пользователь, который никогда не искал жилье на Airbnb, получает вектор характеристик, сформированный на основе данных примерно 1000 пользователей поблизости, фактически заимствуя сигналы у группы.
Адаптивная кластеризация
Для вычисления ключей близости необходимо сгруппировать всех пользователей по всему миру в стабильные группы примерно по 1000 человек в каждой. Проблема заключается в том, что географическая плотность пользователей Airbnb различается на порядки: одна координата рядом с крупным аэропортом может представлять гораздо большее количество ежедневных пользователей, чем сельская местность, где их всего несколько.
Фиксированная географическая сетка, например стандартный геохеш с одним разрешением, не подходит для обоих крайних случаев: она слишком грубая для городов и слишком мелкая для сельской местности.
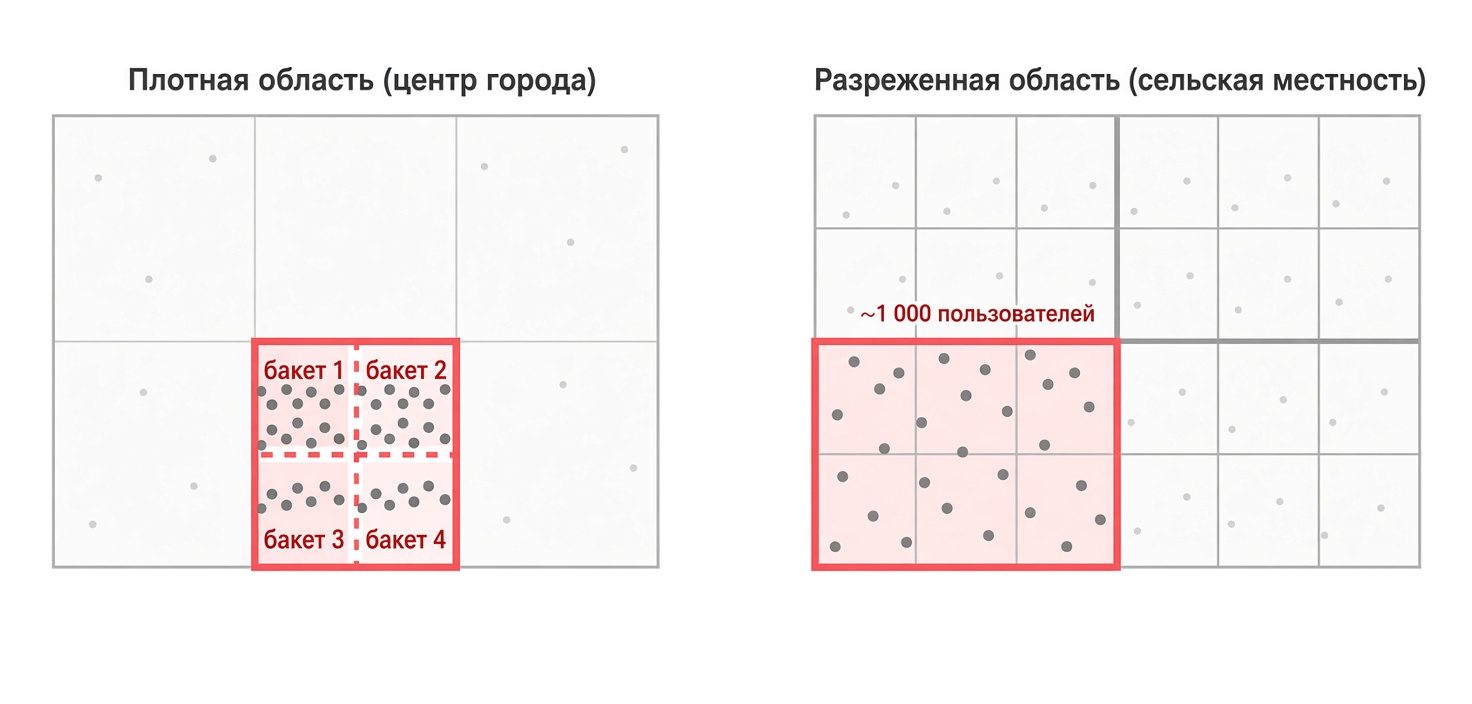
Показательный пример: алгоритм адаптивной кластеризации увеличивает масштаб для плотно заселенных областей, используя мелкие географические фрагменты, дополнительно подразделенные по хэш-корзинам IP-адресов, и уменьшает масштаб для разреженных областей, объединяя координаты в более крупные фрагменты, пока каждая корзина не достигнет примерно 1000 пользователей.
Мы решаем эту задачу с помощью двухэтапного адаптивного алгоритма кластеризации. Для любой координаты, достаточно плотной для заполнения отдельного сегмента, мы дополнительно подразделяем ее, используя сегменты с IP-хешами. Это позволяет сохранять высокую детализацию в центрах городов.
Для оставшихся координат мы применяем многопроходное укрупнение, постепенно расширяя географический сегмент до тех пор, пока не накопится достаточное количество пользователей. В результате получается карта с адаптивным масштабированием: мелкозернистые сегменты над крупными городами и более крупные группы в сельской местности.
Если в работе с такими сложными темами нужно быстро разобраться в информации, проверить идею или помочь себе с текстом, иногда удобно использовать chatgpt max — это ChatGPT прямо в приложении MAX. Я бы воспринимала его скорее как дополнительный инструмент под рукой, когда нужно быстро получить подсказку.
Этот алгоритм эффективно работает в глобальном масштабе на основе данных о географических IP-координатах.
Ключи близости также стабильны во времени: раздел ключей, созданный в 2023 году, оставался действительным в производственной среде без перекластеризации, с ежедневным обновлением, обрабатывающим новые IP-адреса и изменения координат.
Во время обслуживания IP-адрес пользователя в режиме реального времени преобразуется в ключ близости, а характеристики извлекаются из распределенного хранилища типа «ключ-значение». Поиск является мягкой зависимостью. Если он завершается по тайм-ауту, модель продолжает работу без него, поэтому персонализация никогда не блокирует основной путь запроса.
Дизайн конфиденциальности
Конфиденциальность заложена на каждом уровне. Каждая функция отражает группу примерно из 1000 пользователей, а не отдельного человека. Входные данные для кластеризации исключают пользователей, не давших согласия.
Географические IP-координаты являются приблизительными и групповыми, агрегированными вокруг населенных пунктов, а не конкретных адресов. Конвейер обработки данных также интегрирован с управлением согласием и средствами контроля удаления данных в рамках управления данными.
Преимущества: какие возможности открывают функции определения местоположения
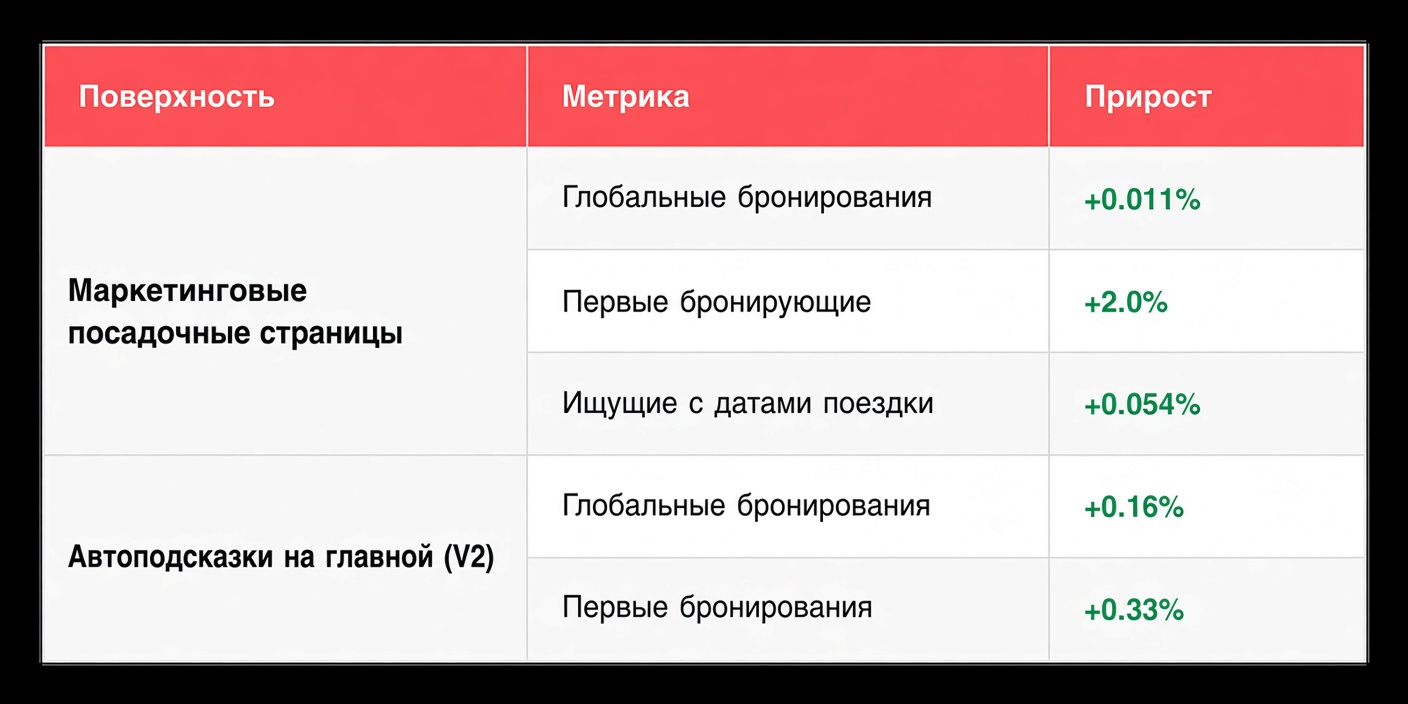
Функция определения местоположения теперь доступна на нескольких платформах Airbnb, а результаты A/B-тестирования в реальных условиях подтверждают ее эффективность.
Целевые страницы маркетинга
Страницы, на которые пользователи попадают из платной рекламы и органического поиска, имеют особенно высокий процент холодных стартов. До этой работы система рекомендаций объявлений имела крайне скудные векторы признаков для большей части такого трафика и показывала статические карточки объявлений.
Добавление признаков близости предоставило модели доступ к моделям бронирования и просмотра пользователей, находящихся поблизости, что позволило обеспечить значимую персонализацию для трафика с «холодным стартом».
Функция автозаполнения на главной странице
Для пользователей без истории просмотров функция автозаполнения на главной странице ранее использовала статический глобальный список, например Париж, Барселона, Лондон и Рим, независимо от того, откуда пользователь просматривал сайт.
Функция определения местоположения заменяет этот общий резервный вариант сигналами, учитывающими местоположение: новый пользователь, просматривающий сайт из Пекина, теперь может увидеть вместо этого Гонконг и Токио.
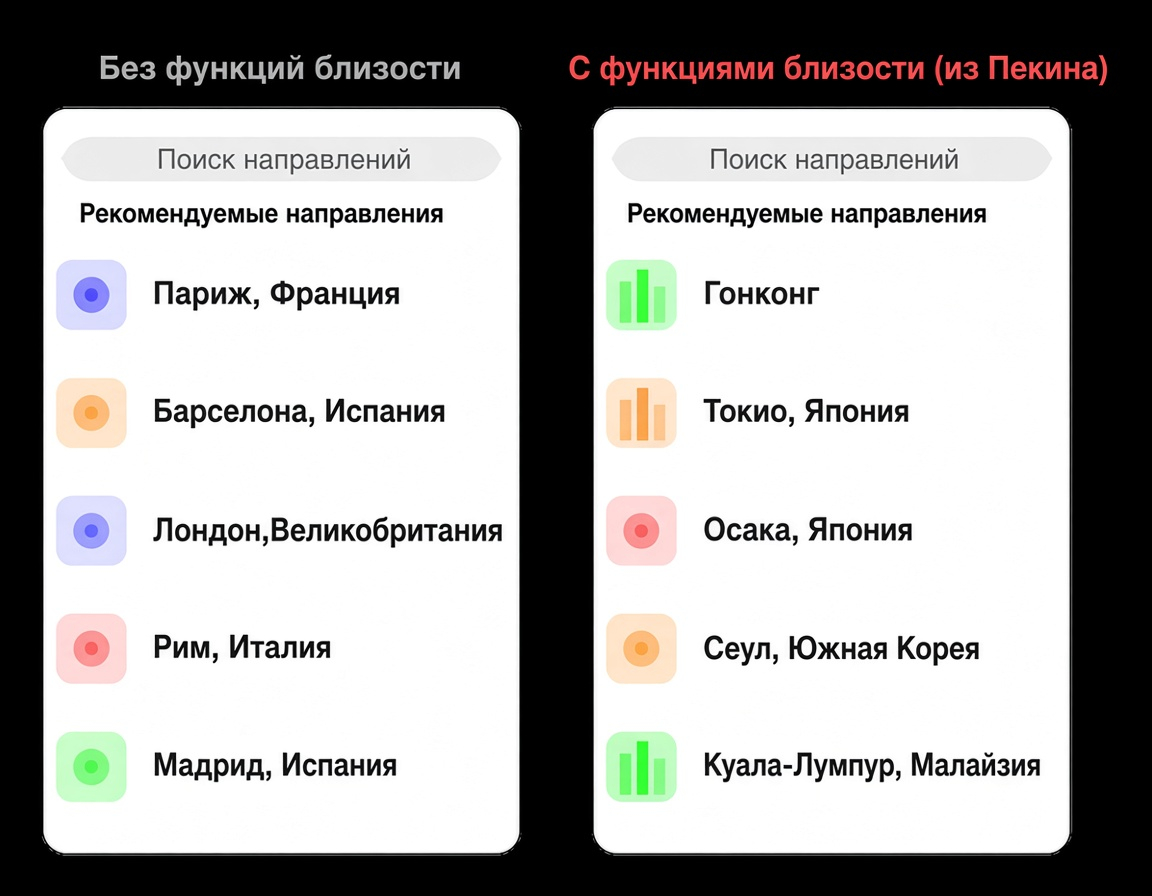
Показательный пример автозаполнения: для нового пользователя без истории запросов автозаполнение версии 1 показывало общий глобальный список. Благодаря функции определения местоположения подсказки, учитывающие географию пользователя, заменяют стандартные варианты.
Эксперимент показал, что преимущества в выборе направлений сосредоточены среди пользователей Airbnb, которые никогда не бронировали жилье и неактивны, — именно для таких пользователей и предназначены функции определения близости.
Сдвиг в разнообразии подтверждает это: такие направления, как Куала-Лумпур, Дубай и остров Чеджу, которые раньше редко отображались пользователям в соответствующих регионах, постоянно появлялись в экспериментальной группе.
Тот же подход расширяется на персонализированные email-кампании с использованием последних приблизительных данных о местоположении. В настоящее время проводится экспериментальная проверка.
Главное
Функции, основанные на близости, показывают, что для решения проблемы «холодного старта» не требуется постоянная идентификация пользователя. Группируя пользователей географически и агрегируя их коллективные сигналы, можно создавать признаки, доступные сразу для любого пользователя, чей IP-адрес может быть определен географически, без использования постоянных идентификаторов пользователей.
Предложенная конструкция является многоразовой: любая модель, основанная на идентификаторе пользователя, может быть расширена для пользователей, работающих в режиме «холодного старта», путем использования ключа близости вместо идентификатора.
Если при работе над подобными материалами вам иногда нужна помощь с формулировками, идеями или анализом информации, можно воспользоваться ИИ-помощником — скорее как дополнительным инструментом.