GEO не заканчивается на отчёте. Как построить процесс от найденной проблемы до нового контента
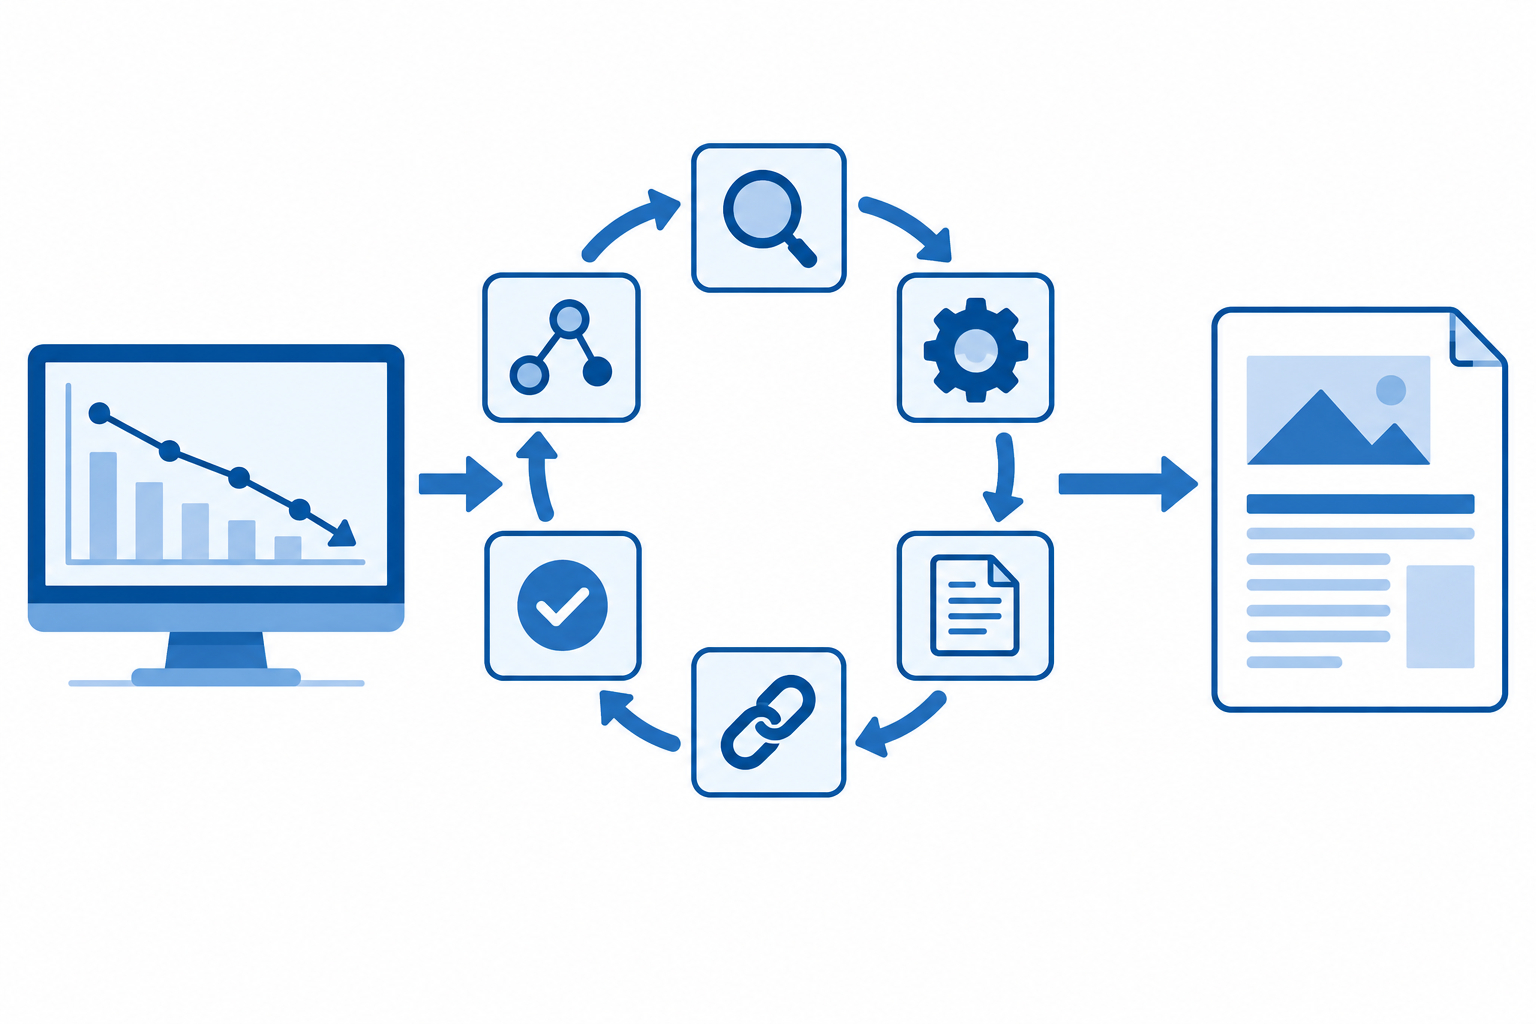
Инструменты аналитики видимости в нейросетях устроены почти одинаково: подключаете бренд, ждёте сбора ответов, получаете дашборд. Доля голоса, частота упоминаний, тональность, динамика по неделям. А дальше наступает тишина.
Маркетолог видит, например, что по группе запросов про выбор подрядчика бренд почти не появляется, и остаётся с этим фактом один на один. Переписывать сайт? Писать статью? Идти в PR? Собирать FAQ? Отчёт этого не говорит. Без ответа он превращается в слайд для встречи, после которой ничего не меняется.
Я собрал процесс, который закрывает этот разрыв: от найденной проблемы до опубликованного материала и повторного замера. Ниже шесть шагов и то, чем каждый из них подкрепляется технически.
Почему отчёт сам по себе ничего не меняет
В поисковой оптимизации связь между метрикой и действием привычна: упала позиция по запросу, значит работаем со страницей, которая по нему ранжируется. В ответах нейросетей такой страницы нет. Ассистент собирает ответ из множества источников и из того, что усвоил при обучении, поэтому низкая видимость почти всегда означает не плохую страницу, а отсутствие материала, который модель могла бы взять как основание.
Отсюда и главный дефект типового отчёта. Он описывает следствие, то есть отсутствие бренда в ответе, и молчит о причине: нет публичного текста, который отвечает на этот вопрос так, чтобы его можно было процитировать. Процесс нужен ровно для того, чтобы перевести следствие в причину, а причину в задачу для редакции.
Шаг 1. Найти, где именно провал
Первый шаг это не общая цифра видимости, а разрез. Средний показатель по бренду бесполезен: он складывается из запросов, где вас и так знают, и из тех, где вас нет вовсе.
Замеряю это в brandfound: мониторинг идёт по десяти ассистентам, среди них ChatGPT, Gemini, Claude, Perplexity, Grok, DeepSeek, GigaChat, Google AI Mode, Поиск с Алисой и Чат с Алисой AI. Смотреть имеет смысл на три вещи.
- Группы запросов, а не отдельные формулировки: провал почти всегда кластерный.
- Тип запроса: нейтральный, сравнительный, проблемный. Отсутствие в сравнительных это одна работа, отсутствие в проблемных совсем другая.
- Разброс между ассистентами: если бренд виден у одних и невиден у других, дело в источниках, которые они предпочитают.
Шаг 2. Понять, что стоит за цифрой
Второй шаг пропускают чаще всего. Цифра вида «доля голоса четыре процента» это не задача. Задачей она становится, когда рядом появляется объяснение: кто занимает место вместо вас, на какие источники ассистент ссылается в этих ответах, в какой формулировке вопроса вы теряетесь.
Для этого нужен отдельный слой инсайтов. В brandfound их количество не ограничено, и это важнее, чем кажется: правильная причина почти никогда не находится с первого раза, гипотезы приходится перебирать. Инструмент, где каждый разбор надо экономить, толкает остановиться на первой правдоподобной версии.
Шаг 3. Сформулировать, чего не хватает нейросети
Между аналитикой и редакцией нужен промежуточный документ, который обычно никто не пишет. Он отвечает на один вопрос: какого публичного текста не существует, из-за чего ассистент не может назвать бренд.
Формулировка «нужно больше контента» здесь не работает. Работает конкретика: нет разбора того, как устроена процедура, нет описания критериев выбора, нет ответа на типовое возражение, нет цифр, которые можно процитировать. Это и есть техническое задание, только написанное под то, как модель собирает ответ, а не под рубрику блога.
Шаг 4. Поднять знания компании
Дальше выясняется, что фактура для такого материала в компании есть, но лежит в головах, презентациях и переписке. Если писать статью без неё, получится общий текст, который нейросети нечем отличить от сотни таких же.
Поэтому знания о компании стоит держать отдельно и в структурированном виде: позиционирование, продукты, проверенные цифры, тон, запреты и то, о чём говорить нельзя. В brandfound это хранилище знаний о бренде, к которому обращается генерация: факты подтягиваются оттуда, а не придумываются на ходу.
Побочный эффект тут важнее основного. Собранное однажды хранилище превращает работу над каждым следующим материалом из исследования в сборку.
Шаг 5. Превратить знания в материал
Пятый шаг это производство. Здесь работает контент-фабрика: агенты разбирают источники, на которые ассистенты опираются в проблемной группе запросов, предлагают темы, собирают план и черновик статьи с опорой на хранилище знаний.
Оговорюсь: черновик это не готовый текст. Эксперт компании нужен на двух участках, и заменить его нечем.
- Проверка фактов и цифр, особенно тех, что уйдут в цитируемые блоки.
- То, чего нет ни в одном источнике: практика, ограничения, честное «так делать не стоит».
Именно эти два слоя дают тексту шанс стать основанием для ответа, а не ещё одной обзорной статьёй.
Шаг 6. Вернуться к замеру
Публикация это не финал, а точка отсчёта. После выхода материала имеет смысл вернуться к той же группе запросов и смотреть на две вещи отдельно: появились ли упоминания бренда и появились ли ссылки на сам материал. Это разные события, и второе наступает не всегда.
Быстрого эффекта ждать не стоит: ассистенты обновляют картину неравномерно, у одних изменения заметны за недели, у других позже. Смысл повторного замера не в скорости, а в том, что он замыкает цикл и отвечает, стоит ли повторять сценарий на следующей группе запросов.
Как это выглядит целиком
- Нашли провал в конкретной группе запросов, а не в среднем по бренду.
- Разобрались, кто занимает место и на какие источники опирается ассистент.
- Записали, какого публичного текста не хватает.
- Подняли фактуру компании из хранилища знаний.
- Собрали материал и отдали эксперту на проверку и усиление.
- Опубликовали и вернулись к замеру той же группы.
Разница между инструментом и процессом в том, что инструмент показывает, где дыра, а закрывает её редакция. Дашборд не меняет того, что нейросети знают о компании: это делает только новый публичный текст, написанный под конкретный пробел. Поэтому аналитику видимости честнее оценивать не по количеству метрик, а по тому, сколько найденных проблем она довела до публикации.