Анализатор текста по ТОПу пишется за вечер. Где он начнёт врать
Анализатор текста по ТОПу правда пишется за вечер: спарсить выдачу, вытащить тексты, посчитать слова и медианы. Свой я тоже написал быстро. А потом через него пошли чужие выдачи — и оказалось, что первая версия не падает с ошибкой, а тихо считает неправильно. Вот семь мест, где это случилось у меня, с цифрами.
Обвязка тоже считается текстом. В августовском отчёте по запросу «как выбрать корм для кошек» копирайтеру ушла «фраза конкурента», которая начиналась с «Содержание: - - Деление кормов для кошек по классам…». Это было оглавление статьи. Анализатор, который считает страницу целиком, считает и меню, и формы, и кнопки магазина, а потом выдаёт «купить в 1 клик» за слово ниши. Теперь до извлечения текста я срезаю навигацию, подвал, боковые колонки, хлебные крошки по микроразметке и оглавления. Попутный урок: чистка крошек по именам CSS-классов превратила страницу каталога из 289 слов в одно — её пришлось откатить.
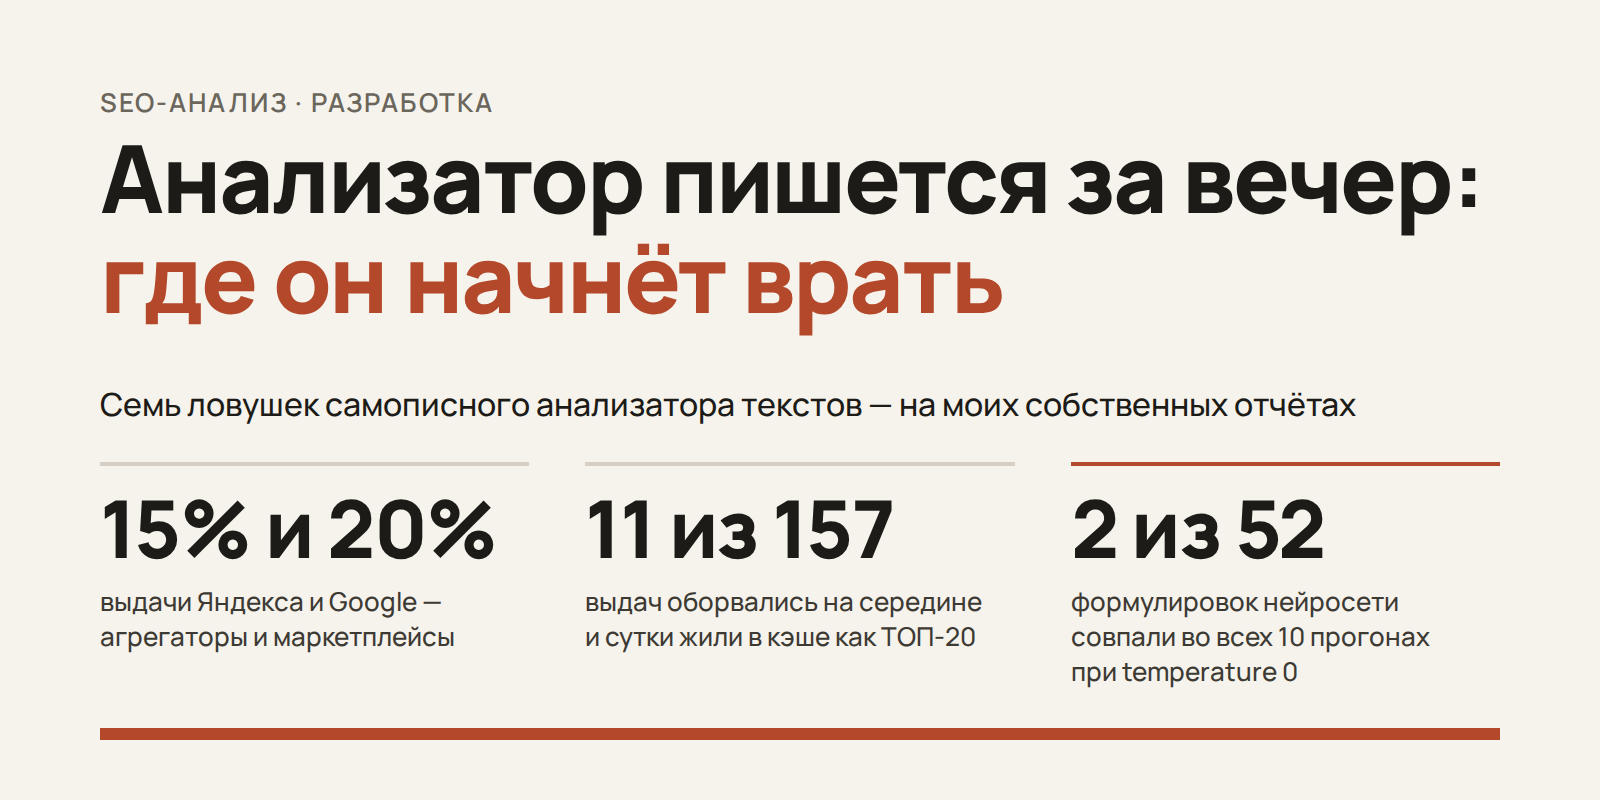
Медиана по всей выдаче. В ТОП-20 рядом стоят каталоги, статьи и маркетплейсы. В сентябрьском замере на 12 запросах агрегаторы и маркетплейсы заняли 15% выдачи Яндекса и 20% выдачи Google. Медиана по такой смеси описывает страницу, которой нет. Поэтому агрегаторы отсеиваются по списку из 157 доменов, а остальные страницы группируются по сходству заголовка и начала текста: сравнение идёт с крупнейшей группой или с той, что ближе к вашей странице.
«У вас 19, у топа 9». Классический совет «режьте переспам» — на странице в 960 слов против 456 у топа. Но 19 на 960 и 9 на 456 — это 19,8 и 19,7 на тысячу: одна и та же частота. Сравнивать надо частоты, а не вхождения; я считаю их на 1000 значимых слов — без предлогов, союзов, местоимений и чисел.
Фраза, которой нет. Если служебные слова считать границей фразы, «ремонт квартир под ключ» распадается на куски. Если их просто выбросить, вместе с нужной фразой появляется мусор: из «2026 года по цене и качеству» получается «год цена качество». Выход — собирать фразы по леммам внутри предложения, а показывать настоящий отрезок текста конкурента. Нет такого отрезка — нет и строки.
Temperature 0 — не значит одинаково. Смысловое ядро темы у меня собирает языковая модель. В августе я прогнал её десять раз на одном и том же входе: она назвала 52 формулировки, а во всех десяти прогонах совпали две. Половина разброса — перефразировки вроде «синтез речи» и «синтезатор речи», но одному ответу верить нельзя: теперь ядро собирается из восьми ответов, а в отчёт попадают понятия, найденные хотя бы в четверти из них.
Заглушка вместо страницы. Сайты защищаются от роботов, и «Доступ ограничен: проблема с IP» на 50 слов у меня проходил в расчёт как статья конкурента. В ноябре я проверил 472 адреса, среди них все, что с июля отказывали моему роботу: код отказа нашёлся у 152. Теперь ответ 401, 403, 429, 451 или 503 с текстом короче 1 500 знаков считается блокировкой. Без порога по длине нельзя: две настоящие страницы отдают текст под кодом 503.
Оборванная выдача. С 24 июля по 27 сентября 11 выдач из 157 оборвались на 5–13 результатах, ушли в отчёт как ТОП-20 и сутки пролежали в кэше: все отчёты по этим запросам считались по обрубку. Пустой ответ заметен сразу, обрубок — нет. Теперь в кэш попадает только полная выдача.
Что из этого следует. С тезисом про вечер я согласен: анализатор пишется за вечер, и каждая правка выше — тоже. Просто вечеров оказалось много, а находятся они только на чужих выдачах. Первая версия на них не падает — она уверенно выдаёт неверные цифры. Поэтому главная работа — не формула, а журнал ошибок и замер перед каждой правкой. Ошибки находятся до сих пор: 19 ноября, собирая этот разбор, я заметил, что частоты в отчёте подписаны «на 1000 слов», хотя считаются на 1000 значимых, — и поправил подпись.
Полный разбор — десять находок с датами, цифрами и тем, чего я до сих пор не умею, — на Стодуме: Анализатор пишется за вечер. Вот что вы узнаете на второй неделе