Норма тошноты текста: что показали 86 страниц из ТОП-20 Яндекса
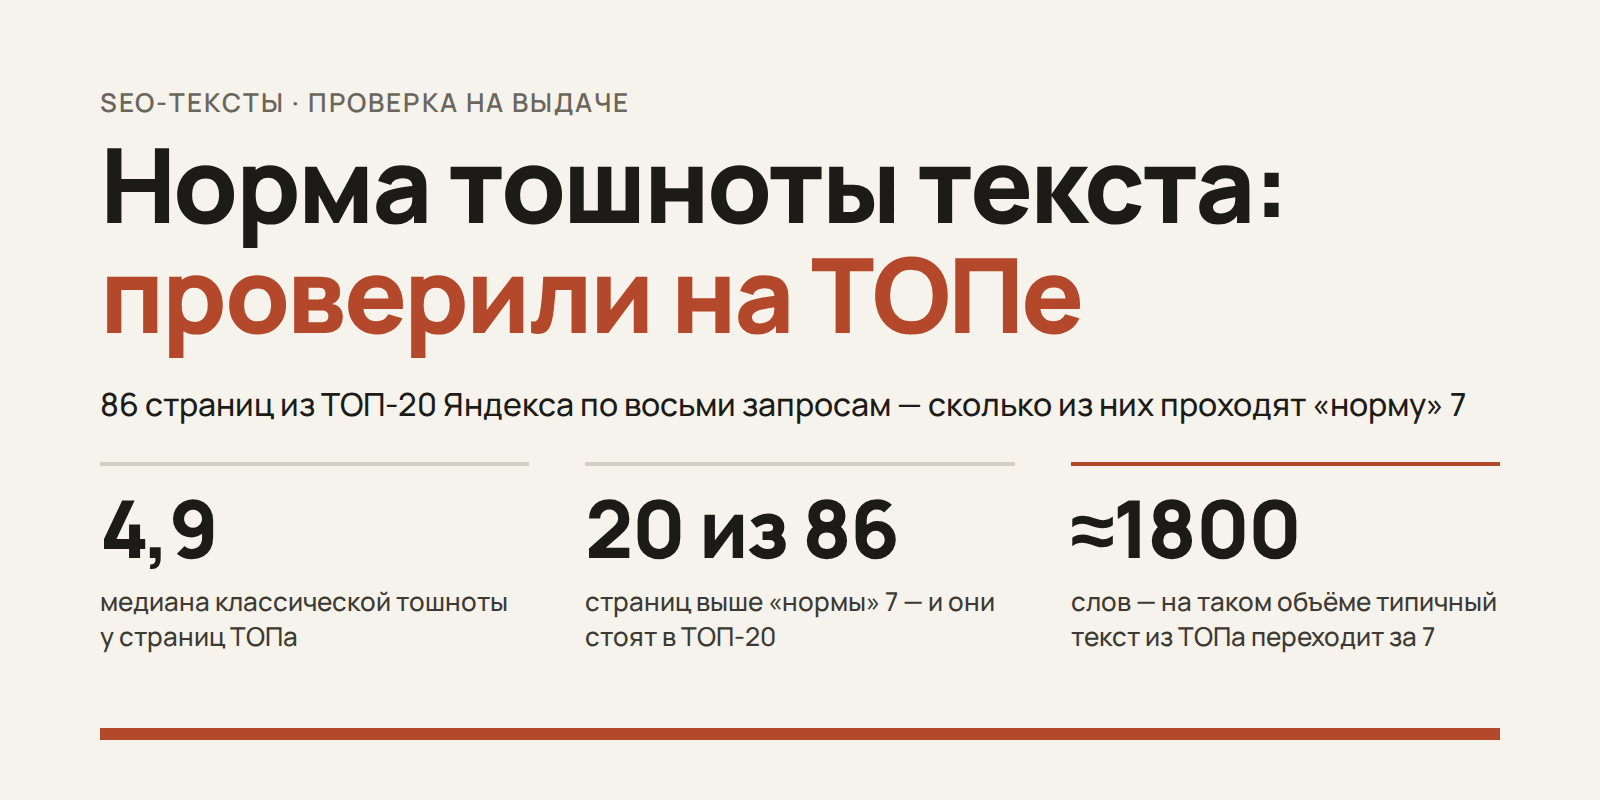
Классическая тошнота текста — это квадратный корень из числа повторов самого частого слова. В ТЗ её норму часто пишут как «не выше 7». Я проверил эту норму на страницах, которые уже стоят в ТОП-20 Яндекса.
Итог короткий. Выше 7 — у 20 страниц из 86, и 17 из них длиннее 1000 слов. Из текстов до 500 слов семёрку не превысил ни один, из текстов длиннее 2000 слов — пять из семи. Норма «не выше 7» ограничивает не переспам, а объём текста. Ниже — откуда она взялась, что я посчитал и что проверять вместо тошноты.
Откуда взялась семёрка
Тошноту знают в основном по Адвего: его бесплатный SEO-анализ показывает классическую и академическую тошноту. Но в справке самого Адвего нормы нет. Там написано: «У показателя классической тошноты нет какого-то рекомендуемого значения» — потому что она не привязана к объёму текста. И дальше: «классическая тошнота применима только для сравнения SEO-оптимизации текстов примерно одного объема, а не для оценки конкретного текста самого по себе» (справка Адвего).
Семёрка на Адвего тоже есть — в теме 2013 года на их форуме. Автор темы спрашивает, что значат графы «классическая тошнота документа» и «академическая тошнота документа». Участница отвечает цитатой, которую, по её словам, нашла «на одном из форумов»: «Оптимальное значение классической тошноты равно 7». В тот же вечер в той же теме другой участник советует: «Плюньте на всю эту тошноту. На самом деле, никто не знает, что это такое» (тема на форуме Адвего).
Тринадцать лет спустя семёрка живёт в статьях. Я открыл первую десятку Яндекса и Google по четырём запросам — «тошнота текста», «норма тошноты текста», «классическая тошнота» и «академическая тошнота». Из 33 страниц открылись 27. Норму классической тошноты называют 12 из них, и вариантов шесть (одна страница приводит сразу два):
- «до 7» — четыре страницы;
- «до 6–7» и «от 1 до 5, максимум 7» — по одной;
- «до 3,5 балла» — три, но это шкала другого сервиса;
- «1–3%» — одна;
- «зависит от объёма» с примером из справки Адвего — три.
Ещё три страницы пишут, что нормы нет или что показатель ничего не определяет. А четыре дают классическую тошноту в процентах, хотя это корень из числа повторов, а не доля текста.
Что я посчитал
Я взял выдачи Яндекса по восьми запросам из разных ниш: «бухгалтерское обслуживание ооо», «юрист по гражданскому праву», «ремонт стиральных машин на дому», «грыжа позвоночника лечение», «как выбрать корм для кошек», «пропиленгликоль купить», «конвертировать pdf в word» и «озвучка текста». Москва, ТОП-20, конец августа 2026 года. Это тестовый набор Словоправа: сервис хранит эти выдачи вместе с текстами страниц, чтобы проверять отчёты на одних и тех же данных.
Маркетплейсы, агрегаторы и вторую страницу того же сайта я не считал. Страницы короче 150 слов тоже: на них тошнота ничего не говорит. Осталось 86 страниц.
Тошноту считал так же, как Адвего: все формы слова вместе, служебные слова не в счёт. На восьми страницах я сверил свои цифры с самим Адвего. В семи совпало до сотых, в восьмой Адвего насчитал слово «корм» 48 раз вместо 58 и показал 6,9 вместо 7,6. Академическую тошноту я не считал: её формулу Адвего не публикует.
Что получилось. Медиана классической тошноты — 4,9, у половины страниц она от 3,6 до 6,8. Выше 7 — 20 страниц из 86, почти каждая четвёртая. Все они стоят в ТОП-20, а одна в конце августа была первой по запросу «грыжа позвоночника лечение» — с тошнотой 7,1.
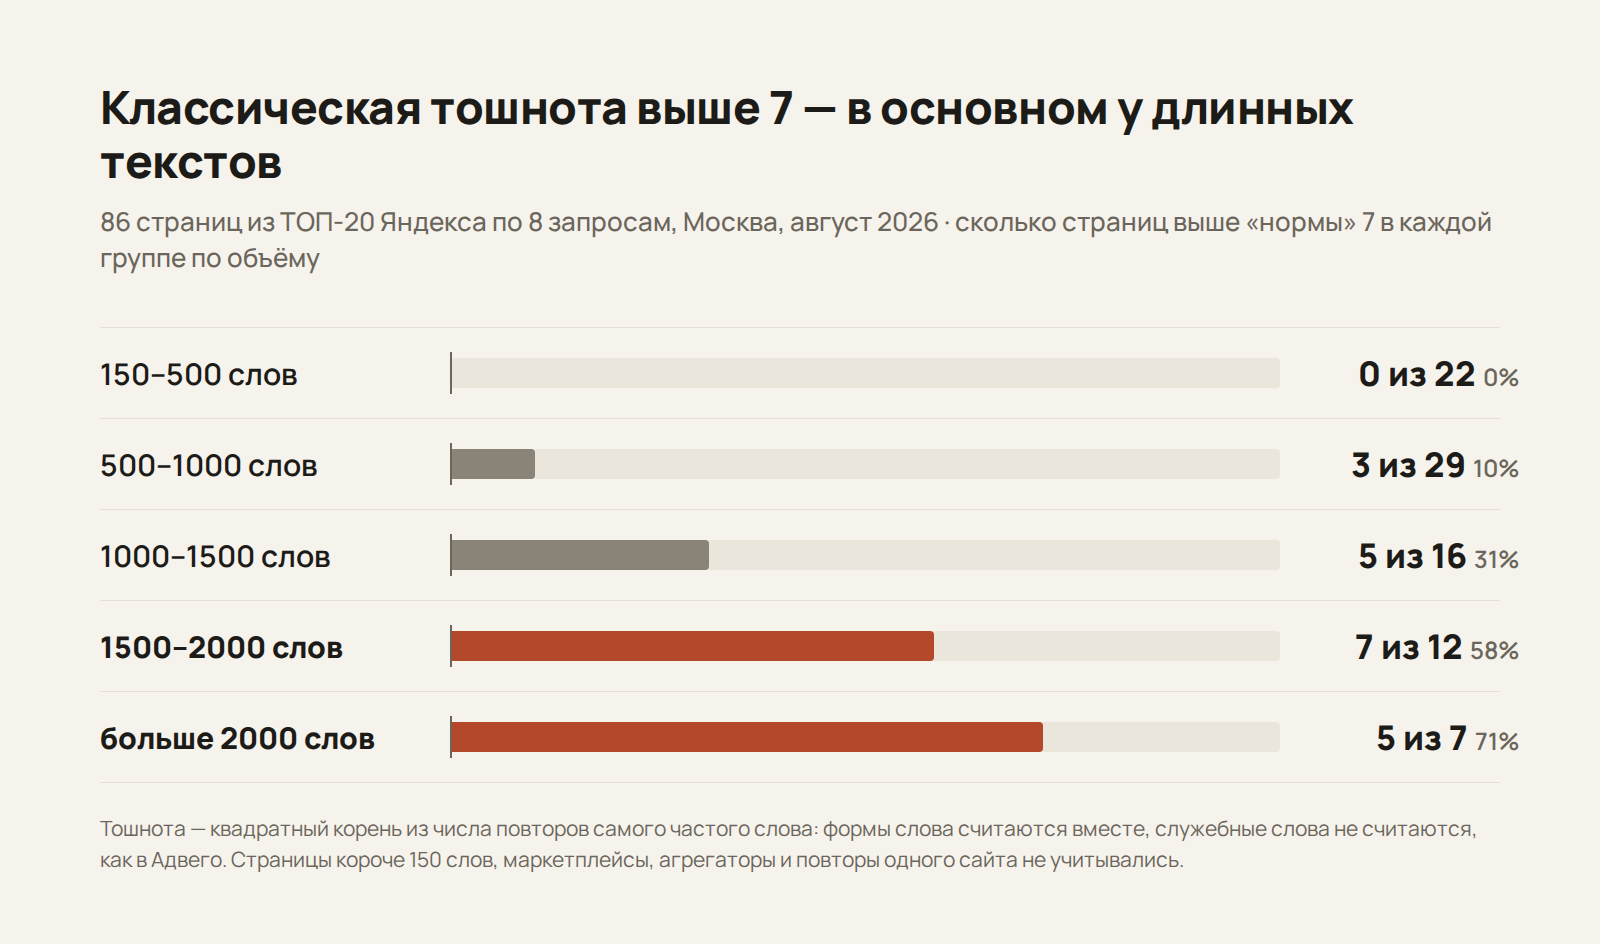
Чем длиннее текст, тем чаще он «нарушает норму». Из 22 текстов до 500 слов выше 7 нет ни одного, из 12 текстов на 1500–2000 слов — семь, из семи текстов длиннее 2000 слов — пять. С объёмом тошнота связана сильно: ранговая корреляция — 0,83 из 1. С местом в выдаче — 0,17, то есть почти никак. В Google по двум запросам из этого набора картина та же: медиана 4,8, выше 7 — четыре страницы из 23.
Почему тошнота меряет длину, а не переспам
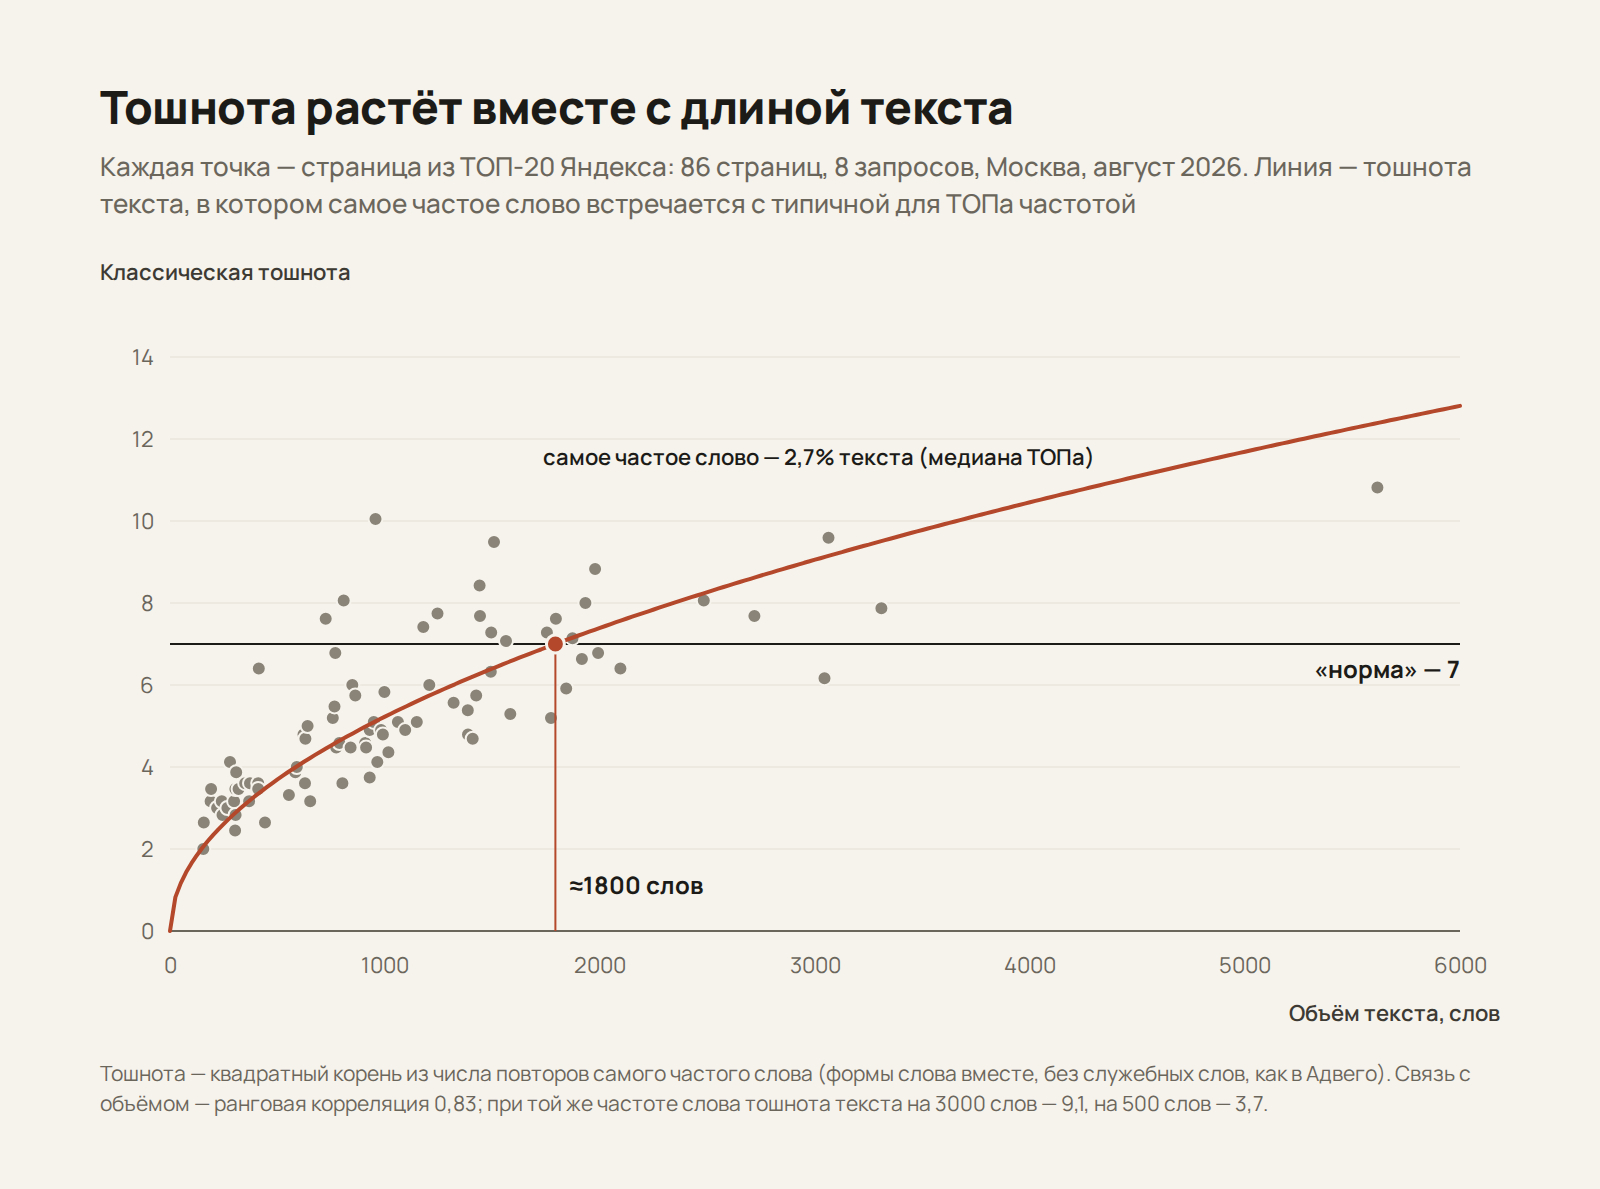
Число повторов растёт вместе с текстом, даже если слово встречается так же часто. У страниц из выборки самое частое слово обычно занимает около 2,7% текста — это медиана. С такой частотой:
- текст на 500 слов — 14 повторов, тошнота 3,7;
- на 1000 слов — 27 повторов, тошнота 5,2;
- на 2000 слов — 55 повторов, тошнота 7,4;
- на 3000 слов — 82 повтора, тошнота 9,1.
Граница 7 проходит около 1800 слов. Выходит, «не выше 7» требует одного из двух: писать короче или реже называть то, о чём текст.
Короткий текст, наоборот, пройдёт норму с запасом, даже переспамленный. Если в тексте на 300 слов одно слово стоит 25 раз, это каждое двенадцатое слово — перебор видно на глаз. А классическая тошнота — 5, «в норме».
Второе, что видно в данных: самое частое слово — почти всегда предмет страницы. По запросу про грыжу позвоночника это «грыжа» в 10 текстах из 12, по корму для кошек — «корм» в 9 из 10. А на трёх страницах бухгалтерских фирм с прайс-листами — «руб». Тошнота не знает, уместен ли повтор. Она видит только, что одно слово встречается чаще остальных.
Что проверять вместо тошноты
Если в ТЗ нужна цифра, пусть она приходит из выдачи по тому же запросу, а не с форума 2013 года.
- Считайте частоту слова на тысячу слов, а не сырые повторы: так тексты разной длины можно сравнивать.
- Сравнивайте с конкурентами по тому же запросу: сколько раз на тысячу слов это слово встречается у страниц из ТОПа — медиана и разброс.
- Смотрите на все слова темы, а не на одно самое частое. Перебор с одним словом заметен сразу, недобор с десятком других — нет.
- Слово, которое есть у большинства конкурентов, — язык темы, а не спам. В статье о грыже позвоночника «грыжа» и должна быть самым частым словом.
Тошноте остаётся честная роль, ровно та, что описана в справке Адвего: сравнивать две версии одного текста. Ещё она хорошо ловит слово, которое в коротком тексте повторяется через предложение.
Так устроено ТЗ в Словоправе, сервисе, который я делаю. Он берёт страницы из ТОП-20 по запросу и для каждого слова темы пишет, сколько раз его употребить в тексте типичного для выдачи объёма, если писать с той же частотой, что средняя половина конкурентов. Ваш текст он сравнивает с ними по частоте на тысячу слов, поэтому длина картину не путает. В примере ТЗ на сайте — запрос «как выбрать зимнюю резину» и текст примерно на 1760 слов. Слову «шина» там нужно 39–67 употреблений, это классическая тошнота от 6,2 до 8,2. По «норме» 7 переспамом стало бы всё, что больше 49, — а по выдаче это обычная частота для темы. Переспамом Словоправ называет другое: слово, которое у вас заметно чаще, чем у конкурентов. Слова, которые встречаются больше чем у половины конкурентов, он переспамом не считает никогда: это язык темы. Перебор по ним в ТЗ всё равно видно — как «больше, чем у топа», фактом, а не приговором.
Коротко
- У классической тошноты нет нормы — так пишет сам Адвего. Семёрку цитируют как минимум с 2013 года, и уже тогда — «с одного из форумов».
- В ТОП-20 Яндекса выше 7 — каждая четвёртая страница, а среди текстов длиннее 2000 слов — пять из семи.
- Тошнота растёт с объёмом. При типичной для ТОПа частоте самого частого слова семёрка — это примерно 1800 слов.
- Проверять стоит частоту каждого слова темы на тысячу слов в сравнении со страницами из ТОПа по тому же запросу.