Видимость бренда в нейросетях: почему сервисы дают разные цифры и что спросить до оплаты
Отчёты о доле голоса в нейросетях бренды уже несут в презентации и ставят в KPI. Но два сервиса могут показать одному бренду разные цифры, и оба посчитают без ошибок: каждый спрашивает нейросети о своём. Это признаёт и Ahrefs, разработчик сервиса Brand Radar: 20% на одном наборе вопросов нельзя автоматически сравнивать с 20% из другого инструмента с иной методикой. Значит, видимость бренда в нейросетях зависит от того, какие вопросы задали и как посчитали ответы, и платить за эту цифру без раскрытой методики рано.
Доля голоса в нейросетях меняется вместе с набором вопросов, их весом и знаменателем
Доля голоса в нейросетях, по-английски AI share of voice, — это доля ответов с упоминанием бренда среди всех ответов, где назван хотя бы один из отслеживаемых брендов. Так её определяет Ahrefs. Формула короткая, но в ней три места, где сервисы расходятся:
• Набор вопросов. Его составляет сервис или подрядчик, и у каждого он свой.
• Вес вопроса. Это вклад вопроса в итоговую цифру. В Brand Radar вопросы не считаются поровну: каждый весит столько, сколько его ищут в Google, с поправкой на платформу. В примере Ahrefs такое взвешивание на тех же ответах и тех же брендах опускает долю бренда до 31%: его упоминания приходятся на вопросы, которые люди задают реже всего.
• Знаменатель. Это то, что сервис принимает за общее количество при расчёте доли. AEOscore делит на все упоминания брендов в тех же ответах. AuthorityTech описывает открытый знаменатель, куда входят и бренды, которых нет в списке отслеживания.
При одном и том же числе упоминаний бренд получит разную долю, смотря на что делить. Поэтому знаменатель я бы искал в отчёте первым.
При тех же вопросах бренд виден в Алисе AI в шесть раз чаще, чем в DeepSeek
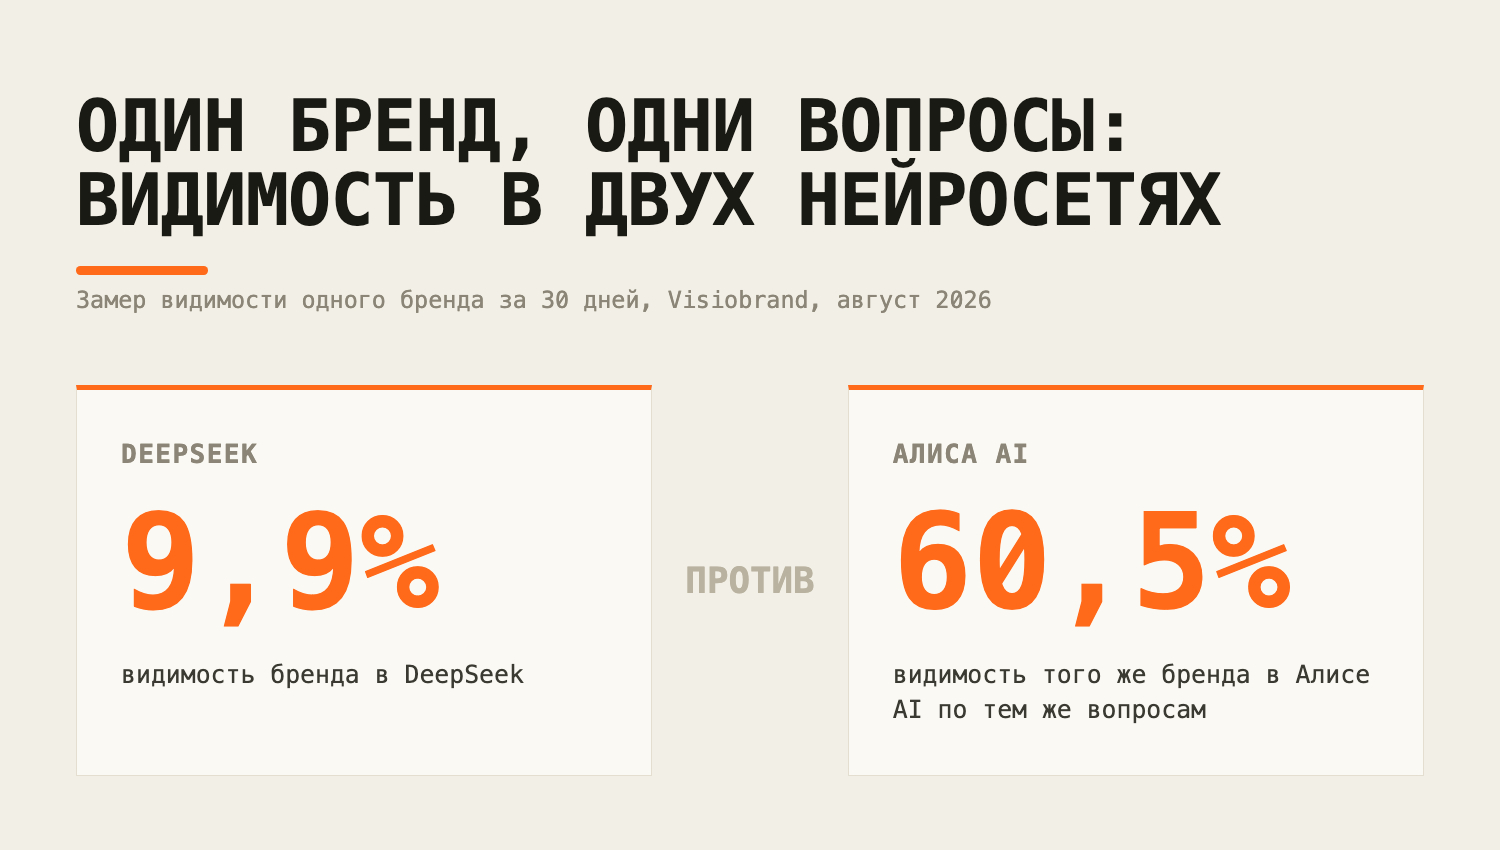
Сервис мониторинга Visiobrand 30 дней замерял видимость одного бренда по одним и тем же вопросам. В DeepSeek бренд набрал 9,9%, в Алисе AI уже 60,5%. Разрыв больше чем вшестеро, хотя ни бренд, ни вопросы не менялись, и средняя по всем нейросетям спрятала бы главное: где бренда почти нет. Замер опубликован в августе 2026 года.
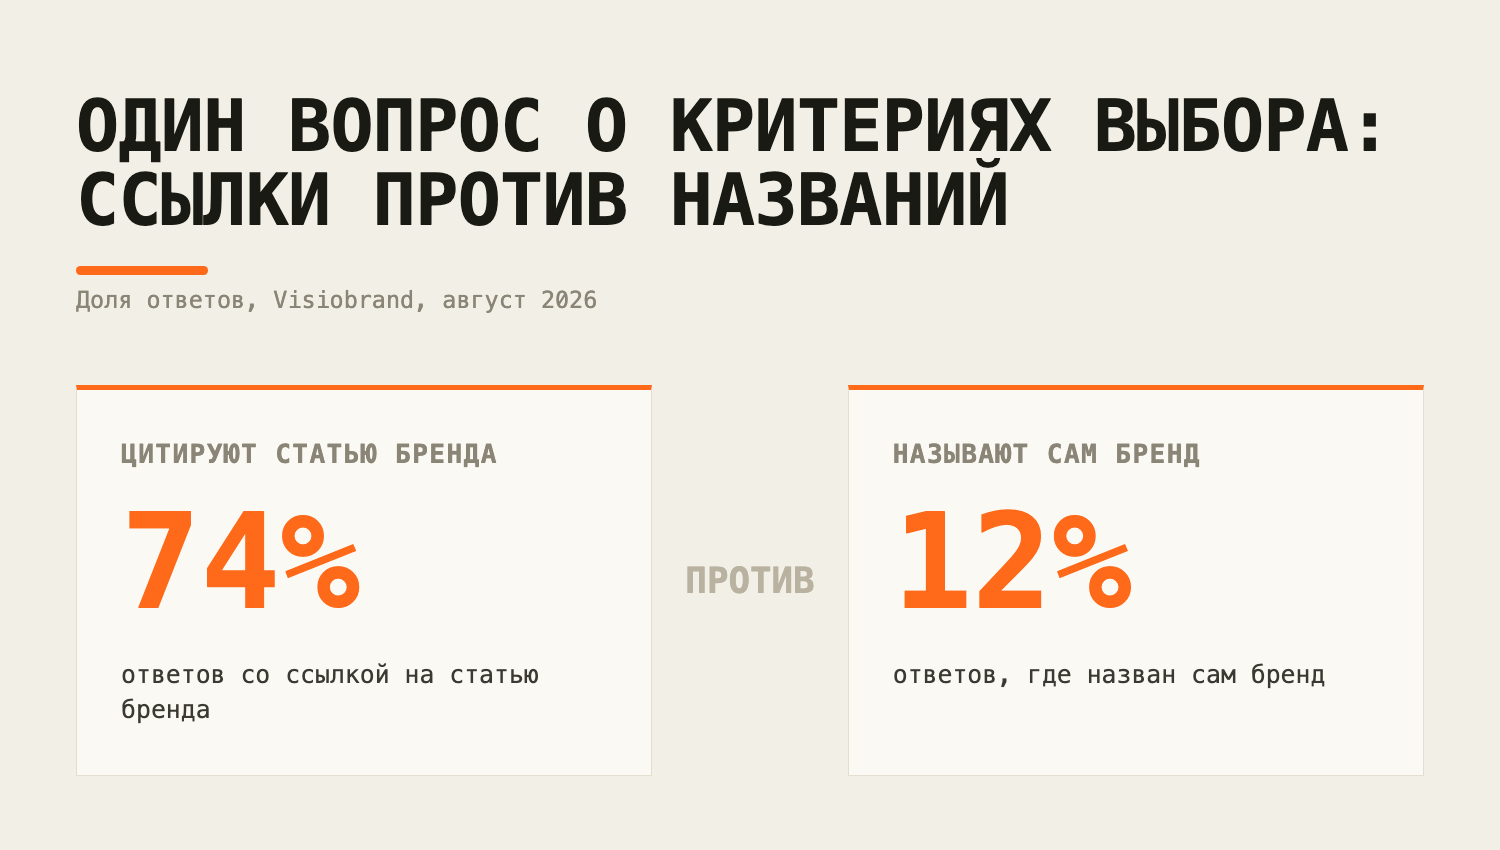
Число источников в ответе у нейросетей тоже разное. По Visiobrand, Алиса AI ставит в среднем 17,8 ссылки на ответ, Поиск с Алисой 13,2, ChatGPT 8,8, и от этого может зависеть, сколько компаний попадёт в список. Тип вопроса тоже меняет итог. По вопросу о критериях выбора статью самой Visiobrand цитировали в 74% ответов, а бренд назвали лишь в 12%. Сервис, который считает ссылки на сайт бренда, и сервис, который считает его названия, получат здесь 74% и 12% и могут оба назвать это видимостью. Это замер одного бренда одним сервисом, но масштаб разброса он показывает.
Нейросеть отвечает каждый раз по-разному, и устойчивой остаётся только частота упоминаний бренда
Один ответ нейросети почти ничего не говорит о бренде, частота упоминаний на многих прогонах держится лучше. В исследовании SparkToro 600 добровольцев прогнали 12 вопросов через ChatGPT, Claude и ИИ-ответы Google, всего 2 961 раз. По пересказу Search Engine Journal, шанс получить при повторе тот же список брендов у ChatGPT и Google меньше одного из ста. Для одного ответа это почти лотерея. Зато 142 человека написали вопросы про наушники каждый своими словами, и каждый из четырёх брендов, Bose, Sony, Sennheiser и Apple, всё равно встретился в 55–77% из 994 ответов.
Вопросы задавали в ноябре–декабре 2025 года, новые версии моделей могут вести себя иначе.
Ответы, которые сервис собирает автоматически, расходятся с тем, что человек видит в чате
Сервисы собирают ответы по-разному, и от этого меняется сама картина. В аудите на arXiv ChatGPT и Gemini в окне чата по одному и тому же запросу совпадали по сайтам-источникам в среднем лишь на 5,4%. Ответы через программный доступ (API, через него ответы собирают автоматически) совпадали с ответами в чате той же нейросети в среднем на 12,0% у ChatGPT и на 14,8% у Gemini. Авторы делают вывод: ни отдельные ответы, ни данные API нельзя считать тем, что видит покупатель.
Раскрытый метод выглядит так. По справке Semrush, ответы там берутся из реальных запросов без API, а ChatGPT отслеживается в режиме поиска в интернете. Ahrefs в широком индексе Brand Radar считает долю по заранее собранной базе ответов на вопросы с поиском, без нового прогона.
Сколько вопросов и повторов нужно, чтобы цифре доли голоса можно было верить
Единой нормы нет, и советы расходятся в разы. Сервис Trakkr, по описанию AuthorityTech, предлагает начинать с 20–50 вопросов и прогонять главные раз в неделю, причём свои пороги сам называет рабочими настройками по умолчанию, без статуса статистической нормы. AEOscore советует замороженный набор из 30–100 вопросов и не меньше трёх прогонов на каждую нейросеть. Автор исследования SparkToro советует задавать один вопрос минимум 60–100 раз и усреднять.
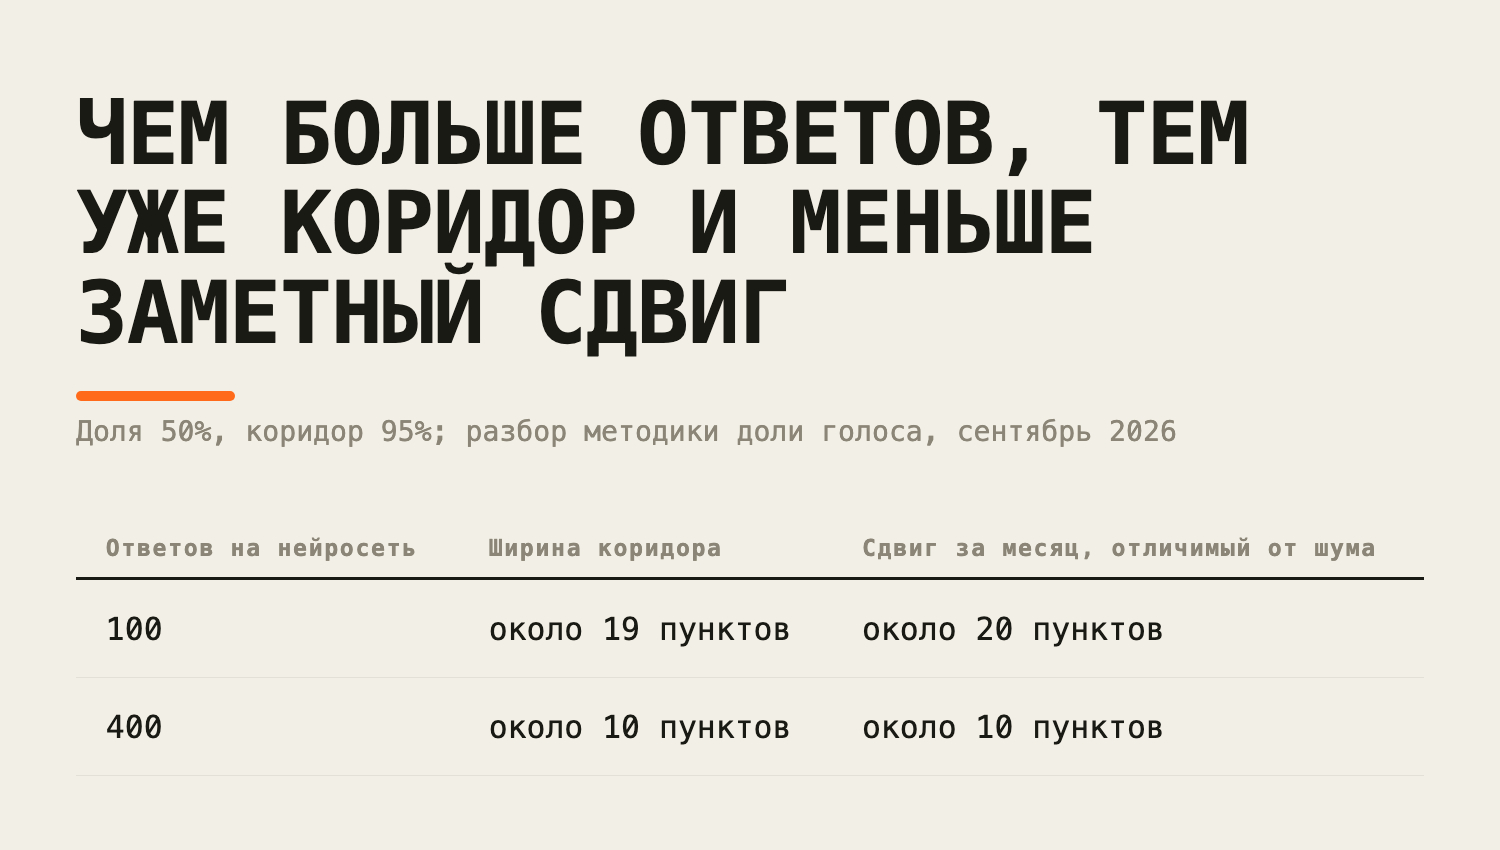
Автор разбора методики доли голоса посчитал, какую точность это даёт. Около 100 ответов на нейросеть при доле 50% дают коридор шириной около 19 пунктов целиком, то есть примерно по половине этой ширины в каждую сторону от 50%: с вероятностью 95% настоящая доля бренда лежит внутри него. Разницу между двумя долями считают в процентных пунктах. При 400 ответах коридор сужается примерно до 10 пунктов. Поэтому доля голоса 38% по 20 вопросам, заданным по одному разу, обещает точность, которой у неё нет: коридор вокруг неё шире разрыва между большинством брендов в категории. Тот же автор советует сначала расширять набор вопросов и только потом число повторов, потому что повторы одного вопроса похожи друг на друга, и делать хотя бы два прогона за период, чтобы видеть уровень шума. Для своей задачи объём можно выбрать по размеру сдвига, который нужно заметить: сдвиг порядка 10 пунктов за месяц отличим от шума при примерно 400 ответах на нейросеть, а при 100 ответах заметны лишь сдвиги около 20 пунктов.
Долю голоса можно сравнивать с конкурентами и прошлым месяцем только внутри одного замера
Сравнивать можно только замеры, сделанные одним методом на одном наборе вопросов. Цифры двух сервисов между собой несопоставимы, как и цифры одного сервиса до и после смены списка вопросов. С конкурентами share of voice в нейросетях сравнивают внутри одного отчёта: те же вопросы, те же нейросети, тот же знаменатель, и конкуренты названы заранее. С прошлым месяцем сравнивают только при замороженном наборе вопросов, и даже тогда сдвиг должен быть крупным. При 100 ответах на нейросеть в месяц изменение отличается от шума примерно с 20 пунктов, при 400 ответах примерно с 10. Условный рост с 18% до 24% при 100 ответах ещё шум, хотя в презентации он выглядит как успех.
Что спросить у подрядчика по мониторингу бренда в нейросетях до оплаты
• Какие вопросы входят в набор, кто их составил и можно ли увидеть список целиком?
• Сколько раз каждый вопрос задают за период?
• Какие нейросети входят в замер: ChatGPT, GigaChat, Алиса AI, Perplexity или только часть из них?
• Как собраны ответы: автоматически через API или так, как их видит человек в чате, с поиском в интернете или без него?
• Что стоит в знаменателе и взвешены ли вопросы по тому, как часто их задают?
• Какой у цифры разброс: есть ли коридор погрешности или хотя бы два прогона за период?
Если подрядчик не может показать список вопросов и число повторов, он продаёт цифру, которую нельзя проверить.
Замер видимости в ответах ИИ-моделей показывает направление, но не точный процент
От замера стоит ждать направления: растёт видимость бренда или падает, в каких нейросетях и на каких вопросах его называют, а где нет. Так подаёт свои данные и Semrush: тональность и долю голоса бренда он обновляет раз в неделю и называет направляющим сигналом. Методика важнее всего брендам в широких категориях, где ответы разбросаны, и тем, кто вписывает долю голоса в KPI или договор с подрядчиком. Лидерам узких ниш проще: по SparkToro, агентство Smartsites назвали в 85 из 95 ответов Google на просьбу порекомендовать консультантов по маркетингу для интернет-магазинов. Таким брендам точный процент мало что добавит.
Доля голоса измеряет только видимость. Трафик и возврат вложений — следующие уровни замера, которые постоянно смешивают, и цифра из презентации легко превращается в обещание, которого она не давала.
Одна цифра доли голоса без списка вопросов, числа повторов и перечня нейросетей — маркетинговый артефакт, а не метрика. Бренд, который ставит её в KPI, рискует платить за шум. Подрядчик обязан раскрыть методику, а сравнивать можно только замеры, сделанные одним методом на одном наборе вопросов.