Что под капотом у SaaS-сервисов расшифровки анализов: разбираю архитектуру на живом примере
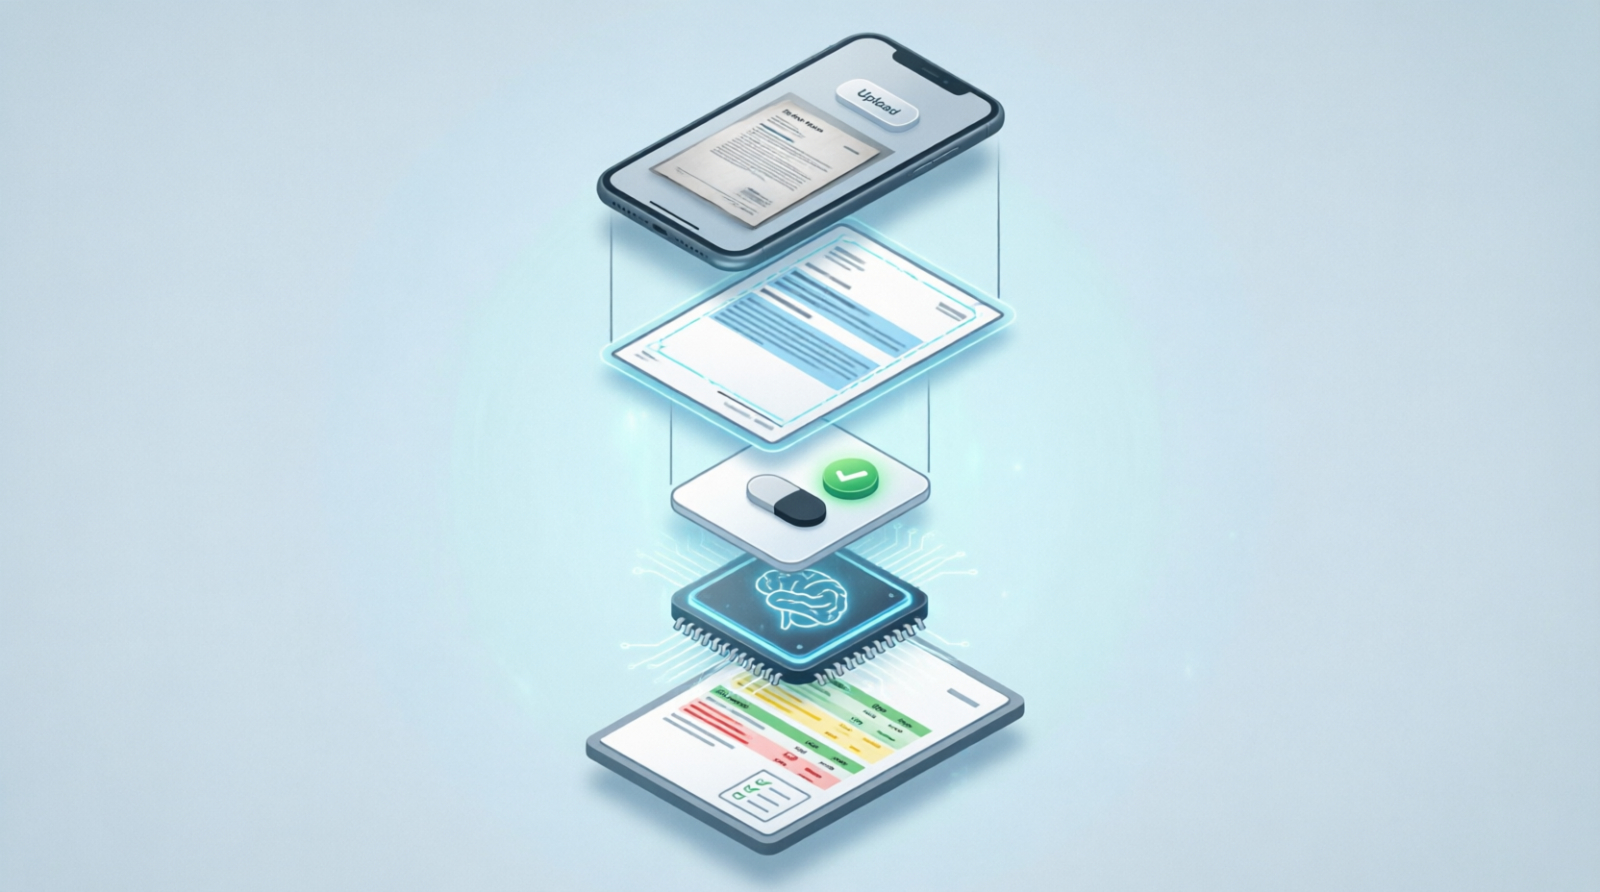
Лабораторный бланк в 2026 году выглядит так же, как пятнадцать лет назад: таблица, аббревиатуры, референсные интервалы. Врач на приёме проводит с ним две минуты. Вакуум между «цифры на руках» и «понятно, что с этим делать» заполнили сервисы на базе LLM. Я разобрал несколько подходов в режиме чёрного ящика и рассказываю, как устроены такие продукты изнутри — и какими решениями стоит воспользоваться в своём SaaS, даже если он не про медицину.
Правила игры: как я смотрел
Сразу о методике, чтобы понимать цену каждому выводу ниже. Все сервисы я смотрел глазами обычного пользователя и глазами фронтендера с открытым DevTools: сетевые запросы, поведение форм, оферты, политики конфиденциальности, публичные FAQ. Загружал синтетические бланки с выдуманными ФИО и значениями, чтобы трезво оценить возможности каждого метода. В чужие бэкенды я не заглядывал и заглянуть не мог: всё, что ниже, — либо наблюдаемо снаружи, либо написано в документах самих сервисов. Поэтому часть «архитектуры» в статье — честная реконструкция по косвенным признакам, и я это помечаю по ходу.
Три способа построить расшифровку
Способ первый: универсальные чат-боты. Загрузить фото бланка в ChatGPT или попросить Алису с YandexGPT «объяснить мои анализы».
Бесплатно, работает, но есть три «но»:
- Модель не калибрует нормы по полу и возрасту (а они отличаются радикально);
- Не отвечает за структуру ответа (сегодня простыня текста, завтра три строки);
- Ничем не ограничена в фантазиях.
Плюс на пользователе остаётся сама постановка задачи: сфотографировать так, чтобы OCR справился, и придумать правильный вопрос.
Способ второй: инструменты самих лабораторий.
В личных кабинетах крупных лабораторий есть референсы напротив каждого показателя, иногда — платная консультация врача по результатам. Надёжно, но фрагментарно: у каждой лаборатории свои единицы и диапазоны, а человек, сдавший биохимию в одном месте и гормоны в другом, остаётся с двумя несводимыми таблицами.
Способ третий: специализированные AI-SaaS.
Узкая заточка под одну задачу: бланк на входе, структурированный отчёт на выходе. Именно этот класс интересен продукт-людям, потому что в нём уже кристализовались паттерны, которые переносятся в любой SaaS с дорогой операцией под капотом. Дальше разбираю его на самом показательном примере — российском сервисе расшифровки анализов vrach.info.
Кейс: что видно снаружи в специализированном сервисе
Вход: форматы как зеркало пользовательских болей
Приём файлов: JPG, PNG, HEIC, PDF многостраничные документы (до 30 МБ).
Звучит просто, но это маркер зрелости продукта. Поддержка HEIC — признание того, что половина пользователей не знает, в каком формате снимает их iPhone, а сервис без проблем работает с фотографиями с "айфона". Многостраничность — признание того, что реальная биохимия с гормонами это три-пять страниц, а не одна картинка.
Два запроса вместо одной кнопки
Самое интересное видно во вкладке Network. После выбора файла уходит POST /upload/stage, в ответ прилетает идентификатор сессии и предзаполненные пол с возрастом. Затем интерфейс показывает форму «проверьте данные и при необходимости исправьте» — и только после клика уходит второй запрос, POST /upload/confirm/{id}. Дорогой вызов модели стартует после него.
Зачем дробить то, что могло быть одной кнопкой? У меня три гипотезы, все косвенно подтверждаются поведением формы:
- Референсные интервалы зависят от пола и возраста, а экстрактор может считать их из шапки бланка неверно — в детском бланке, например, часто стоит возраст родителя-плательщика. Шаг подтверждения перекладывает калибровку на человека, который знает лучше.
- Дорогая LLM-операция не стартует, пока не пройден дешёвый шаг; мусор (смаз, пустой скан, файл не того типа) отсекается до того, как сожжены токены.
- Пауза даёт пользователю момент контроля в сценарии, где контроль особенно ценен, — в медицинском. Косвенные подтверждения: валидация возраста в разумных границах и ошибка «дождитесь завершения загрузки файла» при преждевременном нажатии кнопки — классическая защита от гонки между интерфейсом и сетью.
Модель и выдача: мостик к врачу вместо конкуренции с ним
В FAQ сервис заявляет GPT-4o. Выдача — не стена текста, а структурированный отчёт: цветовая маркировка отклонений (зелёный / жёлтый / красный), объяснение каждого показателя простым языком, справочник по питанию и — самое любопытное — чек-лист вопросов врачу. Этот последний элемент я считаю главной продуктовой находкой ниши: сервис не пытается заменить врача (юридически нельзя и продуктивно глупо), а выдаёт пользователю готовую повестку на приём. Этическое напряжение «ИИ против медицины» снимается одним блоком в отчёте.
Приватность: что заявлено и что проверяемо
Оферта и политика заявляют: передачу по TLS, автоматическое обезличивание (удаление ФИО и контактов с бланка до обработки), немедленное удаление оригинала после обработки и хранение готового отчёта в зашифрованном виде на серверах в РФ в течение 30 дней. Что из этого проверяемо снаружи?
Проверяемо: передача действительно идёт по HTTPS; в отчёте по синтетическому бланку выдуманное ФИО не появляется; «лишних» персональных данных в результатах нет.
Непроверяемо: что происходит внутри контура между приёмом файла и вызовом модели. Сервис заявляет полное обезличивание загружаемых файлов (удаление ФИО, телефонов, адресов и т.д.) до отправки в нейросеть. Вероятнее всего для этого используется технология OCR, с помощью которой извлекаются текстовые данные с изображения: персональные данные удаляются, а обезличенные показатели анализов отправляются дальше в нейросеть.
Экономика: почему 199 рублей — это не жадность
Краткое резюме на экране бесплатно, полный PDF-отчёт на почту — 199 рублей. Оплата осуществляется через безопасный сервис ЮКасса, чек приходит после оплаты также на почту. В оферте прописан возврат, если по техническим причинам не удастся расшифровать анализы. В эпоху «бесплатного ChatGPT» paywall выглядит анахронизмом только на первый взгляд: вызов мультимодальной модели на трёх-пятистраничный бланк стоит заметных денег за запрос, а полностью открытый бесплатный вход мгновенно затапливается ботами и скриптами. Символическая цена здесь работает и как фильтр, и как юнит-экономика в одной кнопке.
Какие есть нюансы
Независимый разбор без претензий не бывает независимым, поэтому вот честный список наблюдений:
- Многостраничные бланки обрабатываются до двух минут: сам сервис пишет в FAQ о диапазоне 15–120 секунд, но пользователь, приученный чат-ботами к мгновенному ответу, на второй минуте начинает нервничать, хоть и расшифровка приходит стабильно.
- Рукописные пометки врача на полях фактически теряются: OCR рукописного текста до сих пор лотерея, и сервис не предупреждает об этом заранее. Хотя, все уважающие себя клиники используют только печатный текст.
- Сценарий «наблюдать показатели в динамике» отсутствует: сравнения нескольких бланков за разные даты вы не получите.
- Нет диалогового чата с нейросетью, чтобы уточнить детали.
Это наблюдения, а не приговор: нише расшифровки анализов два года, архитектура ещё кристаллизуется.
Что можно взять на заметку в свой продукт
- Двухшаговость для дорогих операций. Разделяйте дешёвый шаг (принять, извлечь метаданные, дать человеку подтвердить) и дорогой (LLM, генерация, интеграции). Экономит деньги и снижает поток жалоб «результат не про меня» — проверено не только на медицине.
- Бесплатный предпросмотр как воронка доверия. В нишах с высоким страхом (медицина, финансы, юристы) люди не платят за кота в мешке. Показанная бесплатно часть результата повышает конверсию в оплату именно потому, что снижает страх, а не потому, что демонстрирует щедрость.
- Приватность как аргумент продажи, а не сноска. Когда главный барьер покупки — «куда денутся мои данные», конкретные пункты политики (что удаляется, где хранится, сколько живёт) работают лучше прилагательного «надёжный» в заголовке.
- Мостик к профессионалу вместо конкуренции с ним. Чек-лист вопросов специалисту, рекомендация отнести результат эксперту, оговорка о границах ИИ — всё это возвращает пользователя в офлайн-воронку с вашим брендом в голове и снимает этические претензии к продукту.
- Форматы как эмпатия. HEIC, лимиты под реальные файлы, многостраничность — это не фичи для презентации, а уважение к фактическому поведению пользователя. Вход, на котором отваливаются реальные люди, убивает всю остальную воронку.
Финал
Ниша расшифровки анализов повторяет путь симптом-чекеров 2010-х, но на новой технической базе: вместо жёстких деревьев решений — мультимодальные LLM, вместо запугивания диагнозами — структурированный отчёт и мостик к врачу. Архитектура таких сервисов уже сложилась в узнаваемый паттерн: «бланк → извлечение → подтверждение человеком → модель → отчёт → мостик к специалисту». Следить за нишей я продолжу: динамика показателей, интеграции с лабораториями и страховые сценарии — вот где будут следующие продуктовые открытия. А описанные выше паттерны, подозреваю, переживут и эту нишу, и текущую моду на LLM. Все выводы сделаны на основе открытых данных и личных экспериментов с синтетическими данными.