Почему аптеки теряют трафик: разбираем ошибки двух крупных сетей
Команда «Паньшин Групп» провела SEO-аудиты сайтов двух крупных аптечных сетей. Один проект терял трафик, второй не рос в течение года. Несмотря на разную региональную структуру, мы обнаружили ряд общих проблем: от технических дублей и ошибок в метатегах до слабых карточек товаров и разрыва между блогом и каталогом.
О проектах
Первый сайт работает на домене старше десяти лет. В поисковую индексацию открыто около 450 тыс. страниц, а регионы представлены папками на основном домене. Средний поисковый трафик составлял около 140 тыс. визитов в месяц, причем примерно две трети приходили из Google. С марта по июнь показатель сократился почти вдвое.
Второй сайт существует более 15 лет и продвигается через сотни региональных поддоменов. Его поисковый трафик в течение года колебался, но устойчивого роста не показывал.
Масштаб и архитектура проектов различались, но после технического, контентного и коммерческого анализа список точек роста оказался практически одинаковым.
Специфика аптечного SEO
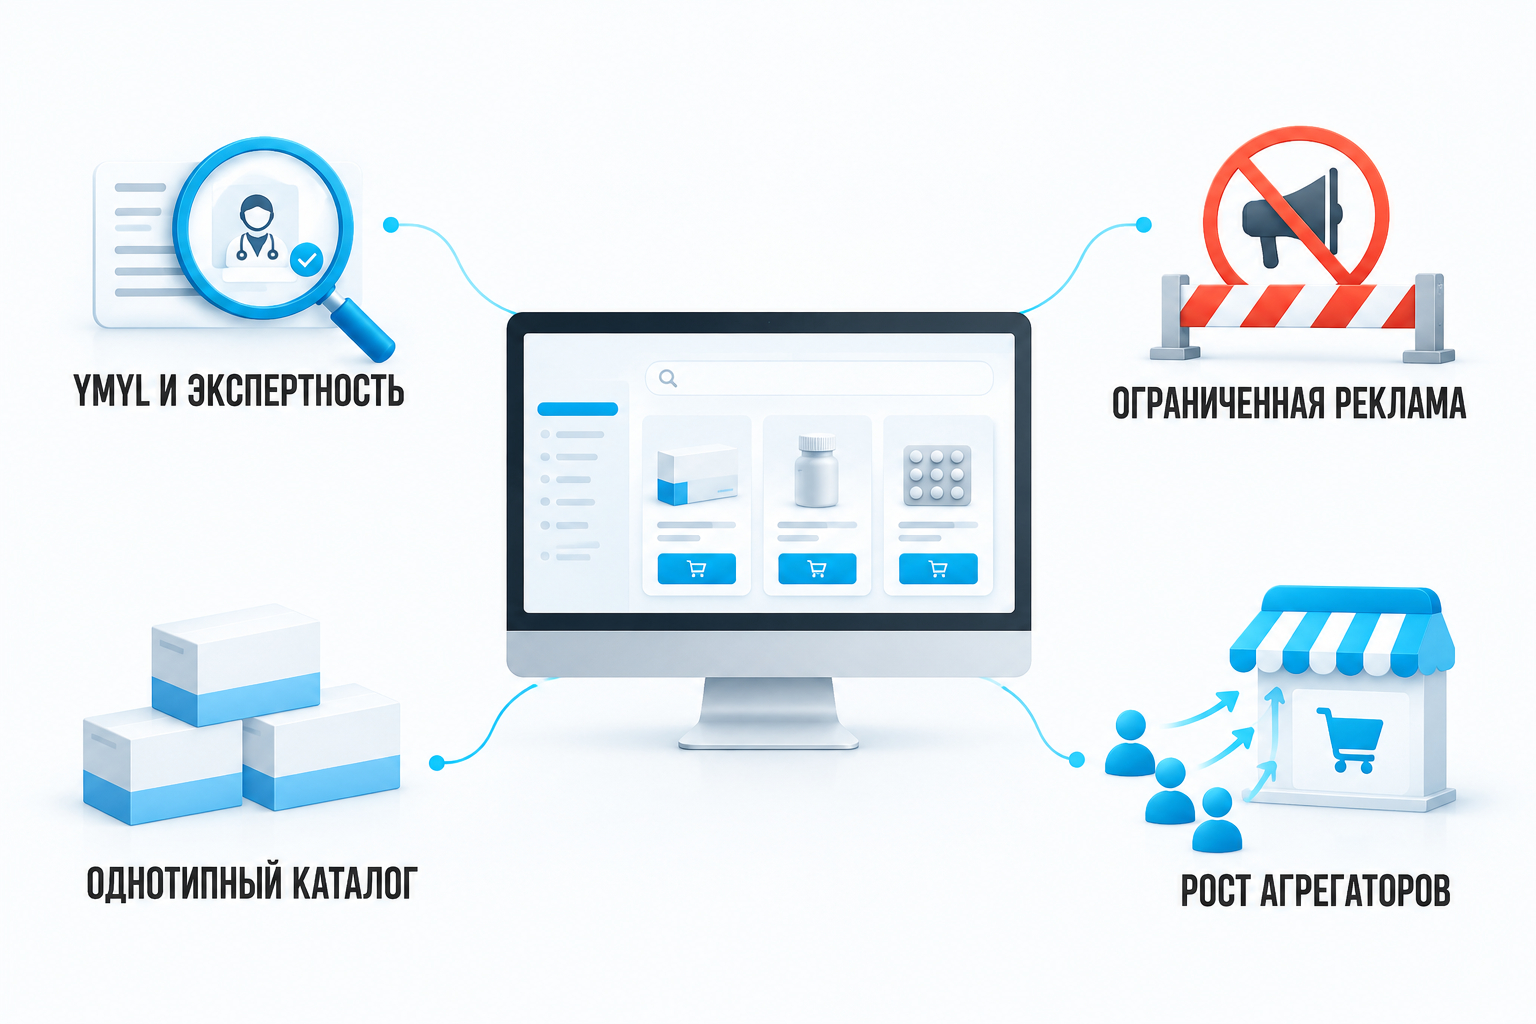
Аптечный сайт нельзя продвигать как обычный интернет-магазин. Каталог может включать сотни тысяч однотипных страниц. Карточки отличаются дозировкой, формой выпуска или производителем, но содержат одинаковые инструкции. Поисковой системе нет смысла сохранять в выдаче множество копий одного текста.
Одновременно медицинская и фармацевтическая информация относится к тематике YMYL. Яндекс и Google оценивают не только релевантность страницы, но и достоверность контента, авторство и возможность проверить компетенцию эксперта.
Дополнительную конкуренцию создают аптечные агрегаторы. Они аккумулируют ассортимент разных сетей и обладают высокой узнаваемостью, развитой ссылочной массой и большим количеством посадочных страниц.
Проблема 1. В индексе находятся дубли, а полезные страницы исключаются
У первой сети Яндекс проиндексировал около 207 тыс. страниц из 443 тыс., доступных поисковым роботам.
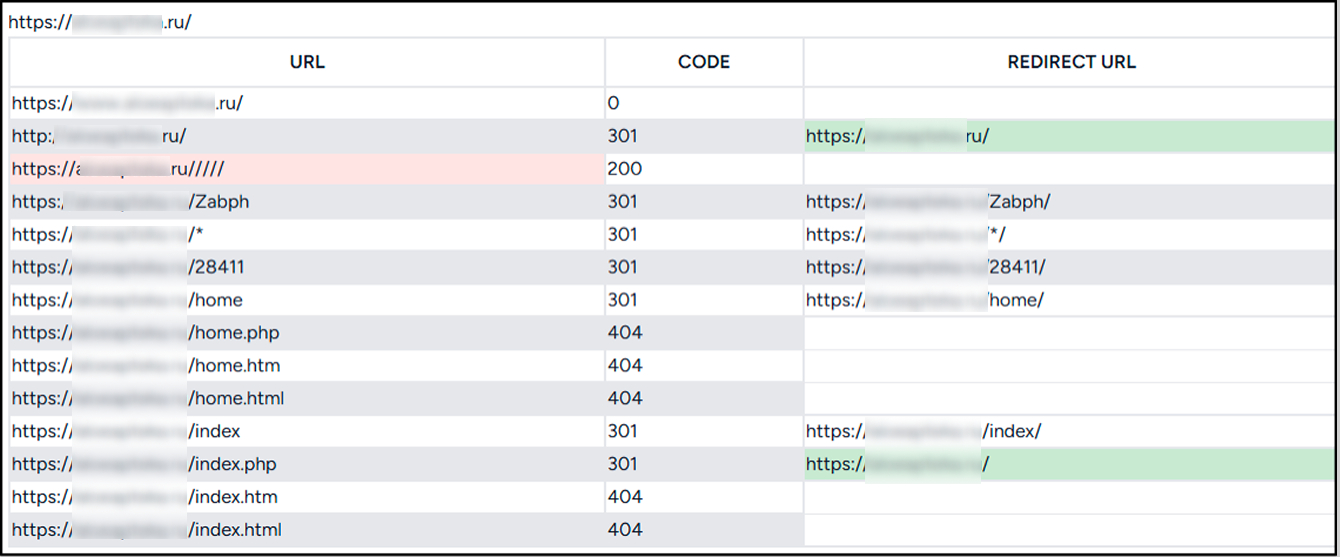
В sitemap находились некорректные URL, перенаправляющие посетителя на главную. Даты последнего обновления страниц не передавались. Из-за отсутствия настройки Clean-param в индексе накапливались адреса с GET-параметрами. Главная и разделы также открывались по URL с несколькими слешами подряд и возвращали код 200 вместо перенаправления на основной адрес.
У второй сети разница между поисковиками достигала примерно 30 раз: Яндекс находил около 43 тыс. страниц, а Google — более миллиона. Еще около 36 тыс. URL одного регионального поддомена были исключены Яндексом как малоценные или маловостребованные.
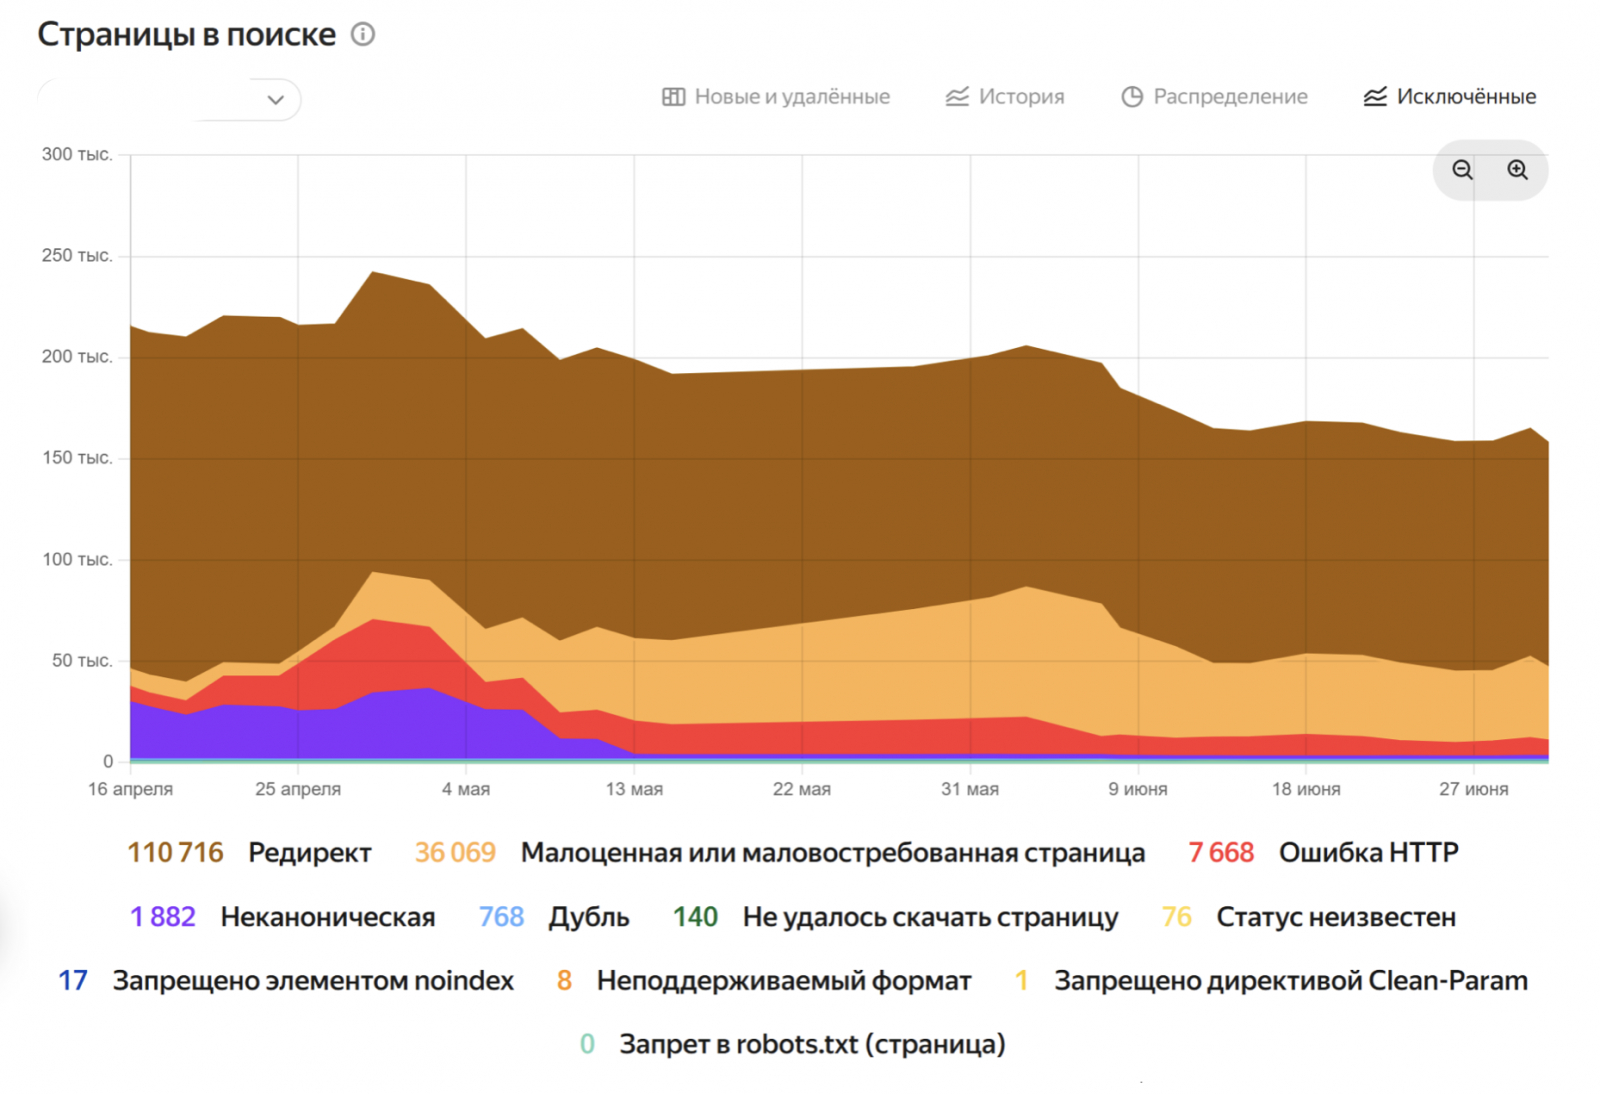
Мы предложили начать с технической очистки: убрать некорректные адреса из sitemap, добавить даты обновления, настроить редиректы и обработку параметров. После этого — разделить статистику индексации по типам страниц и контролировать ее в отдельном дашборде.
Находить и устранять такие ошибки помогает регулярная SEO-диагностика — точки проверки в материале «Готов ли сайт к SEO: чек-лист из 25 пунктов для маркетолога».
Проблема 2. Одинаковая стратегия применяется ко всем регионам
Первая сеть использовала региональные папки на одном домене. Тексты категорий в разных городах практически не отличались и почти не содержали локальной информации.
Мы предложили оставить общий экспертный блок о товарной группе, а региональную часть формировать из актуальных данных: ассортимента, цен, наличия и способов получения заказа в конкретном городе.
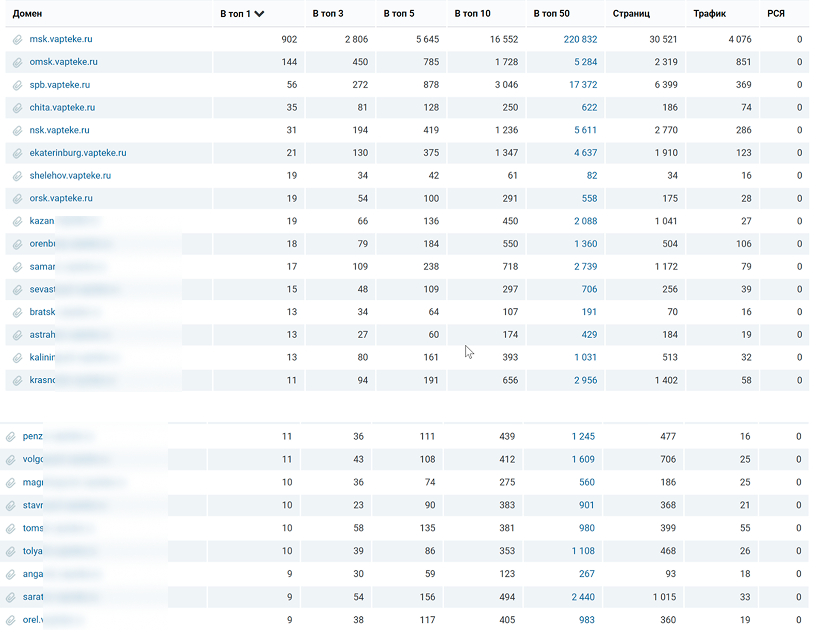
У второй сети использовались сотни поддоменов. Их видимость сильно различалась: основная часть запросов и расчетного трафика приходилась на несколько городов, а некоторые поддомены сервисы аналитики не обнаруживали.
Одинаково развивать сотни регионов нецелесообразно. Приоритетные города следует выбирать по выручке и потенциалу спроса, а их индексацию и поисковую динамику проверять отдельно в Яндекс Вебмастере и Google Search Console.
Проблема 3. Ошибки в шаблонах распространяются на тысячи страниц
В крупном аптечном каталоге Title, Description и H1 генерируются автоматически. Поэтому одна ошибка в шаблоне затрагивает сразу большую часть сайта.
У первой сети оказалось более 6 тыс. страниц с одинаковым Title и почти 5 тыс. — с повторяющимся Description. В метатеги попадали бессвязные вставки ключевых слов. Заголовки H1 содержали некорректные словосочетания, а некоторые служебные блоки были размечены как заголовки.
У второй сети метатеги были слишком длинными и часто дублировались. На части приоритетных страниц отсутствовал информативный H1. В заголовки попадали сокращения из товарной базы, например «р-р» и «табл.», которые не соответствуют естественным поисковым формулировкам.
Редактировать тысячи страниц вручную не нужно. Мы предложили создать отдельные правила генерации метатегов для категорий, карточек товаров, форм выпуска и региональных страниц. Технические сокращения необходимо расшифровывать, а региональные переменные — подставлять только там, где они добавляют смысл.
Проблема 4. Категории и карточки не помогают выбрать товар
На обоих сайтах каталоги выполняли функцию базы данных, но слабо помогали пользователю ориентироваться в ассортименте.
В листингах не хватало информации о доставке и самовывозе, отзывов, рейтингов и популярных товаров. Первый экран карточки не всегда показывал основные характеристики и доступные формы выпуска.
Пользователь видел ассортимент, но не получал ответа на вопросы о различиях между группами товаров и критериях выбора.
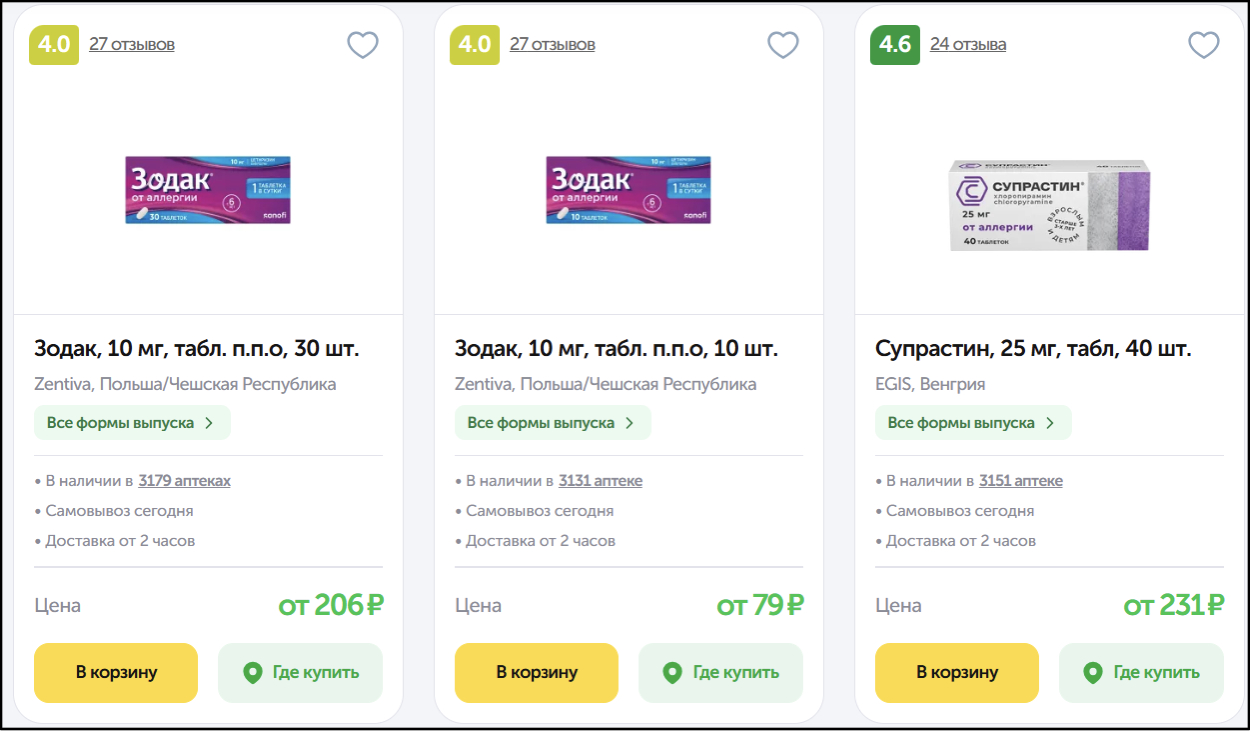
Мы предложили развивать структуру от общего раздела к более точным посадочным страницам: по торговому названию, действующему веществу, назначению, форме выпуска и дозировке. Экспертный блок категории можно сделать единым, а сведения о наличии, ценах и способах получения — динамическими для каждого региона.
Начинать такую переработку следует с товарных групп, наиболее важных для бизнеса, а не со всего каталога одновременно.
Проблема 5. Контент создается без управления поисковым спросом
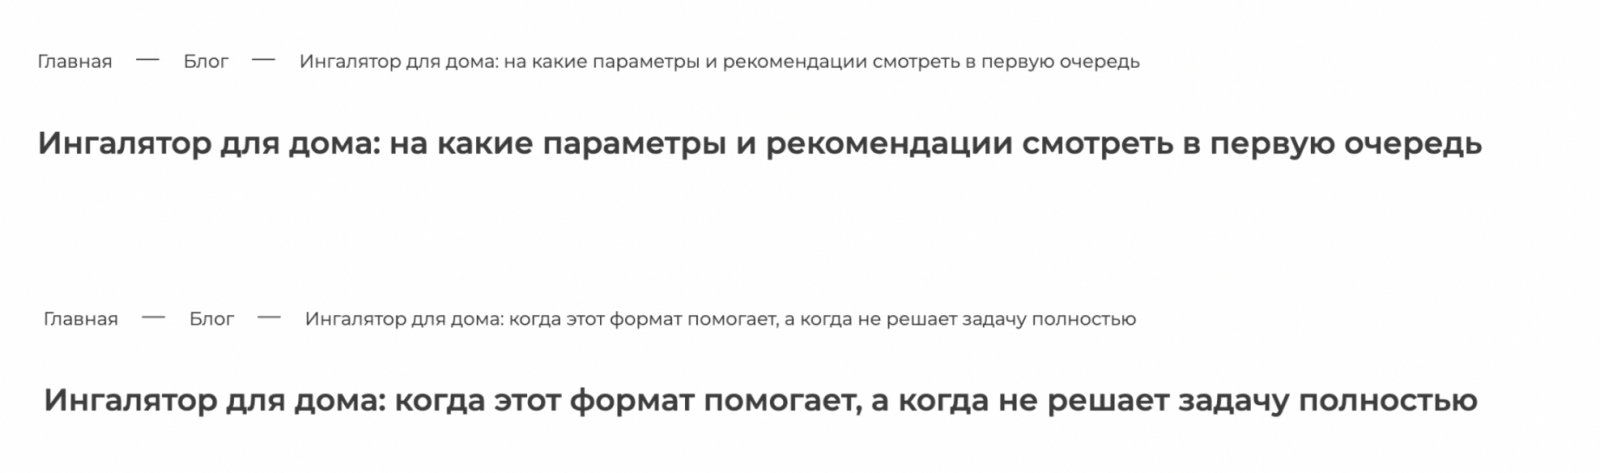
На сайте первой сети было много статей, но часть материалов отвечала на одинаковые или близкие запросы. Заголовки отличались, тогда как структура, рекомендации и маркированные списки повторялись.
Такие страницы конкурируют друг с другом. Поисковой системе сложнее определить, какой материал считать основным.
Авторы статей были указаны, однако их экспертность трудно было проверить. Имя не вело на полноценный профиль с образованием, квалификацией и специализацией. Информация о медицинском рецензировании отсутствовала, а источники не всегда сопровождались прямыми ссылками.
Мы рекомендовали временно остановить массовую публикацию, провести инвентаризацию блога и объединить статьи с одинаковым интентом.
У второй сети ситуация была обратной: материалов недостаточно для охвата спроса. В статьях не хватало информации об авторах, связанных публикаций и переходов в каталог. На отдельных страницах смешивались информационные и коммерческие задачи.
Для этого проекта мы предложили развивать блог по приоритетным для бизнеса направлениям и разделить материалы о заболеваниях, бытовых вопросах и выборе товаров.
Как собрать медицинскую редакцию и объединить в текстах знания SEO-специалиста, автора, редактора и клиники, мы разобрали в кейсе МЦ «XXI век».
Проблема 6. Блог и каталог не связаны между собой
В обоих проектах статьи редко вели на категории и товары, а коммерческие страницы — на полезные материалы.
Карточки препаратов не предлагали аналоги, другие дозировки и формы выпуска. Если товар отсутствовал или не подходил посетителю, сайт практически не предлагал продолжить выбор.
Отсутствие таких связей ухудшает пользовательский путь и мешает поисковой системе понимать структуру каталога.
Мы предложили связать статьи, категории и карточки в единые тематические кластеры. Внутренние ссылки должны вести пользователя к следующему логичному действию, а не просто распределяться по страницам ради SEO.
Результат аудитов
По итогам работы обе сети получили план развития, выстроенный по приоритетам.
Первый этап — техническая очистка и контроль индексации. Пока поисковые роботы обходят дубли, некорректные адреса и малоценные страницы, расширение каталога и выпуск новых статей только увеличивают масштаб проблемы.
Следующий этап — работа с регионами и шаблонами. Необходимо выбрать приоритетные города, исправить правила формирования метатегов и устранить массовые ошибки в заголовках.
После этого можно усиливать категории и карточки, развивать экспертный контент и соединять блог с каталогом.