DDoS уже бьёт не только по сайту: как атака на IT-систему может остановить выплаты, продажи и работу партнёров
Реклама приводит покупателей, каталог открывается, товары добавляются в корзину. Но оформить заказ не получается. У части клиентов деньги списаны, а покупка всё ещё отображается как неоплаченная. Партнёры не видят новых заявок, поддержка получает вопросы, на которые пока не может ответить.
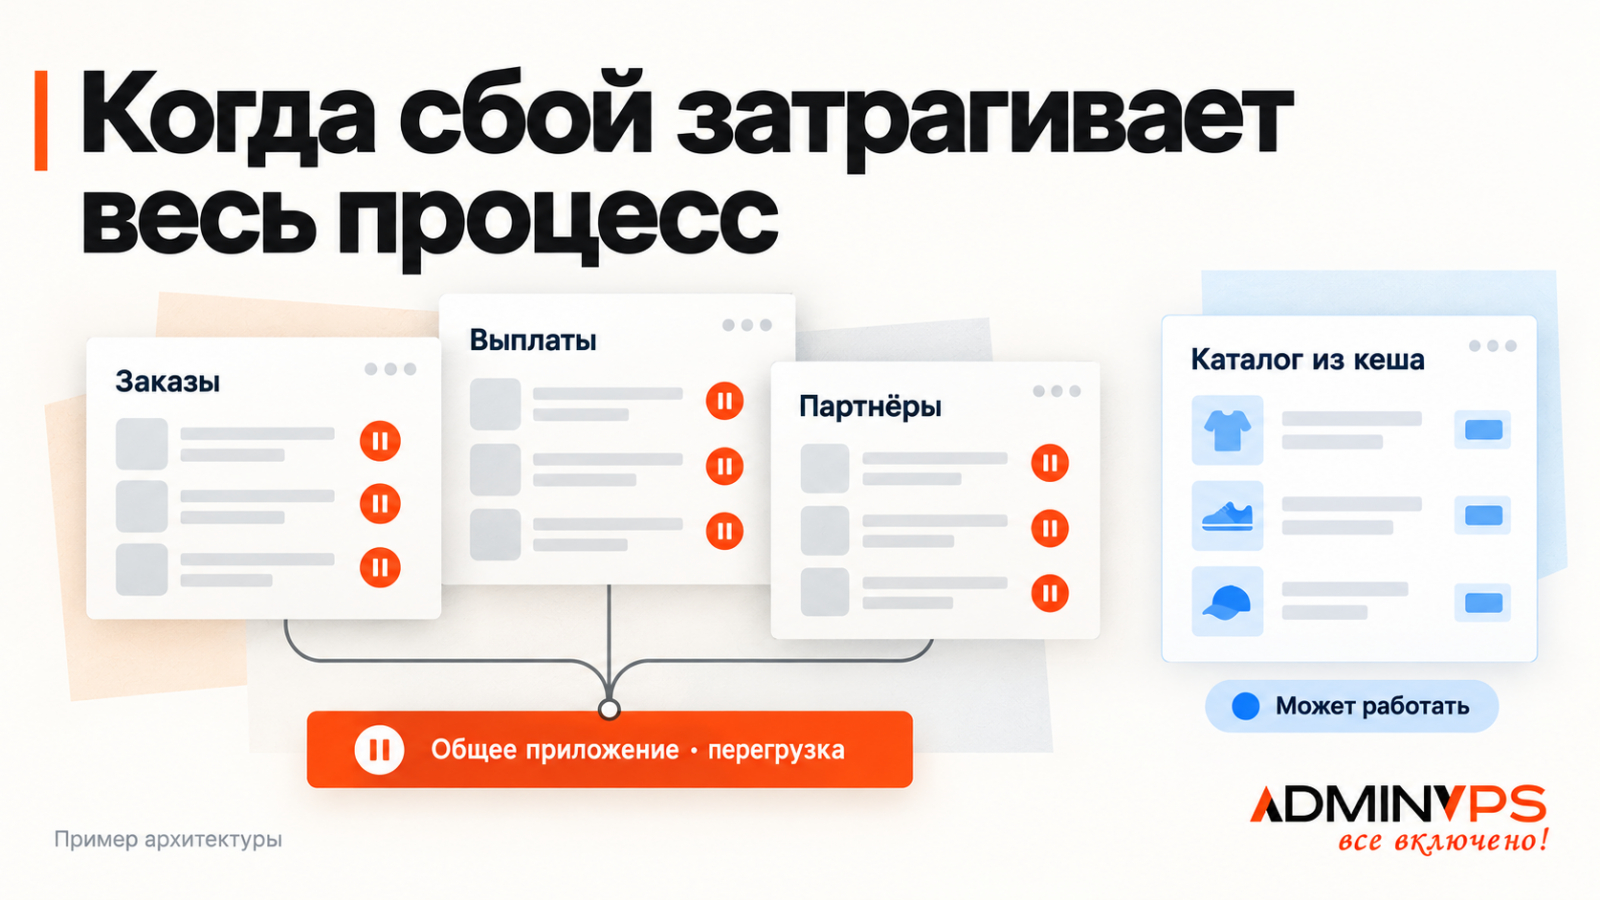
Так может выглядеть DDoS-атака на систему, которая обслуживает бизнес-процессы. Чтобы нарушить работу компании, необязательно сделать недоступным весь сайт. Достаточно перегрузить компонент, от которого зависят заказы, подтверждение платежей или обмен данными.
Это типовой сценарий, а не история конкретной компании. Он показывает, почему доступность главной страницы ещё не означает, что бизнес работает.
Почему работающий сайт может перестать продавать
DDoS — распределённая атака на отказ в обслуживании: множество источников создают нагрузку, которая мешает обычным пользователям и системам обращаться к ресурсу. Перегрузка может затронуть канал связи, обработку соединений или само приложение.
На уровне приложения мишенью могут стать поиск, авторизация и другие операции, требующие вычислений и обращения к данным. В документации AWS описаны атаки, при которых запросы заставляют исходный сервер каждый раз выполнять работу вместо выдачи сохранённого результата из кеша. Поэтому для оценки угрозы важен не только объём трафика, но и то, какую нагрузку создаёт каждый запрос.
Допустим, каталог, личный кабинет и обработка заказов используют общую базу данных. Перегрузка одного раздела может замедлить остальные. При этом часть страниц продолжит открываться из кеша — временного хранилища готовых данных. Со стороны будет казаться, что проблема ограничена отдельной кнопкой.
Если приложение размещено на VPS, при проектировании важно учитывать зависимости между его компонентами. Дополнительные ресурсы могут помочь выдержать нагрузку, но не устраняют общую точку отказа и не заменяют фильтрацию атакующего трафика.
Для руководителя полезнее вопрос «может ли клиент завершить покупку?», чем «открывается ли сайт?». Первый проверяет результат, второй — только один участок процесса.
Как сбой доходит до платежей и выплат
Покупка обычно проходит через несколько систем. Сайт создаёт заказ, платёжный сервис обрабатывает оплату, затем приложение получает информацию о результате и меняет статус заказа.
Один из механизмов такого обмена — webhook: автоматическое уведомление, которое одна система отправляет другой. Например, платёжный сервис сообщает магазину, что оплата прошла. Если адрес, принимающий уведомления, недоступен, магазин может узнать о выполненной операции с задержкой.
Документация ЮKassa предусматривает повторную доставку уведомлений при некорректном ответе получателя. Однако такие повторы имеют ограничения и не заменяют восстановление собственной системы.
Отсюда возникает неприятная для клиента ситуация: платёж прошёл, а магазин пока этого не отразил. Поддержка видит неоплаченный заказ и рискует дать неправильную рекомендацию — например, предложить оплатить его ещё раз.
С выплатами продавцам, исполнителям или партнёрам возможны разные сценарии. Если недоступна система подготовки выплат, поручение ещё не отправлено. Если запрос ушёл, но ответ не получен, результат требует проверки. Если не обработано уведомление, деньги могли быть перечислены, а внутренний статус остался прежним.
Отсутствие ответа не доказывает, что финансовая операция не состоялась. Поэтому восстановление нельзя сводить к повторной отправке всех зависших поручений.
Для безопасного повтора используются идентификаторы операций и механизмы идемпотентности — защиты от повторного выполнения одного действия. При соблюдении условий API система распознаёт повторный запрос и не создаёт вторую операцию. Такая возможность, например, описана в документации Stripe. Её условия и ограничения нужно проверять у используемого платёжного провайдера.
DDoS сам по себе не означает кражу денег или утечку данных. В описанном сценарии проблема связана с доступностью и согласованностью информации. Но даже временная неопределённость статусов требует финансовой сверки, а не только вмешательства администратора.
Почему последствия выходят за пределы компании
Партнёрские процессы часто зависят от API — программного интерфейса, через который системы обмениваются данными без участия человека. Так магазин передаёт заказы службе доставки, получает остатки со склада или отправляет партнёру подтверждение оказанной услуги.
Если такой интерфейс недоступен, партнёр может не получить заказ или продолжить показывать устаревшую информацию. Масштаб последствий зависит от устройства обмена: сохраняются ли события, как долго они хранятся, предусмотрены ли повторная передача и последующая сверка.
Дополнительную нагрузку способны создать сами участники обмена. Не получив ответа, их приложения начинают повторять запросы. Если делать это часто и одновременно, восстановление усложняется.
AWS рекомендует ограничивать число повторов, увеличивать интервалы между ними и добавлять небольшую случайную задержку. Это помогает распределить обращения во времени, чтобы они не приходили новой волной.
Так технический сбой превращается в операционный: партнёры ждут подтверждений, сотрудники проверяют данные вручную, поддержка разбирает расхождения. Атака уже может быть подавлена, но накопленные задачи ещё не обработаны.
Что происходит с рекламой и аналитикой
Во время частичного сбоя рекламная кампания может продолжать приводить посетителей. Посадочная страница доступна, объявления работают, но следующий шаг — регистрация, заявка или оплата — не выполняется.
Маркетолог видит падение конверсии. Без информации об инциденте его легко принять за проблему аудитории, креатива или предложения. Тогда команда начинает менять рекламу, хотя причина находится в обработке запросов.
Возможна и обратная ситуация: операция выполнена, но событие о ней не передано в аналитику. Поэтому снижение числа зафиксированных покупок нельзя автоматически считать таким же снижением фактических продаж.
Для оценки последствий нужно сопоставить данные рекламных кабинетов, заказов, платёжного сервиса и CRM. Отдельно учитывать потерянные покупки, покупки с задержкой и расходы на разбор инцидента.
Всю выручку, ожидавшуюся за время сбоя, некорректно записывать в фактический убыток: часть клиентов может завершить покупку позже. Для оценки финансового результата также имеют значение маржа, возвраты и дополнительные затраты.
Решение об ограничении рекламы стоит привязать к конкретному сценарию. Если заказ не создаётся, продолжать вести людей в эту воронку бессмысленно. Если нарушен один способ оплаты или отдельный региональный сервис, меры могут быть точечными. Возвращать обычный объём трафика следует после проверки покупки целиком.
Ошибки, которые увеличивают простой
Проверять только главную страницу. Она может быть доступна из кеша, пока приложение не обрабатывает операции. Нужен контроль ключевых действий и задержек обмена, а не только ответа сайта.
Применять одинаковую защиту ко всем обращениям. Проверка, которую способен пройти человек в браузере, может остановить автоматический запрос платёжного сервиса. Правила для посетителей и интеграций следует разделять. При этом служебным запросам нужны предусмотренные провайдером проверки подлинности.
Считать второй сервер готовым резервом. Второй экземпляр приложения не поможет, если он зависит от того же перегруженного канала, общей базы или недоступного сервиса авторизации. Нужно проверять независимость резервного пути и порядок переключения.
Повторять финансовые операции без выяснения результата. Массовый перезапуск заданий способен создать дубли, если приложение и API не защищены от повторного исполнения.
Считать открывшийся сайт концом инцидента. После восстановления доступа могут оставаться очереди задач, необработанные уведомления и расхождения статусов. Это отдельный этап работы.
Что предусмотреть до атаки
Описать критические операции и их зависимости
Начать стоит с простой рабочей таблицы. Для каждого процесса указать обслуживающие системы, допустимую задержку, ответственного и способ восстановления.
Особенно полезно пройти путь одной операции: от создания заказа до подтверждения оплаты и передачи партнёру. Такая проверка обнаруживает зависимости, которые не видны при обсуждении «защиты сайта» в целом.
Для выплат отдельно определить, где хранится подтверждённый реестр, как фиксируется отправка поручения и как проверяется окончательный результат. Сотрудники должны понимать разницу между «не отправлено», «отправлено, результат неизвестен» и «выполнено».
Уточнить границы защиты
Обсуждение администрирования серверов имеет смысл начинать с этой карты процессов: какие компоненты доступны извне, какие ресурсы они делят и кто отвечает за настройки приложения.
С хостинг-провайдером и поставщиком защиты нужно проверить охват конкретных адресов и протоколов, порядок действий при атаке и возможность обращения напрямую к исходному серверу в обход фильтрации.
На уровне приложения полезно предусмотреть ограничения запросов к ресурсоёмким операциям и возможность временно отключить второстепенные функции. Например, сложный поиск или формирование отчётов могут быть менее приоритетными, чем приём заказов.
Конкретные ограничения зависят от обычной нагрузки и поведения клиентов. Универсальный порог «для всех» может заблокировать легитимных пользователей и партнёров. Проверять настройки нужно на реальных сценариях работы.
Подготовить обмен к задержкам
Для критических событий нужны надёжное сохранение, контролируемые повторы и защита от дублей. Получение уведомления лучше отделять от длительной обработки: сначала проверить его подлинность и надёжно сохранить, затем поставить задачу в очередь — список операций, которые система выполнит по мере освобождения ресурсов.
Очередь позволяет пережить задержку, но её ёмкость и срок хранения конечны. Команда должна видеть не только количество задач, но и возраст самой старой: небольшая очередь тоже может содержать давно зависшую выплату.
Условия повторов, порядок событий и способы проверки статусов нужно брать из документации конкретной интеграции. Например, Stripe предупреждает о возможных повторных уведомлениях и рекомендует обрабатывать события асинхронно — отдельно от их приёма.
Проверить восстановление данных
Резервное копирование данных нужно для восстановления при повреждении данных, ошибочных изменениях или сопутствующем сбое. Само по себе оно не прекращает DDoS-атаку.
Для системы заказов и выплат особенно опасен непродуманный откат: после момента создания копии могли состояться реальные операции. Если просто вернуть старую базу, приложение перестанет знать о части уже выполненных действий.
Поэтому восстановление должно включать сверку с внешними сервисами и обработку событий, которых нет в восстановленной базе. Работоспособность этого процесса следует проверять заранее, а не впервые во время инцидента.
Согласовать действия команды
До инцидента нужно определить, кто связывается с провайдерами, кто принимает решение по рекламе, кто сообщает клиентам и кто проверяет финансовые операции.
Стоит заранее подготовить независимый канал информирования. Сообщение о сбое должно объяснять, какие функции затронуты и когда будет следующее обновление. Утверждать, что платёж не прошёл, можно только после проверки, а обещать срок восстановления — при наличии оснований.
Для поддержки полезен короткий порядок действий: какие данные запросить у клиента, где проверить операцию и в каких случаях передать вопрос финансовой или технической команде. Это снижает риск противоречивых ответов.
Как возвращать бизнес к обычной работе
Сначала команда подтверждает причину и границы сбоя: всплеск нагрузки ещё не доказывает DDoS. Затем восстанавливает доступность и проверяет критические операции.
После этого нужно разобрать накопленные задачи, сверить платежи и выплаты, восстановить партнёрский обмен. Рекламу и обычные лимиты нагрузки возвращают с учётом результатов этих проверок.
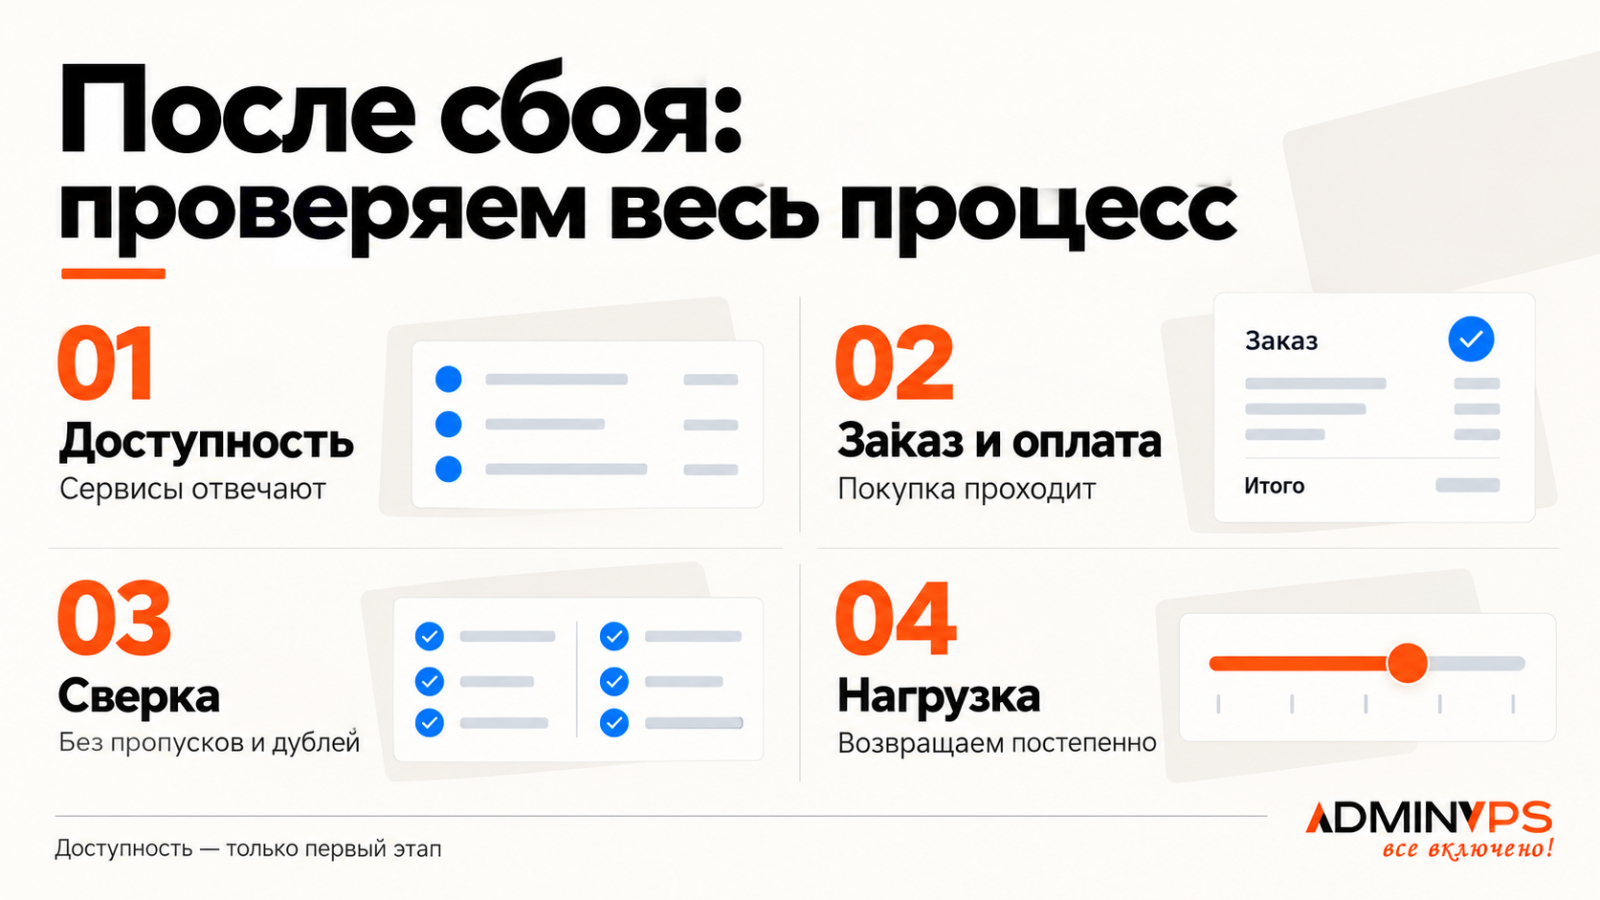
Для руководителя результат восстановления — это возможность снова выполнять обязательства: принимать заказы, подтверждать платежи, проводить выплаты и передавать партнёрам корректные данные.
Защиту от DDoS поэтому следует обсуждать вместе с устройством этих процессов. Полезный итог подготовки — понятный ответ на три вопроса: что продолжит работать при перегрузке, как будут сохранены незавершённые операции и кто подтвердит их результат после восстановления. Эти ответы помогают ограничить последствия атаки для бизнеса.