Cloudflare меняет правила для AI-ботов: как не потерять поисковую видимость
С 15 сентября 2026 года Cloudflare меняет правила управления AI-краулерами. На первый взгляд логика становится удобнее: поисковых роботов можно разрешить, обучающих — заблокировать.
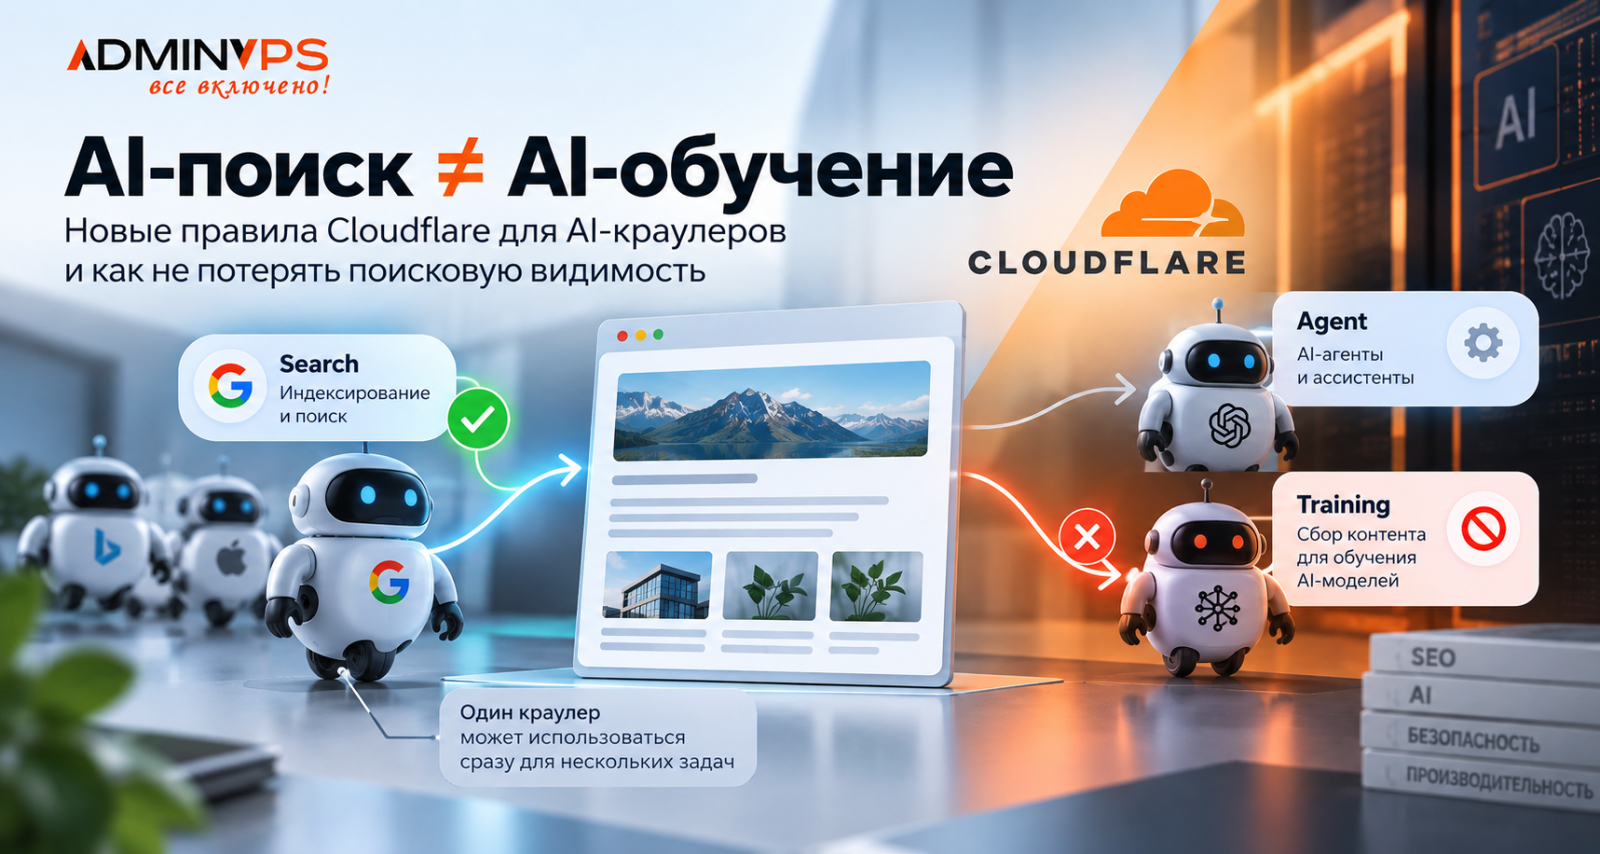
Но есть нюанс. Один и тот же краулер (crawler) иногда используется сразу для нескольких задач. Если Cloudflare относит его одновременно к Search и Training, более строгое правило может получить приоритет.
В результате настройка, которую команда включает, чтобы запретить использование контента для обучения AI-моделей, способна затронуть и поисковый обход.
Для бизнеса это уже не техническая мелочь. Ошибка может повлиять на присутствие сайта в поисковых системах и AI-поиске, а значит — на органический трафик, узнаваемость и привлечение клиентов.
Материал особенно актуален для руководителей digital-направлений, SEO-специалистов и администраторов, которые используют Cloudflare и управляют доступом поисковых и AI-ботов к сайту.
Коротко: Cloudflare разделяет управляемый AI-трафик на Search, Agent и Training. Если один краулер относится сразу к нескольким категориям, при конфликте применяется более строгое правило. Поэтому блокировка Training может затронуть и поисковый обход.
Что меняется с 15 сентября
Cloudflare разделяет управляемый автоматический трафик на несколько типов. Для AI-краулеров особенно важны три категории:
Search — обход страниц для поиска и дальнейшего использования контента в результатах поиска.
Agent — обращения AI-агентов, выполняющих действия или получающих информацию по запросу пользователя.
Training — сбор контента для обучения или дообучения AI-моделей.
Для каждой категории владелец сайта может задать собственную политику доступа.
Такое разделение удобно: компания может оставить сайт доступным для поиска, но ограничить использование контента при обучении моделей.
Проблема возникает с многоцелевыми краулерами.
Cloudflare указывает, что некоторые роботы могут выполнять сразу несколько функций. Среди примеров компания приводит Googlebot, Applebot и BingBot.
Если один краулер классифицируется одновременно как Search и Training, при конфликте правил применяется более ограничивающее действие.
То есть схема:
Search — AllowTraining — Block
не всегда означает, что поисковый обход продолжит работать без изменений.
Поэтому важно проверить не только сам переключатель AI Bots, но и то, какие категории назначены важным для бизнеса краулерам.
Почему нельзя просто нажать «Block AI»
Для бизнеса вопрос доступа AI-ботов становится сложнее, чем «разрешить или запретить искусственный интеллект».
Разные краулеры выполняют разные задачи.
OpenAI, например, разделяет поисковый и обучающий обход. OAI-SearchBot используется для поисковой видимости в ChatGPT, а GPTBot связан с контентом, который может использоваться при развитии моделей.
Anthropic отдельно выделяет Claude-SearchBot, ClaudeBot и Claude-User.
Google использует механизм Google-Extended, с помощью которого владелец сайта может ограничить использование контента для некоторых AI-сценариев, не запрещая обычный Googlebot.
Apple применяет похожий подход с Applebot и Applebot-Extended.
Для маркетинга эта разница принципиальна.
Один бот может помочь странице появиться в поисковом ответе и привести пользователя на сайт. Другой собирает информацию для обучения модели. Третий приходит на страницу потому, что конкретный пользователь попросил AI-агента изучить товар, услугу или материал.
С точки зрения бизнеса у этих сценариев разная ценность.
Поэтому общая блокировка всех AI-ботов может оказаться слишком грубым решением.
Если сайт размещён, например, на виртуальном сервере, а перед ним работает Cloudflare, ограничение может возникнуть ещё до обращения к самому серверу. Поиск причины только в CMS, nginx или приложении в такой ситуации ничего не даст.
robots.txt и Cloudflare решают разные задачи
Ещё одна распространённая ошибка — проверить robots.txt, увидеть разрешение для нужного краулера и считать, что доступ настроен правильно.
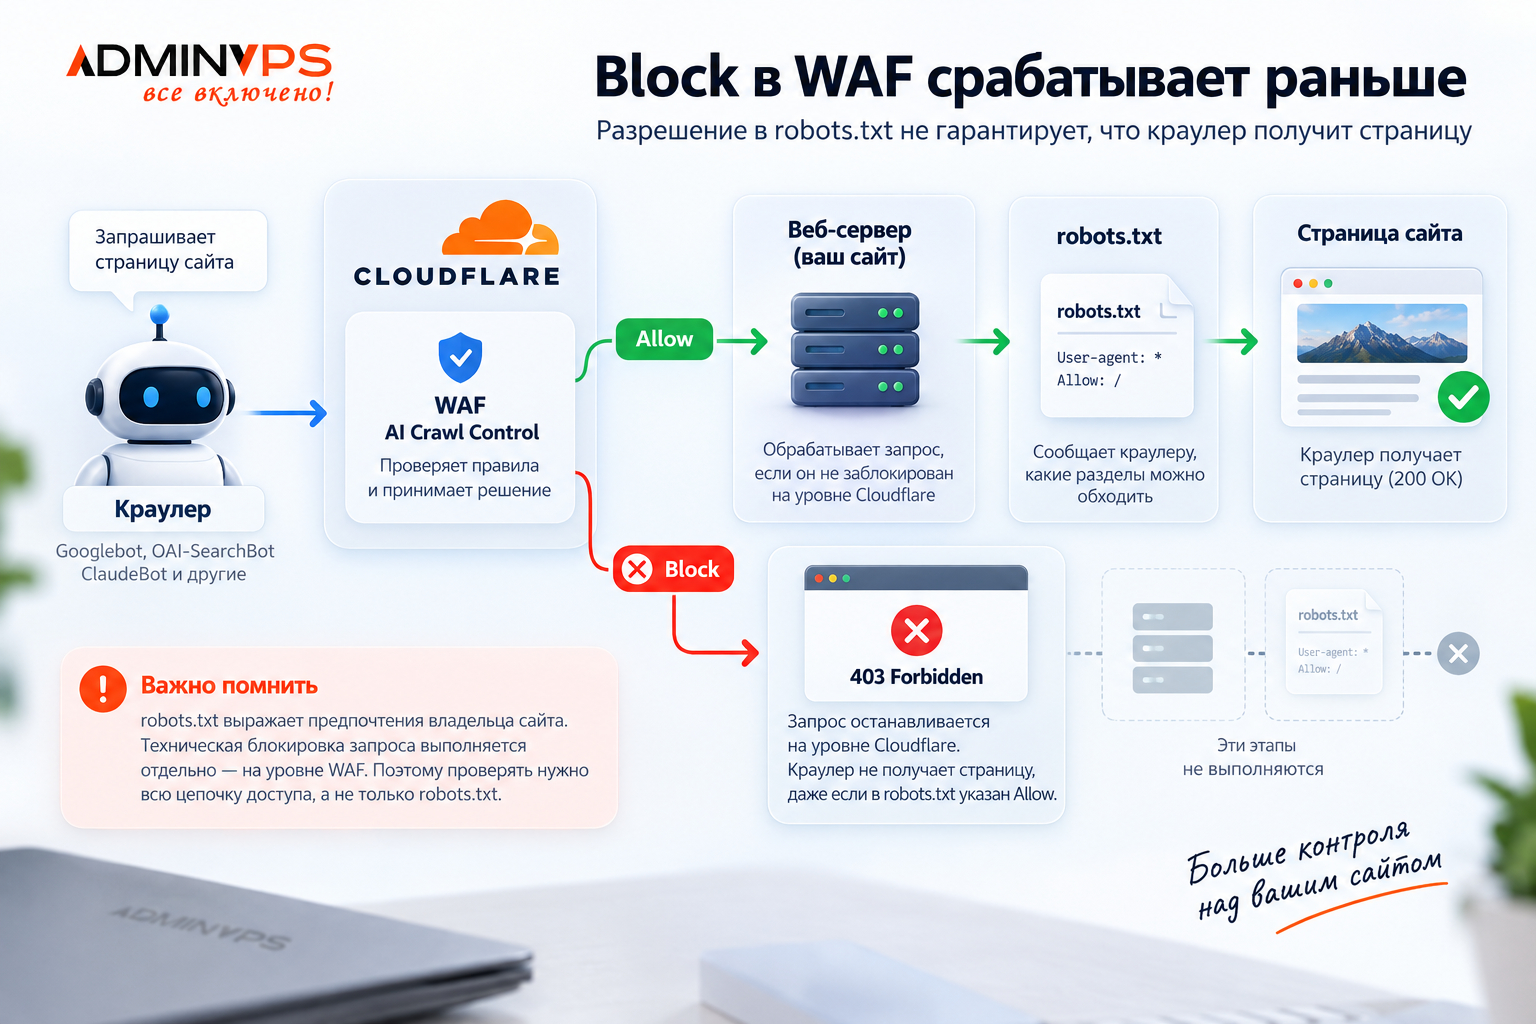
Но robots.txt и WAF работают на разных уровнях.
robots.txt сообщает роботу, какие разделы сайта владелец разрешает или запрещает обходить. Добросовестный краулер учитывает эти инструкции.
Cloudflare способен технически остановить HTTP-запрос раньше, чем он доберётся до веб-сервера.
Поэтому возможна ситуация:
robots.txt: Allow Cloudflare/WAF: Block
Для краулера итог будет один: страницу он не получит.
Именно поэтому после изменения AI-политики нужно проверять не только содержимое robots.txt, но и фактический ответ инфраструктуры.
Как можно разделить поиск и обучение
Если оператор AI-сервиса предоставляет отдельные идентификаторы для поисковых и обучающих краулеров, правила могут выглядеть примерно так:
User-agent: OAI-SearchBot
Allow: /
User-agent: GPTBot
Disallow: /
User-agent: Claude-SearchBot
Allow: /
User-agent: ClaudeBot
Disallow: /
User-agent: Googlebot
Allow: /
User-agent: Google-Extended
Disallow: /
User-agent: Applebot
Allow: /
User-agent: Applebot-Extended
Disallow: /
Это не готовый шаблон для копирования на любой сайт.
У каждой компании может быть своя политика: кому-то важно максимальное присутствие в AI-поиске, кому-то — защита авторского контента, а кто-то предпочитает ограничить большую часть автоматического трафика.
Главное — управлять поисковыми и обучающими сценариями осознанно, а не применять один запрет ко всем краулерам.
Что стоит проверить в настройках Cloudflare
Начать лучше с текущих настроек Cloudflare, а не с изменения robots.txt.
Сначала посмотрите, какие политики установлены для Search, Agent и Training.
Затем проверьте AI Crawl Control и список краулеров, которые реально обращаются к сайту. Для бизнеса здесь особенно важно выделить роботов, связанных с поисковыми системами и AI-сервисами, из которых потенциально может приходить аудитория.
После этого стоит сопоставить настройки с robots.txt.
Если компания хочет сохранять видимость в обычном поиске и AI-поиске, связанные с этими каналами краулеры не должны случайно попадать под более широкое правило блокировки.
Отдельно необходимо посмотреть существующие WAF Rules. Разрешение краулера в одном интерфейсе не гарантирует, что его не остановит другое правило безопасности.
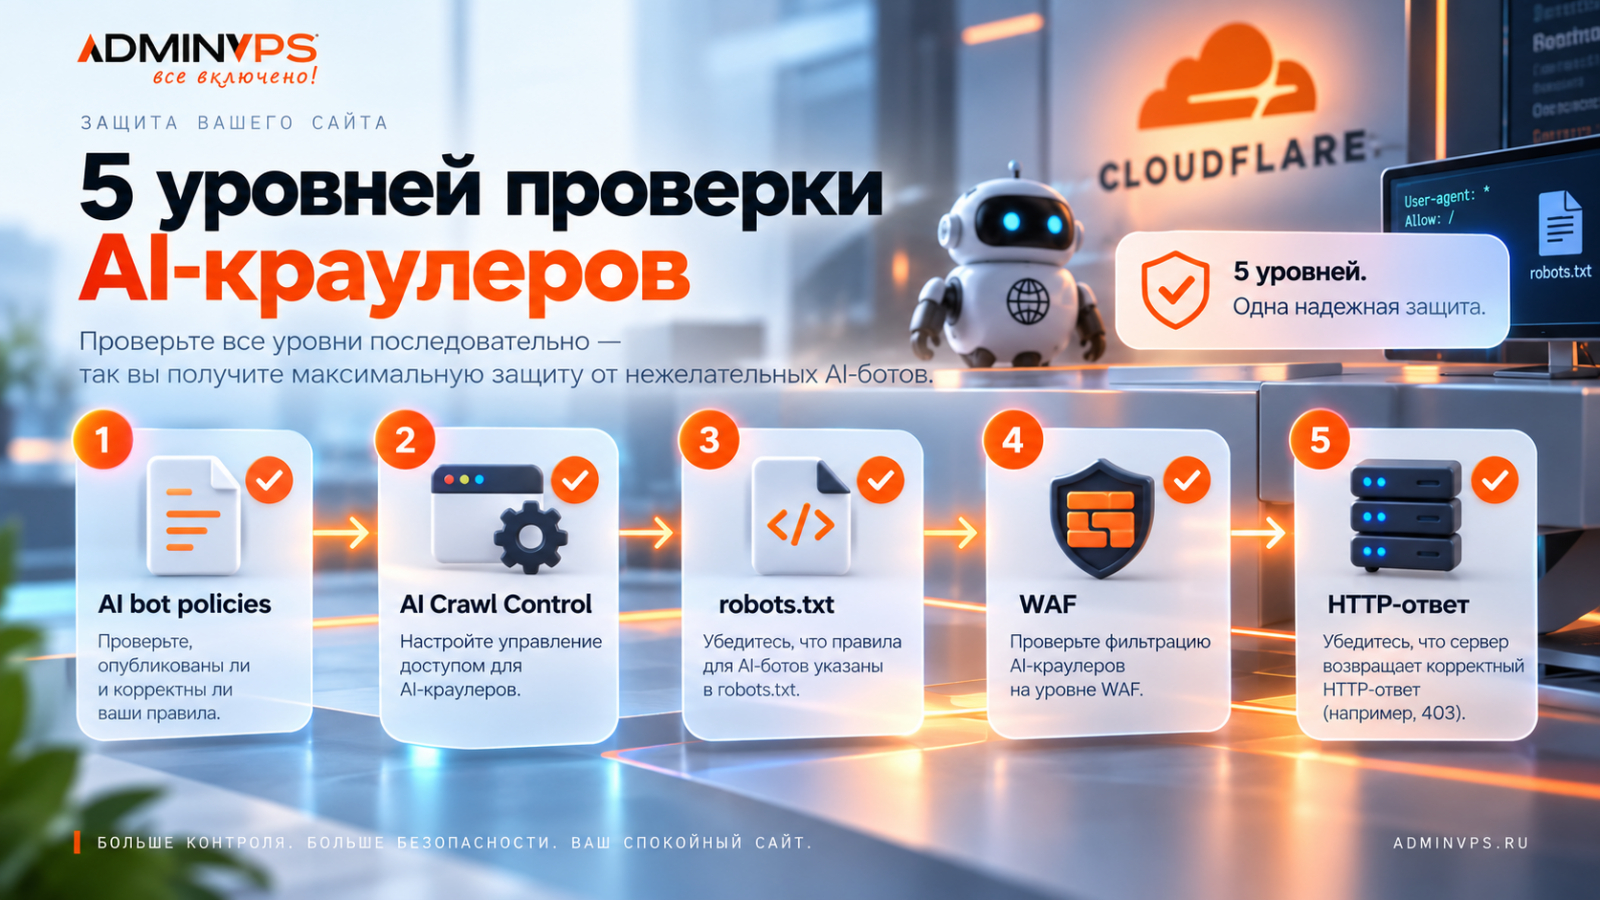
Получается несколько уровней проверки:
- политика Search / Agent / Training;
- индивидуальные настройки краулеров;
- robots.txt;
- существующие WAF-правила;
- фактический HTTP-ответ сайта.
Для компаний, у которых нет отдельного DevOps-инженера, подобный аудит можно включить в регулярное администрирование серверов. Здесь важно смотреть на CDN, WAF, веб-сервер и приложение как на одну цепочку обработки запроса.
Как проверить, что после изменений ничего не сломалось
Главная ошибка — ограничиться состоянием переключателей в панели Cloudflare.
После изменения настроек нужно проверить фактическое поведение сайта.
Для digital-команды рабочий сценарий может выглядеть, например, так:
- Определить поисковые и AI-сервисы, из которых компания хочет получать видимость и переходы.
- Проверить официальное назначение их краулеров.
- Сопоставить его с категориями Search, Agent и Training в Cloudflare.
- Проверить индивидуальные Allow и Block.
- Сверить настройки с robots.txt.
- Просмотреть WAF Rules.
- Проверить журналы запросов, HTTP-коды и инструменты поисковых систем.
Если краулер, который раньше нормально обходил сайт, начинает получать 403 Forbidden, Cloudflare должен стать одной из первых точек диагностики.
Не стоит сразу искать проблему в CMS или на сервере.
Почему это уже вопрос маркетинга, а не только администрирования
Раньше правила для краулеров обычно находились где-то между SEO и системным администрированием.
С развитием AI-поиска ситуация меняется.
У специалиста по безопасности есть задача сократить нежелательный автоматический трафик.
У SEO-команды — сохранить индексирование.
У контент-команды может быть задача ограничить использование материалов для обучения моделей.
А маркетингу важно присутствие бренда в ChatGPT, Claude, Gemini и других интерфейсах, через которые пользователи начинают искать информацию и выбирать продукты.
Эти задачи не противоречат друг другу, если доступ настраивается точечно.
Гораздо опаснее простое правило «все AI-боты запрещены», когда никто внутри компании не понимает, какие каналы вместе с ними были отключены.
Для бизнеса полезнее рассматривать такую политику как матрицу:
кто приходит → зачем приходит → что получает → какую ценность или риск создаёт.
Это точнее, чем делить весь автоматический трафик на «полезный» и «AI».
Что в итоге
С 15 сентября 2026 года Cloudflare не «закрывает AI-поиск» и не вводит универсальную блокировку AI-ботов.
Меняется модель управления ими.
Главный нюанс — многоцелевые краулеры. Если один робот используется сразу в нескольких сценариях, правило, задуманное как ограничение AI-обучения, может оказаться шире, чем рассчитывала команда.
Поэтому стоит проверить три вещи: какие краулеры важны для привлечения аудитории, к каким категориям их относит Cloudflare и не блокируются ли они на другом уровне инфраструктуры.
Вопрос теперь не в том, нужно ли «пускать AI на сайт».
Правильный вопрос звучит иначе: какому краулеру нужен доступ, для какой задачи и что произойдёт с видимостью сайта, если этот доступ закрыть.
Для SEO это вопрос обхода и индексации. Для маркетинга — дистрибуции контента и новых каналов привлечения. Для инфраструктурной команды — безопасности и контроля автоматического трафика.
И именно поэтому настройку AI-ботов уже нельзя рассматривать как технический переключатель, который можно один раз включить и больше к нему не возвращаться.