Архитектура DWH: из чего состоит хранилище данных
Когда данные компании находятся в 1С, CRM, Excel, Google Таблицах и других системах, собрать из них единый отчет становится отдельной технической задачей. Источники используют разные форматы, справочники и правила расчета показателей, поэтому одни и те же данные могут отличаться в разных отчетах.
DWH (Data Warehouse, хранилище данных) объединяет информацию из разных источников, приводит ее к согласованной структуре, сохраняет историю изменений и предоставляет единый контур для аналитики.
При этом DWH используют не только для BI-аналитики. Хранилище может быть источником данных для SQL-аналитики, прогнозных моделей, машинного обучения и регулярной отчетности. Но самый распространенный сценарий — построение управленческой аналитики и дашбордов.
Из чего состоит архитектура DWH
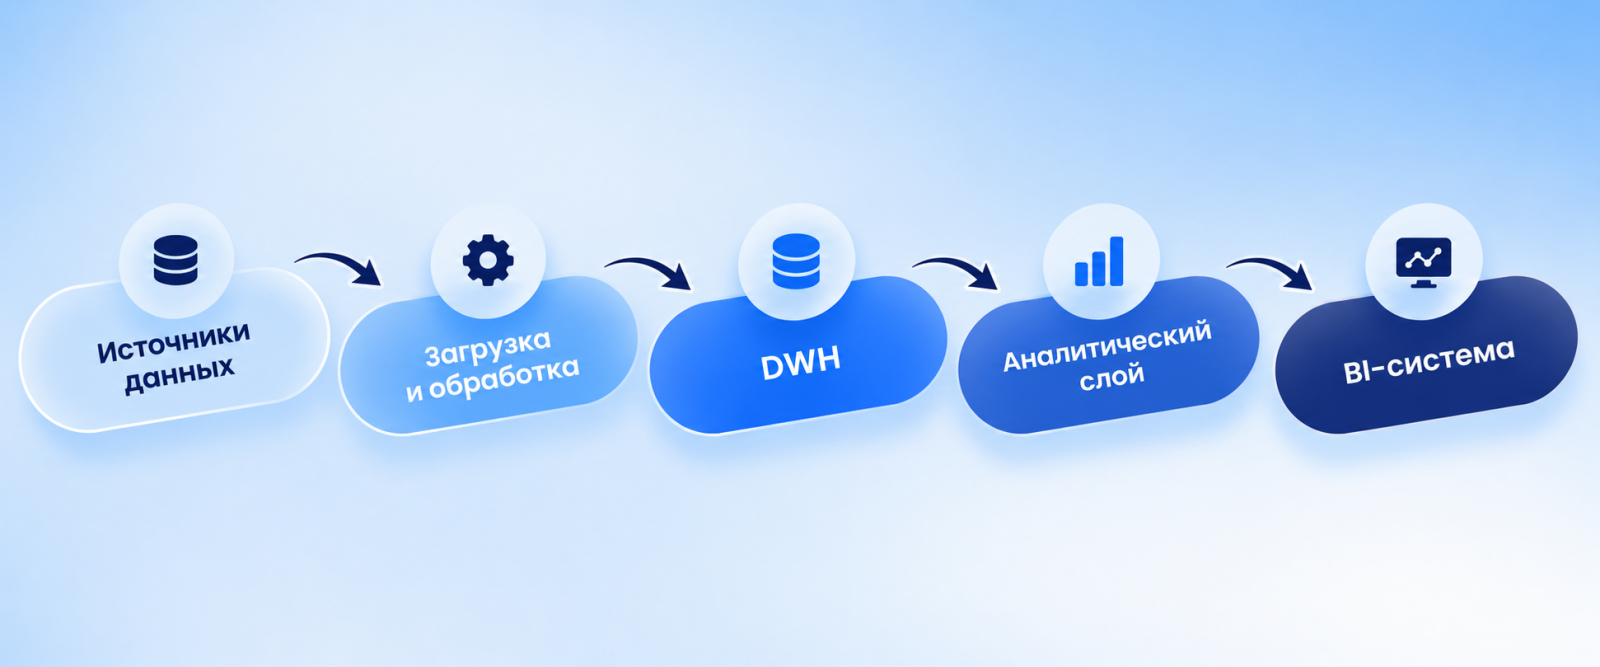
Типовая архитектура выглядит так:
Источники данных
Это системы, в которых изначально появляются данные: ERP и 1С, CRM, базы данных, Excel, API, файлы, внутренние системы и внешние сервисы.
Главная сложность здесь — не количество источников, а различия между ними. Один и тот же клиент может иметь разные идентификаторы в CRM и 1С, а справочники товаров или подразделений могут не совпадать. Поэтому данные необходимо не просто собрать, а сопоставить по единой логике.
Например, в одном из наших проектов в DWH объединяли данные из 1С, Google Таблиц, Excel, XML-выгрузок из MS Project и внутренней информационной системы. Хранилище было реализовано на PostgreSQL, а подготовленные данные использовались для аналитики в Apache Superset.
Загрузка и staging
Для переноса данных используются ETL/ELT-процессы (способы извлечения, загрузки и преобразования данных). А если таких процессов много, их нужно запускать в определенном порядке и по расписанию. Например, сначала загрузить данные из 1С, затем проверить их, после этого обновить основные таблицы DWH и только потом пересчитать витрины для BI. Для управления такой последовательностью используют системы оркестрации, например Apache Airflow.
При небольших объемах допустима полная загрузка. Когда данных становится много, используют инкрементальную загрузку (передачу только новых или изменившихся данных) или CDC (Change Data Capture — отслеживание изменений в источнике).
После загрузки данные часто попадают в staging — промежуточный слой, где они сохраняются максимально близко к исходному виду. Это позволяет проверить данные до того, как они попадут в основную модель DWH.
Например, если источник изменил структуру таблицы или начал передавать дубликаты, проблему можно обнаружить на этом этапе, не допуская ее попадания в аналитические витрины.
DWH Core
В центральном слое хранилища данные объединяются и приводятся к согласованной модели.
Здесь решаются вопросы, которые напрямую влияют на качество аналитики:
- унификация справочников,
- единые идентификаторы,
- связи между сущностями и историчность.
Историчность особенно важна для аналитики. Если в операционной системе клиент сменил регион, а товар — категорию, для DWH может быть принципиально важно сохранить прежние значения. Иначе при анализе истории данные начнут отражать текущее состояние вместо того, которое было на момент события.
Витрины данных
После формирования основной модели создаются Data Mart — витрины данных под конкретные задачи. Например, отдельно можно подготовить данные для финансов, продаж, маркетинга или логистики.
В наших проектах для аналитического слоя используются View и Materialized View. Это позволяет вынести бизнес-логику расчетов из отдельных дашбордов и сделать показатели едиными для разных пользователей.
Такой подход особенно важен для метрик вроде выручки, маржи или количества продаж. Если каждый отчет считает их самостоятельно, со временем появляются расхождения. Когда расчет задается на уровне аналитического слоя, одна и та же логика используется повторно.
Почему DWH — не просто база для BI
BI-система — только один из потребителей данных. Из DWH аналитики могут получать выборки через SQL, а Data Science-команды — исторические данные для прогнозирования спроса, оттока клиентов, оценки рисков и других моделей.
Поэтому архитектуру хранилища важно проектировать с учетом всех будущих сценариев использования, а не только текущего набора дашбордов.
Что важно предусмотреть при проектировании
Основные проблемы DWH возникают при согласовании данных и бизнес-логики. Еще до разработки необходимо определить:
- какие источники являются основными;
- как синхронизировать справочники;
- какие данные и изменения нужно хранить в истории;
- как часто обновлять информацию;
- какие показатели рассчитываются централизованно;
- как контролировать качество данных;
- какие витрины нужны бизнесу.
Отдельно стоит учитывать нагрузку. Операционная база данных оптимизирована под транзакции, а DWH — под сложные аналитические запросы и работу с большими объемами исторических данных. Поэтому для хранилища выбирают архитектуру и СУБД с учетом будущего объема данных, характера запросов и требований к скорости обработки.
Как мы проектируем DWH
При разработке хранилища мы смотрим не только на то, как перенести данные из одной системы в другую. Важно построить весь контур: источники, загрузку, контроль качества, модель данных, историчность, витрины и слой доступа для конечных пользователей.
У нас большой опыт разработки DWH, в том числе для крупных компаний с большими объемами данных. Проекты ведут специалисты разных профилей — архитекторы, Data Engineer, разработчики, DBA, DevOps и аналитики, поэтому можем закрывать полный цикл работ: от архитектуры и интеграции источников до витрин и подключения BI.
Если вы планируете внедрить DWH или хотите понять, какая архитектура подойдет именно вашей компании, запишитесь на бесплатную консультацию. Разберем ваши источники данных, текущую систему аналитики и задачи бизнеса, после чего расскажем, какой подход к построению хранилища имеет смысл использовать в вашем случае.