Парсинг SHEIN: что включить в отчёт маркетолога
Команде fashion-бренда нужен отчёт, который помогает решить, какие товары сравнивать с конкурентом и какие ценовые гипотезы проверять. Парсинг SHEIN даёт исходные данные для такого документа, но набор цен ещё нужно связать с задачей маркетинга. На примере открытого SHEIN scraper разберём структуру отчёта: от отдельной карточки до списка действий для команды.
Основа примера — три записи из sample_output.json, сохранённые 30 сентября 2026 года в 12:56:49 UTC. Новый сбор для этой статьи не проводился. Эти данные показывают устройство отчёта, а не состояние рынка сегодня.
Как превратить парсинг SHEIN в задачу для команды
Отчёт по ценам стоит начинать с решения, которое команда собирается принять: проверить ценовой диапазон линейки, выбрать товары для сравнения или оценить изменение предложения. Затем фиксируют регион, категорию и состав выборки. Для каждого вывода указывают наблюдение, ограничение данных и следующий шаг. Такой формат сохраняет связь между цифрами и действием.
- Выбрать одну задачу и сопоставимую группу товаров.
- Зафиксировать регион, валюту, запрос и глубину выборки.
- Сохранить цены, скидки и признаки наличия вместе с датой сбора.
- Разделить изменение цены товара и изменение состава выборки.
- Сформулировать гипотезу и назначить проверку перед решением.
Три карточки: одинаковая скидка, разное предложение
В сохранённом примере все товары относятся к категории Women Mini Dresses, валюта указана как USD. Ниже приведены поля файла без пересчёта скидок и без обновления цен.
- SKU 458057728, Aloruh: цена 13,03 USD; до скидки 20,89 USD; скидка 38%; рейтинг 4,62; отзывов 1001.
- SKU 430743850, Aloruh: цена 17,51 USD; до скидки 28,19 USD; скидка 38%; рейтинг 4,66; отзывов 1001.
- SKU 499485260, jotten: цена 8,55 USD; до скидки 13,79 USD; скидка 38%; рейтинг 4,80; отзывов 143.
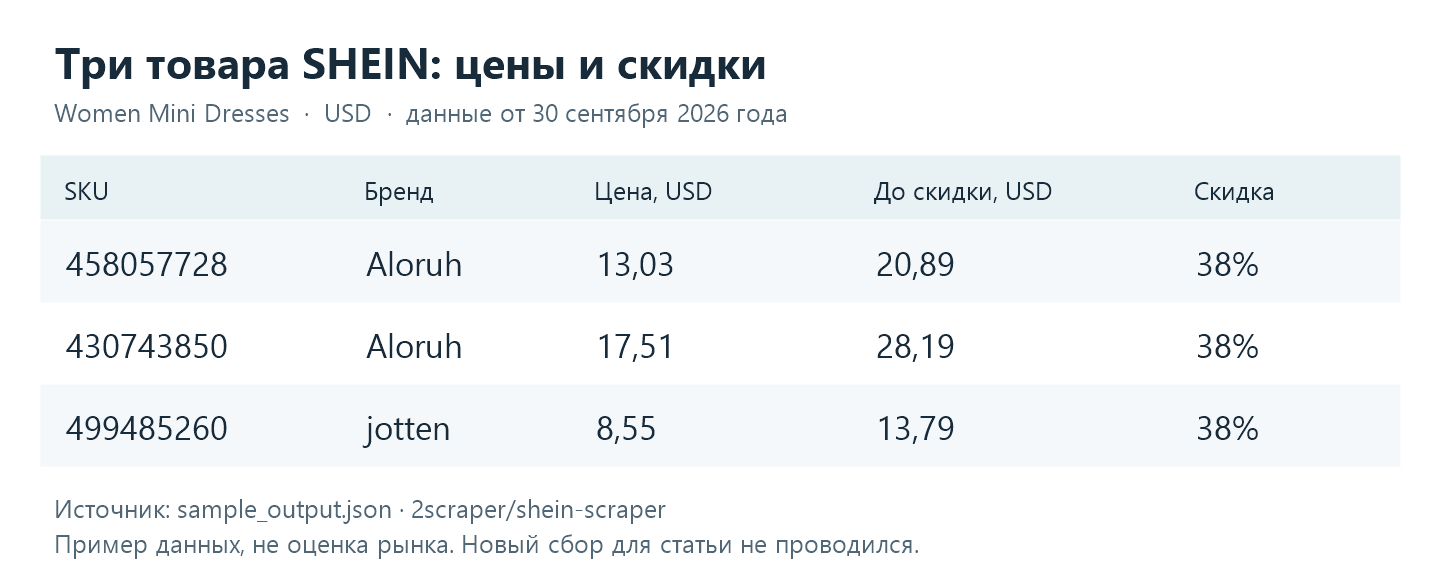
Источник: sample_output.json репозитория 2scraper/shein-scraper, 30 сентября 2026 года. Три записи из примера, не репрезентативная выборка категории.
Процент скидки во всех строках одинаков, а текущая цена лежит в диапазоне от 8,55 до 17,51 USD. Если вынести в презентацию только «скидка 38%», различия между предложениями исчезнут. Для сравнения с собственной линейкой нужны как минимум текущая цена, характеристики товара и выбранный рынок.
Я бы оставила процент скидки вспомогательным показателем. Поле original_price отражает указанную сайтом цену до скидки, но само по себе не доказывает, что товар продавался по ней неделю назад. Для разговора о фактическом удешевлении нужны наблюдения за одним товаром в разные даты.
Два блока отчёта: цена товара и состав предложения
Предположим, команда хочет проверить, подешевели ли сопоставимые платья. Это будущая задача мониторинга, а не результат приведённого примера. Для неё следует повторить сбор при одинаковых условиях и отдельно сравнить товары, встречающиеся в обеих выгрузках.
В комплекте скрепера есть diff_runs.py: он сопоставляет записи двух завершённых сборов по sku. По README, инструмент проверяет совпадение запроса, рынка и параметра сортировки, а также соответствие файла метаданным. Смену валюты он отмечает отдельно, без расчёта изменения цены.
Первый блок отчёта можно посвятить совпавшим товарам: старая и новая цена, дата каждого наблюдения, валюта и ссылка на карточку. Второй блок нужен для состава выборки: какие позиции появились и какие перестали в неё попадать. Смешивать эти события в одну среднюю цену неудобно: изменение среднего может объясняться появлением более дешёвых товаров, даже если цены прежних позиций не менялись.
При ограничении количества результатов скрепер помечает пропавшую позицию как left_selection. Это означает выход из выбранного набора, а не доказанное удаление товара из каталога. В отчёте лучше сохранить именно такую формулировку.
Рейтинг, отзывы и наличие: контекст для проверки
У третьего товара рейтинг 4,80 при 143 отзывах, у первого — 4,62 при 1001. Эти значения полезны как описание карточек, но по ним нельзя посчитать продажи или конверсию. Скрепер сохраняет рейтинг и количество отзывов; тексты отзывов в его выгрузку не входят.
Признак in_stock тоже требует аккуратной интерпретации. По документации, sku соответствует goods_id и общий для цветов и размеров товара. Положительный признак наличия в строке не подтверждает доступность каждого размера, который нужен для сравнения с ассортиментом бренда. Если price_source имеет значение json_ld_min_variant, сохранена минимальная цена варианта товара: её нельзя автоматически приписывать всем размерам и цветам. В трёх записях примера источник цены указан как embedded_json.
Для ценовой гипотезы я бы добавила в рабочую таблицу отдельную графу «что проверить в карточке»: материал, вариант, размер и условия предложения. Это редакторское дополнение к отчёту, а не обещание, что скрепер экспортирует все эти характеристики.
Что записать в методику мониторинга
Документация описывает сбор с us.shein.com: на входе поисковый запрос, категория или адрес товара, на выходе JSON либо CSV. Утилита работает на Python 3.9+. Рядом с результатом сохраняются метаданные запуска, по которым можно проверить полноту сбора. Если новых строк нет, по умолчанию прежний файл не перезаписывается, поэтому сам факт наличия файла ещё не говорит об успешном обновлении.
После установки зависимостей по README запустить сбор категории женских джинсов и сохранить результат в CSV можно одной командой:
python3 playwright_scraper.py --category "Women Jeans-c-1934.html" --format csv --out jeans.csv
Файл jeans.csv можно открыть в таблице. Три карточки платьев выше взяты из сохранённого примера репозитория.
В методике стоит указать время наблюдения, рынок, валюту и ограничение выборки. README подтверждает проверку начального набора примерно из 20 товаров; дальнейшая прокрутка не проверена. Кроме того, параметр сортировки записывается, но пока не передаётся SHEIN. Обещать на этой основе полный каталог или выборку самых дешёвых товаров нельзя.
Отдельная причина пропусков в календаре наблюдений — проверки доступа. Скрепер передаёт задачи с изображениями в 2Captcha, если настроен ключ. Локальный браузер может работать без ключа, когда страница доступна без платного решения проверки. Ограничение частоты запросов требует остановки или ожидания, а не решения капчи.
В отчёт полезно включать и технические пропуски: «новых данных нет» отличается от «цена не изменилась». Для платных решений предусмотрен лимит --max-solves, по умолчанию 8 на запуск. Полное описание всех опций есть в руководстве 2Captcha по SHEIN; для маркетингового отчёта достаточно согласовать с разработчиком условия сбора и учёт неудачных запусков.
Вопросы перед первым отчётом
Можно ли оценить среднюю цену всей категории SHEIN?
По трём строкам sample_output.json можно описать только эти три товара. Для оценки категории понадобится обоснованная выборка и проверка её охвата, которых у этого примера нет.
Как выгрузить цены SHEIN в Excel?
Скрепер поддерживает CSV, который можно импортировать в таблицу. SKU стоит сохранять как текст, а валюту и дату сбора оставлять отдельными столбцами.
Можно ли сравнивать цены разных регионов?
Это отдельная аналитическая задача; описанный пример относится к американскому сайту и USD. Простого сопоставления чисел недостаточно, а встроенный инструмент сравнения отклоняет разные рынки.
Гарантирует ли решённая капча регулярный сбор?
Нет. В тесте из README от 30 сентября 2026 года проверку прошли 3 из 5 новых американских браузерных профилей. Эта цифра описывает конкретный тест, а не вероятность успеха будущего мониторинга.
От наблюдения к проверяемой гипотезе
Рабочий результат для маркетолога может выглядеть так: «в выбранных карточках разный ценовой уровень при одинаковой заявленной скидке; нужно подобрать сопоставимые товары и проверить их цены повторно». Это основание для следующего наблюдения. Для решения о собственной акции понадобятся также данные о марже, позиционировании и спросе, которых в товарной выгрузке нет.
При планировании сбора публичных данных учитывайте правила сайта и robots.txt, задавайте умеренную частоту запросов. Если задача затрагивает персональные данные, отдельно проверьте применимые требования GDPR и 152-ФЗ; для этого примера сведения о покупателях не нужны.
Отправьте разработчику ссылку на проект с примером выгрузки и обсудите, какие данные включить в первый отчёт. Возможности инструмента собраны на странице SHEIN scraper. Если в пилоте потребуется обработка проверок с изображениями, попробуйте предусмотренное подключение 2Captcha с заранее установленным лимитом решений.