Невидимая метка в ответах Claude: как она устроена и что её уничтожает
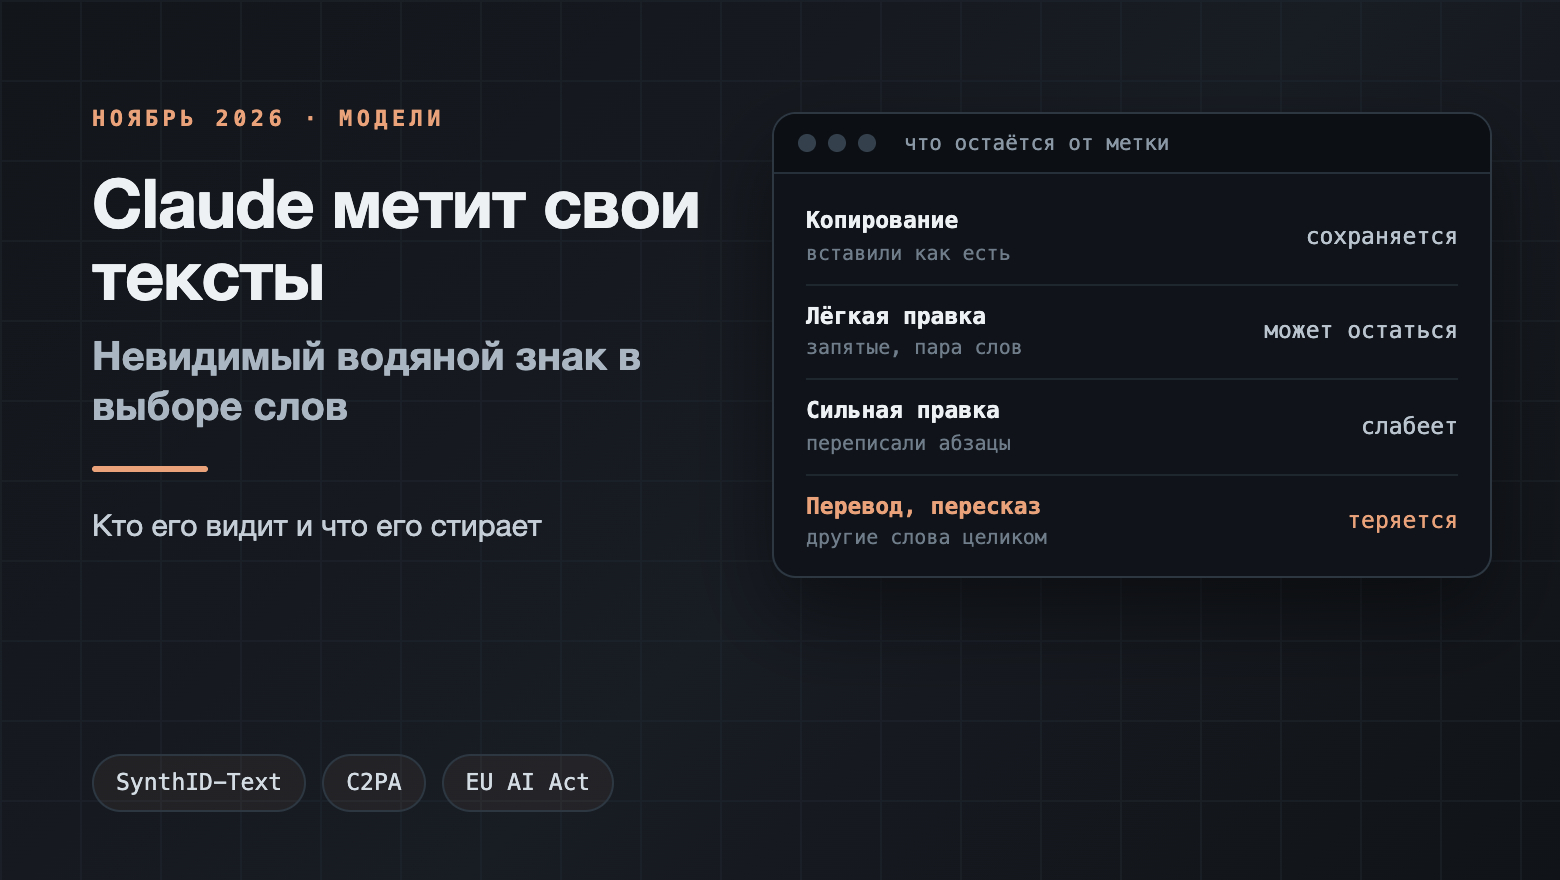
Прошлым летом Anthropic провела тихое изменение, которое не бросается в глаза: ни в интерфейсе, ни в готовых ответах его не заметишь. Отметку теперь несут любые тексты новых моделей Claude. Подписи внизу и потайных значков там нет: метка сидит в самом порядке, в котором модель выбирает слова. Скопировали ответ в документ, переслали в чат, выложили в блог, и отметка ушла вместе с текстом.
На этой неделе у истории появилось продолжение. До 10 ноября маркировку докатывают на Amazon Bedrock, а значит, она добирается и до компаний, которые арендуют Claude в облаке. Пора разобраться, что представляет собой такая метка, кому доступно её чтение и насколько ей стоит доверять.
Метка спрятана в словах, а не в символах
- Что метится. Отметка стоит на всех текстах моделей Claude, вышедших после 2 августа 2026 года: в чате, в API, в Claude Code и в остальных продуктах. Более старые модели получат её позже.
- Как. Слова модель подбирает не совсем наугад: ей подсказывает секретный ключ. Ни лишних слов, ни невидимых символов в тексте нет.
- Где. Работает по всему миру, хотя поводом стал европейский закон об ИИ. Привязать маркировку к одному региону Anthropic, по собственным словам, пока не может.
- Кто проверяет. Детектор закрыт: доступ по заявке выдают регуляторам, журналистам, исследователям, школам и вузам. У рядового пользователя способа проверить текст нет.
- Что стирает. Пересказ, перевод, сильная правка, смешение с чужим текстом. В коротком фрагменте сигнала почти не остаётся.
- Главная оговорка. Отметка сообщает, что текст проходил через Claude, а не «Claude написал». Её отсутствие тоже ничего не доказывает.
Повод появился из закона
Причина появления отметки лежит в праве. В ЕС работает закон об ИИ, и статья 50 в нём требует, чтобы машина могла распознать контент, созданный нейросетью. В августе заработал добровольный кодекс по прозрачности, где расписано, как это делать. Под ним стоят подписи Anthropic, Google, Meta, Microsoft, OpenAI и ещё нескольких компаний.
О самой маркировке стало известно 10–11 августа. Anthropic выложила справку «Как Claude помечает созданный ИИ контент», а тремя днями позже опубликовала в блоге статью о том, как устроена текстовая метка. Презентации не было, поэтому многие о ней до сих пор не слышали.
Секретный ключ сдвигает выбор слов
Текст языковая модель собирает по кусочку. Перед каждым шагом у неё есть набор возможных продолжений с вероятностями: «быстро» 30 %, «легко» 25 %, «без труда» 20 % и так далее. Из этого набора один вариант вытаскивает генератор случайных чисел. Чаще всего такой выбор действительно случаен.
Водяной знак подменяет честную случайность. Модель берёт секретный ключ и несколько предыдущих слов, по ним решает, каким вариантам слегка отдать предпочтение, но выбирает по-прежнему из подходящих слов, так что смысл не страдает. Зато на длинной дистанции копится статистический перекос, которого случайно не бывает. Обладатель ключа его обнаружит, для остальных текст выглядит обычным.
Свою метку Anthropic построила на подходе SynthID-Text, который в 2024 году описала Google DeepMind в журнале Nature и тогда же открыла к нему доступ. Google проверяла метку на 20 млн ответов Gemini и не обнаружила, что помеченные ответы пользователи оценивают ниже. Anthropic тоже утверждает, что смысл, качество и читаемость ответа от метки не меняются. Независимых замеров по Claude пока нет.
Из такой схемы вытекают две детали.
- В фактах и в коде метки меньше. Где правильный ответ один, выбирать не из чего: дату, формулу или имя функции синонимом не заменишь без ошибки. Anthropic прямо признаёт, что в фактических фрагментах и в коде знак слабее.
- Невидимых символов нет. Программа, которая вычищает пробелы нулевой ширины и прочий скрытый мусор, метку не уберёт. Она живёт в самих словах.
Текст метят везде, файлы подписывают иначе
Метка ставится на уровне модели, поэтому встречается всюду, где работает поддерживаемая версия: в приложении Claude, в API, в Claude Code, Cowork и Claude Tag. Через облака AWS, Google Cloud и Microsoft Foundry текст тоже идёт помеченным. На Bedrock раскатка закончится 10 ноября.
Отметку несут все модели, вышедшие начиная с 2 августа 2026 года. Более старым её добавят позже, но без конкретной даты. Есть оговорка: у Sonnet 4.6 и Opus 4.6 метка может не сработать, если в запросе через API изменить температуру или другие параметры выборки слов.
С файлами всё иначе. Картинки, видео и звук, созданные Claude в его песочнице для кода, получают подписанные метаданные по стандарту C2PA. Внутри файла остаётся запись: «создано или обработано Claude». Форматов много: PNG, JPEG, GIF, WebP, SVG, MP4, MP3 и другие, а вот PDF, текстовые файлы и офисные документы не подписывают вовсе.
Метаданные C2PA устроены проще текстовой метки, и стереть их легче. Достаточно пересохранить картинку в другом формате, сжать заново или сделать скриншот, и подписи уже нет.
Проверить подпись может не каждый
Файлы проверяют бесплатно: Claude Content Checker на сайте claude.com читает метаданные C2PA прямо в браузере, никуда файл не загружая. А вот текст этот сервис не смотрит.
Детектор текстовой метки для посторонних закрыт. Anthropic держит его в статусе частной предварительной версии и выдаёт доступ по заявке. Пускают регуляторов, правоохранительные органы, СМИ и фактчекеров, независимых исследователей, учебные заведения, общественные организации в ЕС, а также компании, которые проверяют свои тексты из Claude. Круг обещают расширять «со временем».
Цифр Anthropic не раскрывает. Ни точности, с которой детектор находит метку, ни частоты ошибок на человеческом тексте, ни того, сколько слов хватит для уверенного ответа. В справке есть только оговорка: очень короткого фрагмента сигнала для надёжной проверки не хватит.
Копирование и вставку метка переживает, а пересказ нет
Сама Anthropic говорит, что метка выдерживает копирование и вставку и «может сохраниться после некоторой правки». Слабой она становится, когда текст:
- серьёзно отредактировали;
- пересказали своими словами;
- перевели на другой язык;
- смешали с другим текстом;
- сократили до пары предложений.
Причина простая: перекос накапливается по всему тексту, и каждая переписанная фраза его разбавляет. При переводе меняются все слова сразу, поэтому от метки почти ничего не остаётся.
Едва об маркировке объявили, разработчики стали выкладывать обходные инструменты. Wired 19 августа писал: первые появились в течение нескольких часов после анонса, один набрал тысячи звёзд на GitHub. Работают ли они на самом деле, независимо никто не проверял. Часть программ вычищает невидимые символы, которых в тексте Claude, как мы выяснили, нет. Другие переставляют предложения, меняют слова на синонимы и гоняют текст через перевод. В итоге они делают ровно то, что Anthropic сама назвала слабыми местами метки.
Вывод напрашивается сам. Метка ловит тех, кто копирует ответ целиком и ничего в нём не меняет; кто захочет её убрать, тот уберёт. Она рассчитана на массовый поток текста, а не на защиту от целенаправленного обхода.
Найденная метка говорит об обработке, а не об авторстве
Anthropic честно пишет об этом в справке: метка означает, что контент «мог быть создан или обработан Claude», а сам сигнал «не окончательный».
Обработан, но не написан. Вы написали статью сами, попросили Claude поправить запятые, перевести или сократить, и в исправленном тексте появятся помеченные куски. Детектор их найдёт, а автор всё равно вы.
Работает и обратное. Метки нет, и это не доказывает, что текст человеческий. Он мог прийти от старой модели Claude, от другой нейросети без маркировки или от открытой модели, которую ничем не метят. Его могли отредактировать или перевести.
Предыстория у этой истории есть. В 2024 году The Wall Street Journal писал: OpenAI давно сделала похожую метку для ChatGPT, но включать её не стала. Одна из причин — опасение, что детектор несправедливо ударит по людям, для которых английский не родной и которые пользуются ChatGPT как редактором. Сейчас закон подтолкнул к маркировке всех крупных разработчиков, а проблема осталась прежней.
На практике всё зависит от того, как вы используете модель
Студентам и преподавателям. Учебные заведения в списке тех, кому детектор доступен. Но найденная метка не доказывает списывание: точно так же помечается текст, который студент написал сам и отдал Claude на проверку. Преподавателю лучше видеть в ней повод поговорить, а не готовый приговор.
Копирайтерам и авторам блогов. Публикуете ответ Claude почти без правок, он помечен. Проверить это сегодня может узкий круг организаций, но доступ обещают расширять. Площадки и поисковики пока не говорили, что читают эту метку. Если ваш процесс устроен как «модель пишет, человек серьёзно переписывает», от метки останется немного, и это честно показывает, как текст был сделан.
Разработчикам. Код помечается слабее обычного текста, потому что вариантов в нём меньше. Если ваш продукт отдаёт пользователям тексты из Claude, они помечены. Отдельно Anthropic советует самому разобраться, какие требования статьи 50 касаются именно вашего сервиса. Метка модели не снимает обязанностей с того, кто встроил её в свой продукт.
Тем, кто работает с картинками. Подпись C2PA проверить бесплатно легко, но она слетает от любого пересохранения. Отсутствие подписи ничего не говорит о происхождении картинок.
Что из этого следует
Невидимая метка Claude — не детектор ИИ-текста в привычном смысле, а подпись производителя. Неизменённый ответ модели она находит надёжно, а о тексте, который прошёл через человека, перевод или другую нейросеть, не говорит ничего. Проверить текст пока может узкий круг организаций, цифр точности нет.
Для обычного пользователя меняется немного. Берёте у Claude готовый текст и публикуете как есть, исходите из того, что он подписан. Используете модель как редактора, переводчика или собеседника для черновика, метка может найтись и в вашем собственном тексте. Держать это в голове полезно и тем, кто пишет, и тем, кто будет проверять.
А вы уже посмотрели, что из вашего текста подписано?