Claude объединил чат и агента. Что это меняет для видимости бренда
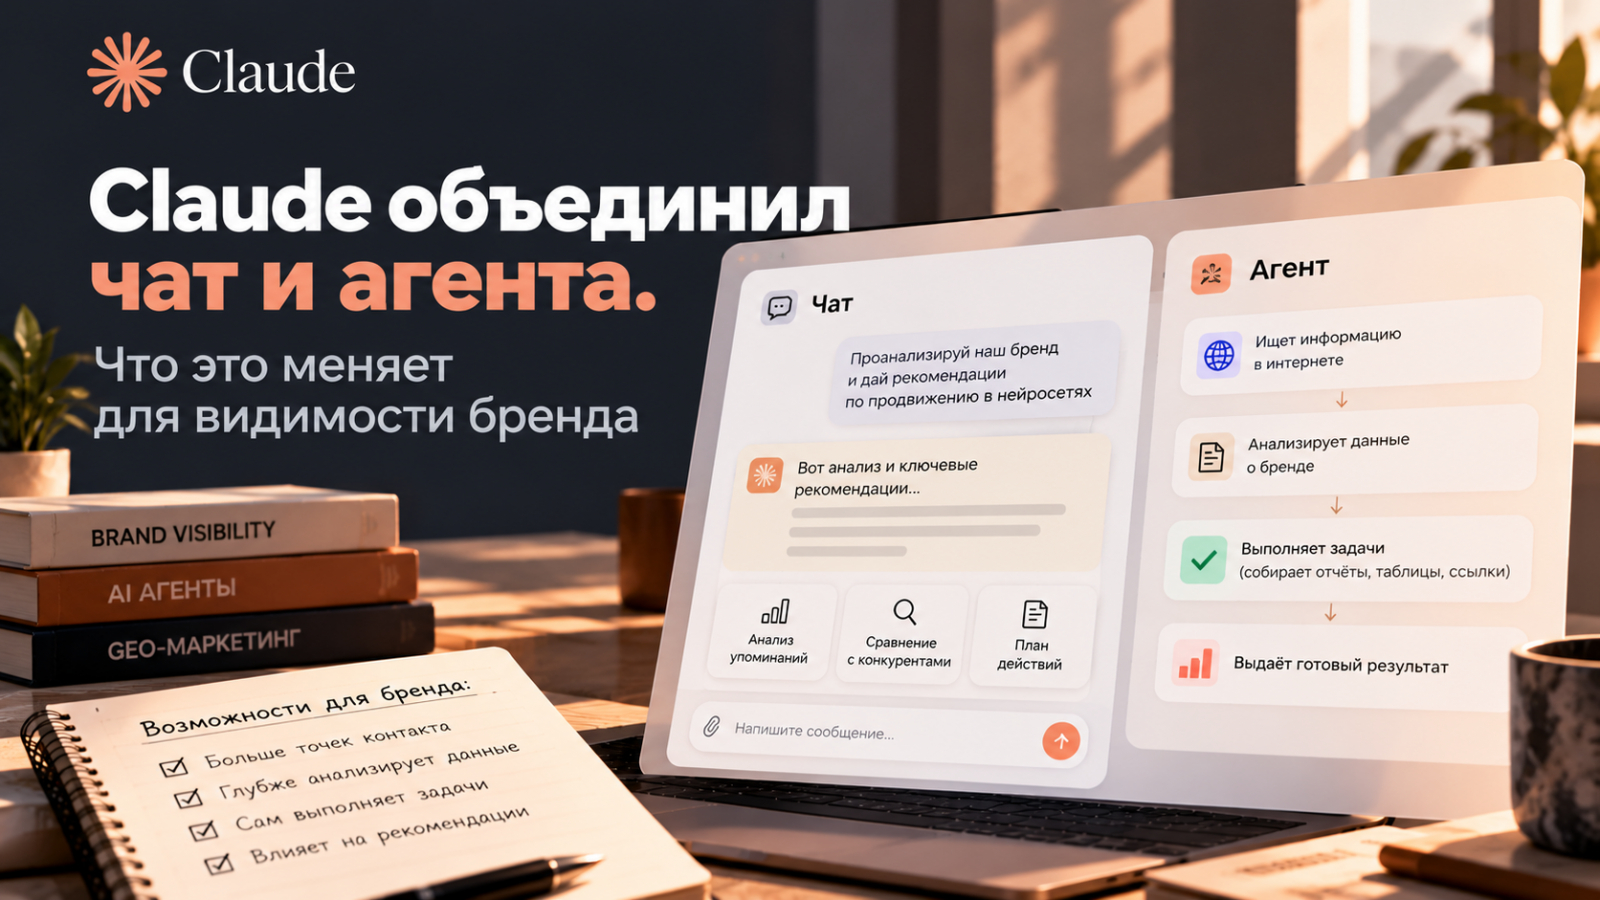
23 октября Anthropic сделала единый режим Chat и Cowork общедоступным для корпоративных клиентов Claude Enterprise. Сценарий простой: человек начинает с обсуждения задачи в чате, а затем поручает Claude довести её до результата самостоятельно. Модель собирает материалы, разбирает загруженные файлы и отдаёт готовый документ, не выходя из того же диалога.
На первый взгляд это новость про продуктивность и ничего больше. Но для бренда здесь меняется сама форма контакта с нейросетью. Раньше результатом разговора был совет, который человек потом проверял сам. Теперь результатом становится работа, в которой выбор уже сделан и зафиксирован.
Что меняется в сценарии выбора
До сих пор борьба шла за один вопрос: какие сервисы или подрядчиков выбрать. Бренду было важно попасть в список, который нейросеть выдаёт в ответ. Теперь к этому добавился следующий этап. Модель сравнивает варианты между собой, подбирает аргументы и переносит итог в таблицу, отчёт или черновик презентации, с которым дальше работает команда заказчика.
То есть проверяемых точек стало больше, и они идут одна за другой.
- бренд попал в исходный набор вариантов
- бренд остался в коротком списке после сравнения
- аргументы, которыми модель объяснила его выбор, совпадают с тем, что бренд говорит о себе сам
- бренд дошёл до финального документа, а не выпал на середине работы
Почему это не то же самое, что упоминание
Упоминание, рекомендация и использование это три разные вещи, и между ними происходит отсев. Бренд может регулярно появляться в ответах и при этом ни разу не доходить до этапа, где модель объясняет, почему стоит взять именно его.
Посмотрим на это глазами модели. Чтобы сравнить варианты, ей нужны проверяемые параметры: условия, ограничения, охват, сроки, цифры. Если во внешних источниках о бренде лежат только общие формулировки про надёжность и индивидуальный подход, сравнивать нечем. На этапе списка бренд ещё держится, на этапе сравнения выпадает первым.
Важно, что корпоративные диалоги закрыты и напрямую их не измерить. Доступна только публичная часть картины: на какие источники модель опирается в похожих запросах и что именно она оттуда берёт.
Что здесь поддаётся замеру
- входит ли бренд в набор вариантов по вашим ключевым запросам
- какие источники нейросеть цитирует рядом с брендом
- какими словами она объясняет его выбор и что приписывает конкурентам
- на каких формулировках запроса бренд пропадает из ответа совсем
Отдельный вопрос, откуда брать эти данные. На десятке запросов карту видимости можно собрать руками, открывая диалог за диалогом. Когда запросов сотни, нейросетей несколько и нужно сравнение с конкурентами в динамике, для этого берут сервисы мониторинга: brandfound, Semrush, Evertune и другие. Задача у замера одна: увидеть не только факт упоминания, но и аргументацию, с которой бренд попадает в ответ.
С чего начать на практике
- Выпишите пять запросов, с которыми корпоративный заказчик ищет решение вашего класса.
- Посмотрите, какой набор вариантов нейросеть даёт в ответ и по каким параметрам она их сравнивает.
- Найдите параметры, которых в ваших внешних публикациях нет, и закройте их конкретикой: условия, ограничения, цифры.
- Повторите замер через месяц и сравните не количество упоминаний, а аргументы.
Перемена не в том, что нейросеть стала больше делать за человека. Она в том, что результат выбора теперь сразу уезжает в рабочий документ, и переспрашивать модель никто не будет. Поэтому стоит заранее разобраться, что о вашем бренде лежит в источниках и совпадает ли это с тем, что вы сами о себе рассказываете.