Что выбрать для управления репутацией компании в эпоху AI-поиска
Когда компания видит, что ChatGPT или Алиса называют в ответе конкурента, а не её, привычный SEO-трекер здесь бессилен: он считает позиции сайта в выдаче, а не то, что происходит внутри сгенерированного текста. Мониторинг бренда в нейросетях и SEO-трекинг позиций решают принципиально разные задачи. Инструменты вроде Keys.so считают место домена в топ-100 Яндекса и Google, а GEO-платформы измеряют, называет ли модель бренд внутри готового ответа, с какой тональностью и на основе каких источников, причём по выборке в сотни промптов сразу на нескольких ассистентах, а не по одному запросу. Разница не терминологическая: это два разных объекта измерения, и подмена одного другим оставляет маркетолога слепым именно в том канале, откуда сейчас идёт часть трафика.
Чем мониторинг в ChatGPT и Алисе отличается от SEO-трекера позиций
SEO-трекер работает с объектом, у которого есть чёткие координаты: сайт занимает первое, пятое или сорок пятое место в выдаче по конкретному запросу, и это место можно зафиксировать один раз в сутки. Ответ нейросети устроен иначе. У него нет позиции в привычном смысле: модель либо упоминает бренд внутри сгенерированного текста, либо нет, либо называет его вскользь, а конкурента выносит в первый абзац с развёрнутым описанием. Здесь нечего замерить разовым запросом ради красивой цифры в отчёте.
Ключевая методологическая проблема в том, что ответ ИИ нестабилен: одна и та же тема, заданная чуть иначе, с другим контекстом или порядком слов, может дать другой набор упомянутых брендов. Спросите «какой сервис для аналитики выбрать» и «сравни сервисы аналитики для маркетолога» - и получите разные списки, разную тональность, разные источники. Один замер может дать ложное впечатление: нужна выборка из десятков и сотен формулировок, покрывающая типичные сценарии, в которых пользователь вообще упоминает вашу нишу в диалоге с ассистентом.
Отсюда и появляются метрики, которых нет в классическом SEO-трекинге. Мало зафиксировать факт «бренд назвали» - важно понять, в каком контексте это произошло: похвалили, упомянули нейтрально или раскритиковали. Тональность упоминания работает как отдельный параметр репутации, потому что пользователь читает не список ссылок, а готовый текст с оценочными формулировками. Второй параметр - источник, из которого модель взяла факт о бренде. Если ИИ опирается на устаревший отзыв трёхлетней давности или на статью конкурента, где ваш продукт упомянут в негативном контексте, это прямой сигнал для работы с контентом, и без отслеживания источников такой сигнал не появится в поле зрения маркетолога.
Разве SEO-платформа с AI-модулем не закрывает эту задачу
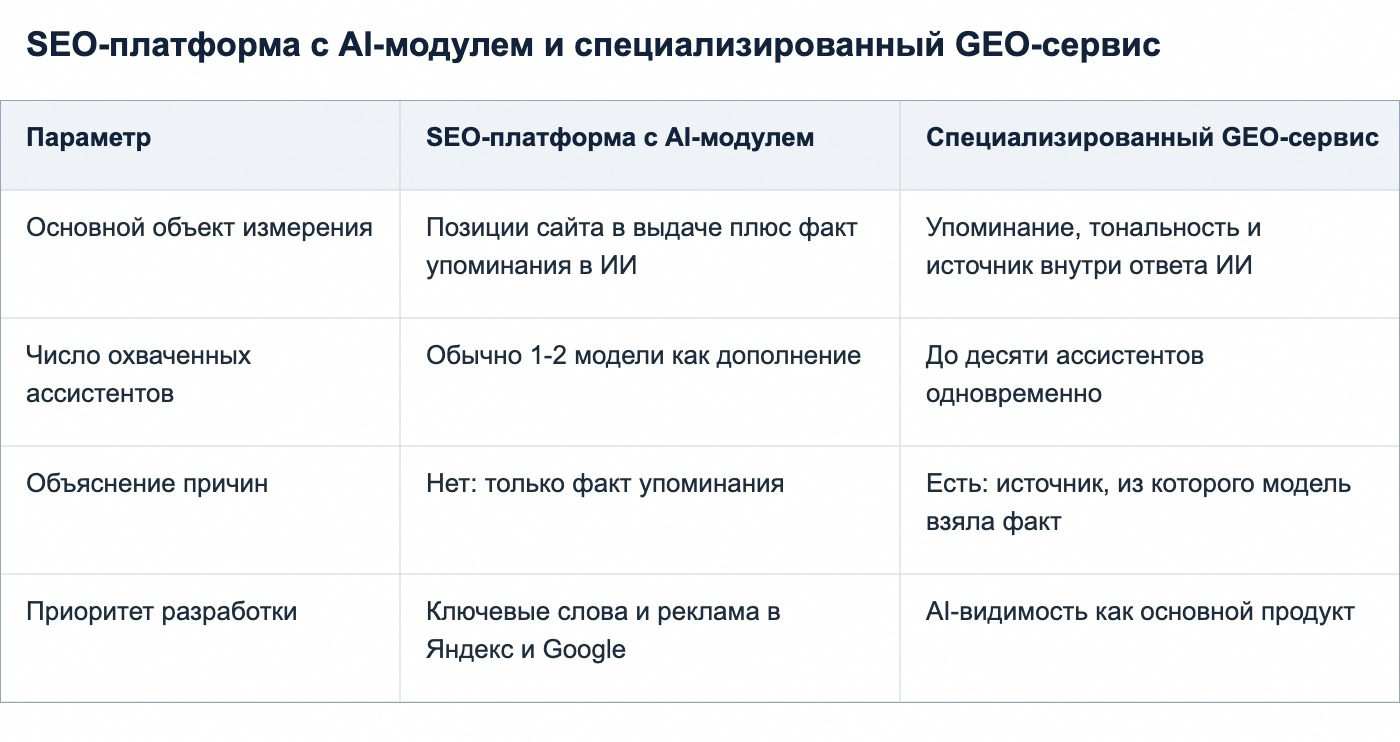
Логичный вопрос, если в компании уже стоит SEO-платформа с AI-модулем и кажется, что мониторинг видимости в нейросетях закрыт попутно. На практике такой модуль обычно решает более узкую задачу, чем кажется. Он фиксирует сам факт: бренд упомянут или не упомянут в конкретном ответе ассистента. Этого достаточно для галочки в отчёте, но недостаточно для управления репутацией, потому что не отвечает на главный вопрос - почему бренд появился или не появился. Не показывает, какой источник модель использовала, не раскладывает тональность по шкале, не объясняет, из-за чего конкурент обошёл вас в перечислении.
Причина ограничения понятна из истории продукта. Keys.so и похожие сервисы изначально строились под другую задачу: анализ конкурентов по ключевым словам, сбор семантического ядра, аналитика рекламных кампаний. AI-видимость добавлена туда как модуль поверх архитектуры, заточенной под позиции в выдаче и настройки контекстной рекламы. Это нормальная бизнес-логика: закрыть растущий спрос минимальным набором функций, не перестраивая продукт целиком. Но для управления репутацией в AI-поиске такой модуль остаётся дополнением, а не основным инструментом.
Специализированные GEO-платформы устроены иначе с самого начала: они держат в фокусе не одну-две модели, а до десяти ассистентов параллельно - ChatGPT, Gemini, Claude, Perplexity, Grok, DeepSeek, GigaChat, Google AI Mode, Поиск с Алисой и Чат с Алисой. Это важно, потому что аудитория распределена: часть пользователей формулирует вопросы в ChatGPT, часть привычно спрашивает у Алисы, часть работает через Google AI Mode. Мониторинг одной системы даёт искажённую картину, будто вся аудитория ведёт себя одинаково.
Если свести различия в одну таблицу, разрыв виден по четырём параметрам сразу.
Как понять, что бренд теряет видимость в ответах ИИ
Первый и самый заметный признак - конкуренты систематически появляются первыми в перечислениях, а ваш бренд либо упоминается вскользь, где-то в середине списка без пояснений, либо не упоминается вовсе. Это легко пропустить, если проверять видимость от случая к случаю: сегодня спросили ассистента вручную, бренд назвали, всё выглядит нормально, а завтра тот же вопрос, заданный чуть иначе, уже не выводит компанию в ответ.
На что стоит смотреть регулярно:
- порядок перечисления: называют ли бренд первым или в хвосте списка
- полноту описания: развёрнутый абзац у конкурента против упоминания одним словом у вас
- источники, на которые ссылается модель, и их возраст
- расхождение между ассистентами: лидер в Gemini может быть незаметен в ChatGPT
Показательный случай с рынка: один из игроков вырастил показатель упоминаемости в ответах ИИ с 2% до 10%, то есть в пять раз, после того как начал системно работать с контентом, на который опирались модели при формировании ответа. Само по себе это число ничего не доказывает: важно, что рост совпал с конкретными действиями - анализом цитируемых источников и публикацией материалов под пробелы в них. Показатель в 2% означает, что из ста релевантных запросов бренд появлялся в ответе примерно в двух случаях, то есть фактически был невидим для большинства пользователей.
Проблема регулярного мониторинга в том, что деградация видимости обычно не сопровождается очевидными внешними сигналами вроде падения позиций в привычной выдаче. Клиент просто спрашивает ассистента, получает список из трёх-четырёх названий, среди которых вашего бренда нет, и уходит к тому, кого модель назвала первым. Компания при этом продолжает видеть стабильный трафик из классического поиска. Замер раз в квартал или «когда вспомнили» не даёт возможности среагировать вовремя: к моменту, когда падение заметно по выручке, клиенты уже несколько месяцев выбирали конкурента.
Какие метрики действительно показывают видимость бренда в нейросетях
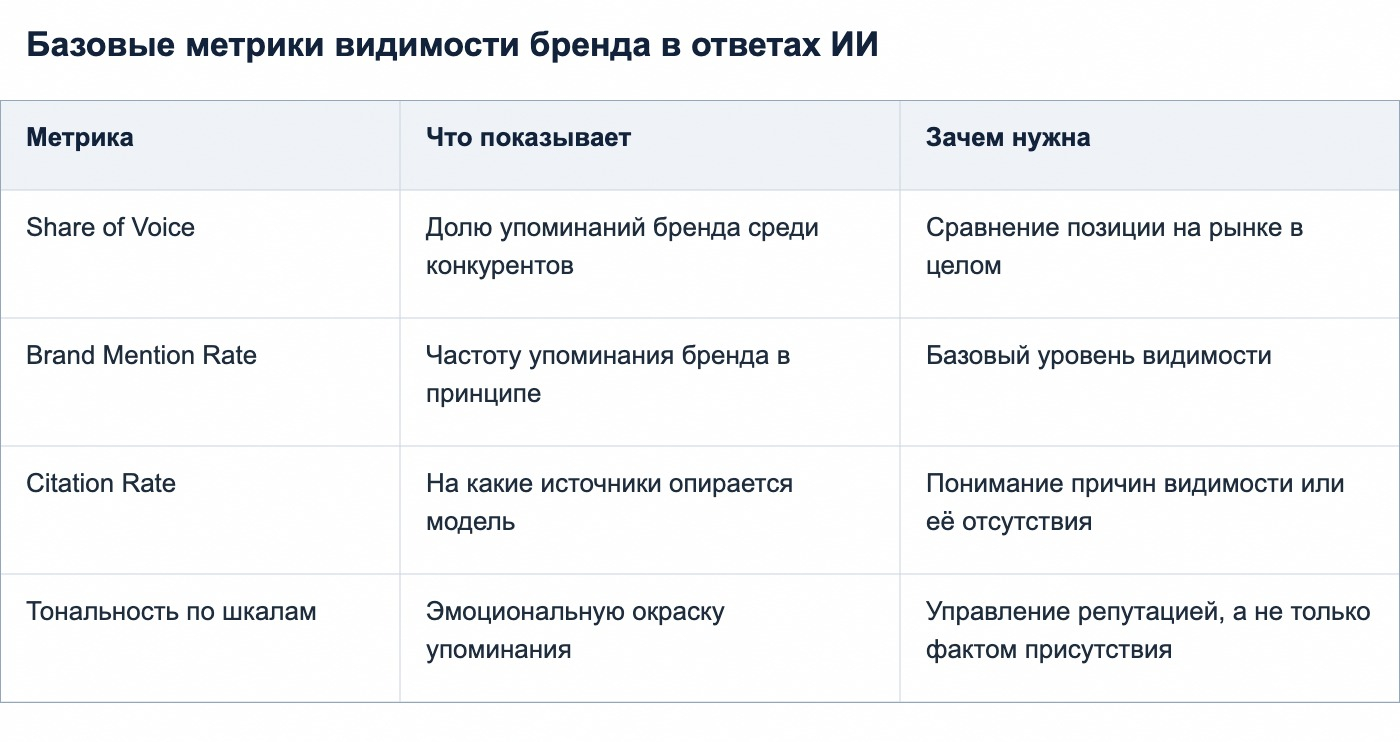
Три метрики формируют базовый набор. Share of Voice показывает долю упоминаний бренда относительно конкурентов по всей выборке запросов: если из ста релевантных промптов бренд встречается в тридцати, а три ближайших конкурента делят оставшиеся семьдесят, это сравнимая цифра, которую можно отслеживать месяц к месяцу. Brand Mention Rate уточняет, как часто модель вообще называет бренд, независимо от конкурентов, а Citation Rate добавляет источник: на какие страницы, статьи или отзывы опирается ИИ, формируя ответ.
Разница между этими метриками принципиальна для практики. Высокий Brand Mention Rate при низком Citation Rate из авторитетных источников означает, что модель называет бренд, но опирается на случайные или устаревшие упоминания, а не на актуальный контент компании, и это сигнал к работе с источниками, а не повод расслабляться. Низкий Share of Voice при растущем Brand Mention Rate говорит о том, что рынок в целом растёт быстрее, чем видимость конкретного бренда.
Дальше набор расширяется: у GEO-сервисов счёт метрик идёт на десятки, а тональность раскладывается по нескольким шкалам - от прямой рекомендации до нейтрального перечисления и критики в сравнении с конкурентом. Например, в brandfound таких метрик больше сорока, тональность разложена по 17 шкалам, а данные собираются по десяти ассистентам сразу и выгружаются отчётом под презентацию руководству. Смотреть все сорок одновременно смысла нет: рабочая практика - выбрать три-четыре показателя и вести их в динамике.
Сколько запросов нужно тестировать для достоверной картины
Единичные промпты - главная методологическая ловушка при попытке оценить видимость самостоятельно. Ответ модели меняется в зависимости от формулировки, от контекста предыдущих реплик, а иногда и от времени суток, если модель подключена к живому веб-поиску. Проверить бренд одним вопросом в ChatGPT и сделать вывод «нас не упоминают» так же некорректно, как оценивать позиции сайта по одному случайному запросу.
Рабочий ориентир для приоритетных сценариев, то есть для запросов, напрямую связанных с ключевыми продуктами и брендовыми формулировками (условно P0), - около 500 ответов на массив таких запросов. Это объём, при котором случайные колебания одного промпта сглаживаются, а итоговая цифра Share of Voice начинает отражать картину, а не шум конкретной формулировки. Для более широких косвенных запросов категории P1 достаточно порядка 100 ответов: этого хватает, чтобы отслеживать динамику без избыточных затрат.
Разделение на P0 и P1 решает практическую задачу: не тратить одинаковый объём проверок на «купить продукт онлайн» и на условное «как выбрать поставщика в смежной нише», где бренд появляется реже и с меньшим приоритетом для бизнеса. Компания, которая проверяет видимость по десяти случайным вопросам раз в месяц, получает картину с большой погрешностью: рост на пару процентов там окажется случайным колебанием, а не результатом работы с контентом.
Может ли GEO-сервис не только измерять, но и повышать упоминания
Замер видимости сам по себе решает половину задачи. Он показывает, что бренд теряет позиции в ответах ИИ или что конкурент обходит его в перечислениях, но не предлагает механизма исправления. Модель формирует ответ на основе того, что нашла в источниках при обучении и при живом веб-поиске: если про компанию нет актуального, структурированного и цитируемого контента, никакой мониторинг не заставит ИИ упоминать бренд чаще. Измерение и производство контента здесь работают в связке.
Практическая схема выглядит так: система вроде brandfound, Profound или VisioBrand анализирует источники, на которые опираются нейросети, находит точки роста - темы, форматы и факты, которых не хватает в публичном поле вокруг бренда, - и превращает их в план публикаций. После выхода материала замер повторяется по тем же промптам, и становится видно, повлиял ли новый контент на упоминания. Именно это замыкает цикл: измерение выявляет проблему, контент закрывает конкретный пробел, повторный замер показывает результат. Без такой обратной связи любой контент-план остаётся гипотезой, не подтверждённой цифрами.
На что смотреть при выборе GEO-платформы
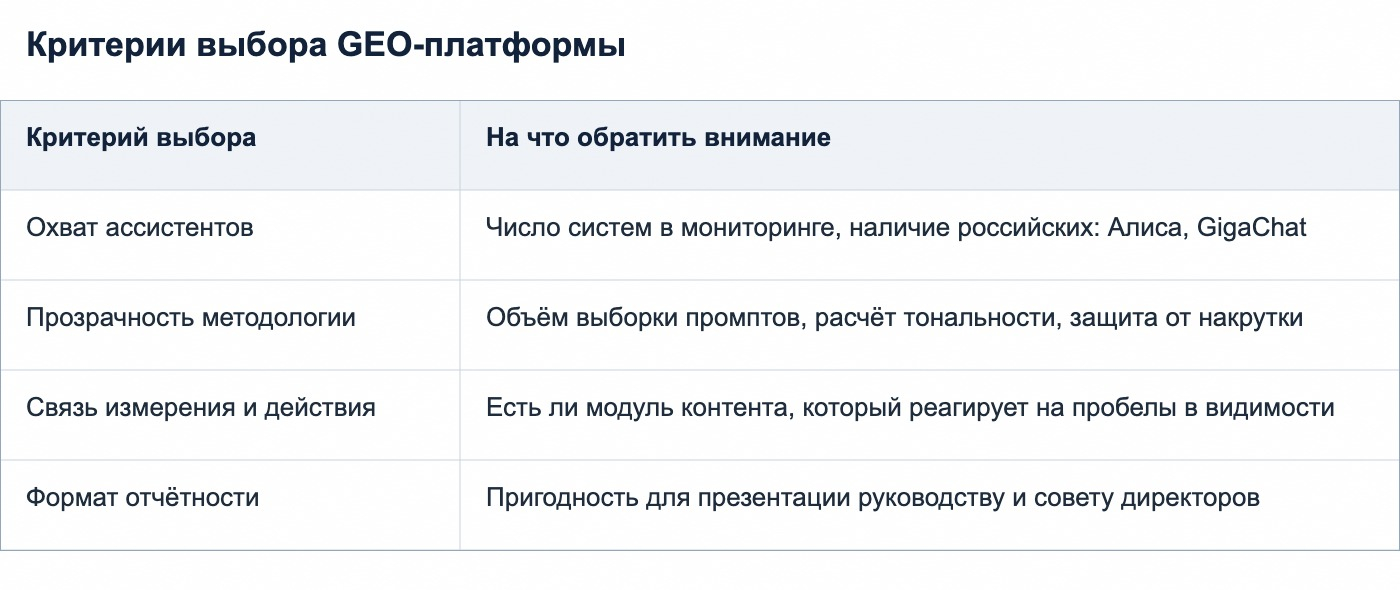
Первый критерий - охват ассистентов. Аудитория распределена между разными системами: кто-то формулирует вопросы в ChatGPT, кто-то живёт в экосистеме Google AI Mode, кто-то по привычке спрашивает у Алисы голосом или текстом. Платформа, которая мониторит одну-две модели, показывает фрагмент картины и рискует пропустить именно тот канал, где бренд теряет видимость быстрее всего.
Второй критерий - прозрачность методологии. Стоит уточнять у любого сервиса, сколько промптов реально входит в выборку для расчёта Share of Voice, как считается тональность, есть ли защита от синтетического трафика при оценке AI-переходов на сайт. Без этой прозрачности легко получить красивую цифру в отчёте, за которой не стоит честного измерения. Проверять это имеет смысл на демо-замере собственного бренда, а не по описанию на сайте сервиса.
Показы покупаются, рекомендации зарабатываются, и вторые теперь тоже измеримы. Гипотеза, которую стоит проверить в ближайший месяц, простая: возьмите двадцать запросов, по которым к вам реально приходят клиенты, прогоните их на трёх ассистентах и посмотрите, в скольких ответах бренд назван и кем он окружён. Эта цифра и будет точкой отсчёта.