LSI-слова: что это на самом деле и как собрать их по ТОПу
Я прочитал двадцать статей, которые Яндекс показывает первыми по запросу «LSI слова». Девятнадцать расшифровывают термин как латентно-семантическое индексирование. Шесть пишут, что поисковики этим методом пользуются, ещё шесть — что нет. Ниже — что на самом деле стоит за LSI-словами, как собрать их список, которому можно верить, и сколько раз их вписывать.
Что такое LSI и почему LSI-слова — не LSI
LSI, latent semantic indexing, — метод информационного поиска из статьи Скотта Дирвестера и соавторов 1990 года. Матрица «термины × документы» раскладывается примерно на сотню скрытых факторов, и документы находятся по близости в этом сжатом пространстве, а не по совпадению слов.
Поисковики понимают смысл другими средствами. Джон Мюллер из Google закрыл вопрос про LSI-ключи в 2019 году одной фразой в Twitter: «There's no such thing as LSI keywords — anyone who's telling you otherwise is mistaken, sorry». Таких ключей не существует, и кто утверждает обратное — ошибается. Яндекс с 2016 года сопоставляет запрос и страницу нейросетью: в блоге компании про алгоритм «Палех» сказано, что поиск находит страницы, которые соответствуют запросам «не только по ключевым словам, но и по смыслу».
Так что LSI-слова, LSI-ключи, LSI-фразы и весь «LSI-копирайтинг» — одно рыночное название, к методу 1990 года отношения не имеющее. Под ним понимают словарь темы — слова, которыми страницы из выдачи говорят о предмете и которых почти нет в обычном тексте. Для запроса «как выбрать зимнюю резину» это «протектор», «сцепление», «шиповать», «слякоть», «тормозной путь». Словарь существует независимо от названия, и собирать его стоит: текст без слов предмета раскрывает тему хуже, сколько бы раз в нём ни повторялся запрос.
Поэтому в ТЗ, которое собирает Словоправ, этот блок называется не «LSI», а «Ключевые слова из текстов конкурентов»: название должно говорить, что внутри.
Что пишут двадцать статей из ТОПа
28 сентября 2026 года я снял ТОП-20 Яндекса по запросу «LSI слова» (регион — Москва) и прочитал все статьи. Медианная длина — около 1 600 слов, определения почти одинаковые. Расходятся статьи в главном — в том, как собирать список.
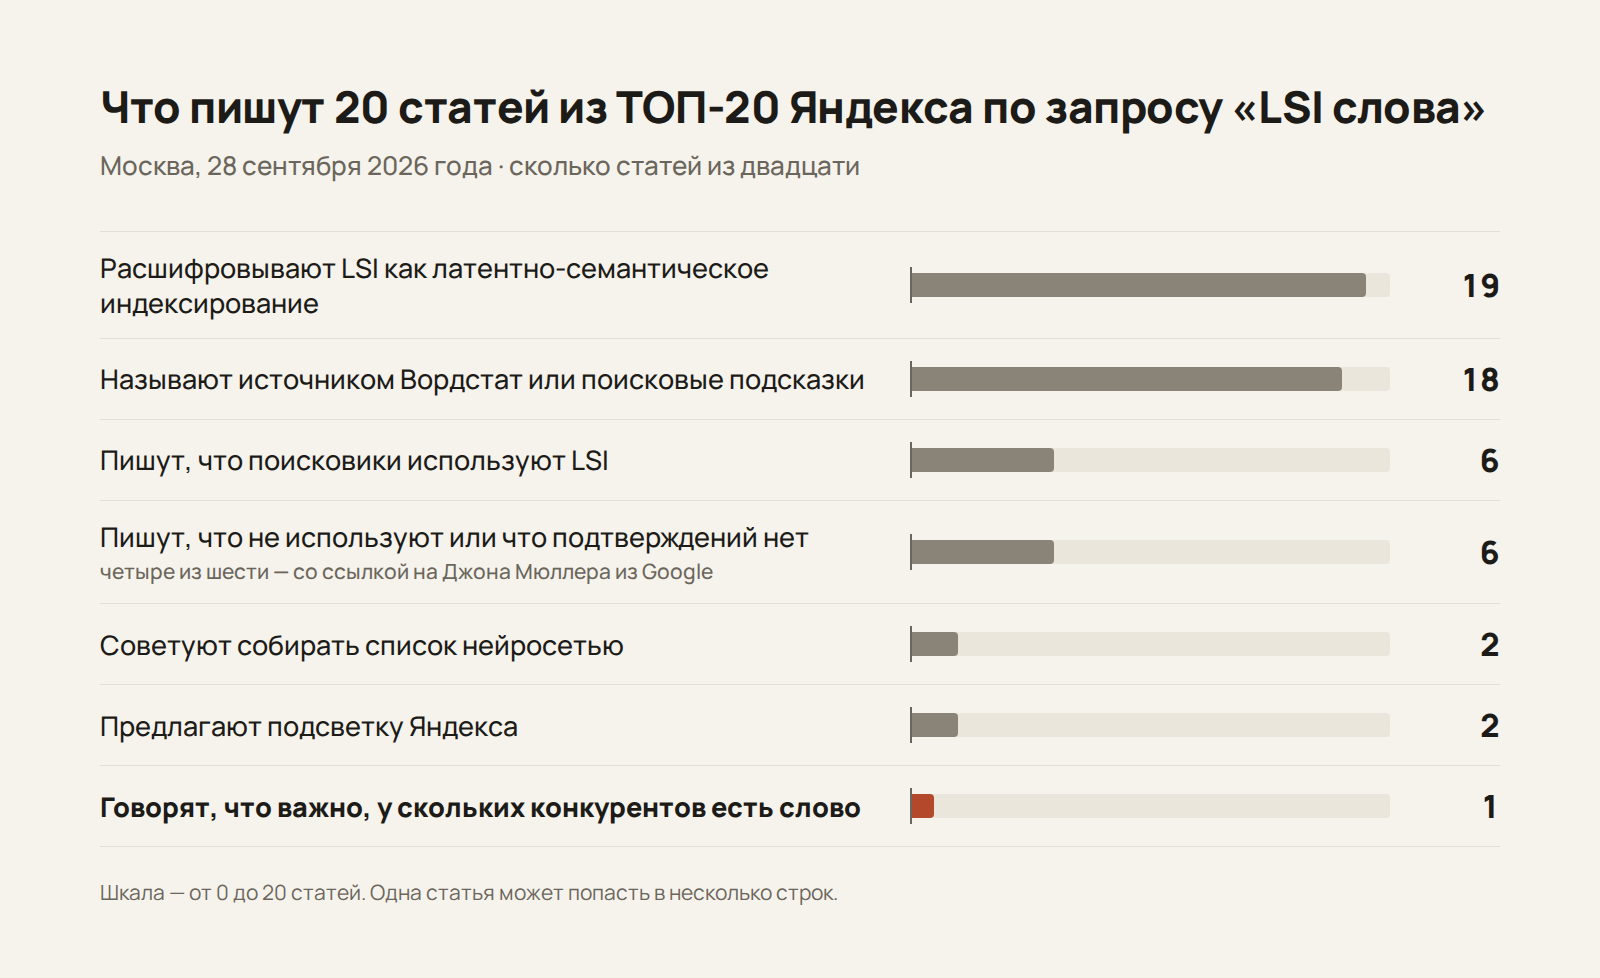
Последняя строка — самая важная, к ней я вернусь в пятом шаге.
Как собрать LSI-слова, которым можно верить
Вордстат и поисковые подсказки — самые частые источники в статьях из ТОПа, но они показывают, как люди формулируют запросы, а не какими словами написаны страницы. Для семантического ядра они годятся, для словаря текста — нет. Словарь собирают из самих страниц. Примеры ниже — из реального ТЗ по запросу «как выбрать зимнюю резину».
- Снимите выдачу по своему запросу и в своём регионе. В Москве и в Новосибирске ТОП состоит из разных страниц, и словарь у них может отличаться. Название города из запроса в список попадать не должно: это регион, а не тема.
- Оставьте страницы своего типа. Если вы пишете статью, каталоги и карточки товаров в выборке только мешают: их словарь — «в корзину», «доставка», «в наличии». Маркетплейсы и агрегаторы — туда же. Для зимней резины в группу сравнения попали пять страниц.
- Приведите слова к начальной форме. «Шина», «шины» и «шинами» — одно слово. Иначе одно понятие размажется по нескольким строкам списка, и ни одна из них не наберёт веса.
- Отсейте общий язык. Нужны слова, которые в текстах темы встречаются часто, а в русском языке в целом — редко; так устроена формула TF-IDF. «Также», «является» и «компания» есть везде и о теме ничего не говорят. Меню сайтов и названия брендов-конкурентов — тоже в отсев.
- Посчитайте, у скольких конкурентов есть слово. «Шина» есть на всех пяти страницах — это обязательное слово, без него текст не о том. «Слякоть» — на двух из пяти: дополнительное, его берут, если оно подходит по смыслу. А слово, которое одна страница повторила сорок раз, — особенность этой страницы, а не темы.
- Добавьте подсветку Яндекса. Слова, которые Яндекс выделяет жирным в сниппетах, он сам считает синонимами и формами запроса. По зимней резине это «шина», «выбор», «выбирать», «покрышка», «подобрать». Это единственный список, который составил сам поисковик, а не мы за него.
Почему не попросить нейросеть
Соблазн понятен: вставить запрос в ChatGPT и через секунду получить полсотни LSI-фраз. Одна из статей ТОПа даже приводит для этого готовый промпт. Проблема не в том, что список будет плохим, — он будет каждый раз другим.
Мы замеряли это, когда делали Словоправ. Десять раз подряд попросили модель выписать главные понятия темы из одних и тех же текстов конкурентов, с температурой 0 — настройкой, которая должна давать одинаковый ответ. Получилось 52 разных понятия, и во всех десяти списках совпали только два.
Список, который меняется от запуска к запуску, нельзя ни проверить, ни отдать копирайтеру как требование. Поэтому модель у нас получает тексты конкурентов и отвечает несколько раз, похожие формулировки склеиваются в одно понятие, а в отчёт попадает то, что она называет хотя бы в половине ответов. И этот список — дополнение к статистике по страницам ТОПа, а не её замена. Если же спросить чат-бот без текстов, он не видит выдачу вовсе и уверенно придумает «универсальные» LSI для любого запроса.
Сколько раз вписывать LSI-слова
Считайте частоту на тысячу слов, а не вхождения. Частая подсказка текстовых анализаторов: «у вас слово встречается 19 раз, у конкурентов 9 — сократите». Но ваш текст — 960 слов, а типичный текст конкурента — 456. Девятнадцать на 960 слов — это 19,8 на тысячу, девять на 456 — 19,7. Частота одинаковая, сокращать нечего, а если послушаться, она станет вдвое ниже, чем у конкурентов.
Отсюда и форма требования: не одно число, а диапазон под рекомендуемый объём. В ТЗ по зимней резине «шина» стоит как 39–67 раз для текста около 1 760 слов. Это частота от нижней до верхней четверти конкурентов, пересчитанная на медианный объём выдачи.
Второе правило: слово, которое есть больше чем у половины конкурентов, — язык темы, а не переспам. «Шина» в статье о зимней резине переспамом быть не может. Переспам — это заметный отрыв от типичной частоты у конкурентов, и мерить его стоит от медианы, а не от среднего: одна страница с сорока повторами тянет среднее вверх, а медиану почти не трогает.
И последнее: вписывать слова ради счёта бессмысленно. Если слово из списка не ложится в текст, значит, в тексте не хватает куска темы, где оно нужно. Дописывать надо этот кусок, а не слово.
Что дальше
Шесть шагов можно пройти руками: снять выдачу, скопировать тексты, прогнать их через лемматизатор и посчитать частоты в таблице. Это часы работы на один запрос. Я делаю Словоправ — сервис, который проходит эти шаги за 2–4 минуты: снимает ТОП-20 Яндекса или Google, делит выдачу по типам страниц и собирает ТЗ, где словарь темы разделён на обязательные и дополнительные слова — с диапазоном вхождений под рекомендуемый объём, долей конкурентов, у которых слово есть, устойчивыми фразами и подсветкой Яндекса. Полное ТЗ по зимней резине, из которого взяты примеры, лежит на сайте сервиса.