Alice AI Foundation LLM: что открытая модель Яндекса даёт маркетингу и продуктовым командам
21 сентября 2026 года Яндекс выложил в открытый доступ Alice AI Foundation LLM. Это языковая модель на 80 млрд параметров, созданная без иностранных компонентов. Для бизнеса она означает возможность запускать ИИ-функции на русском языке на собственных серверах.
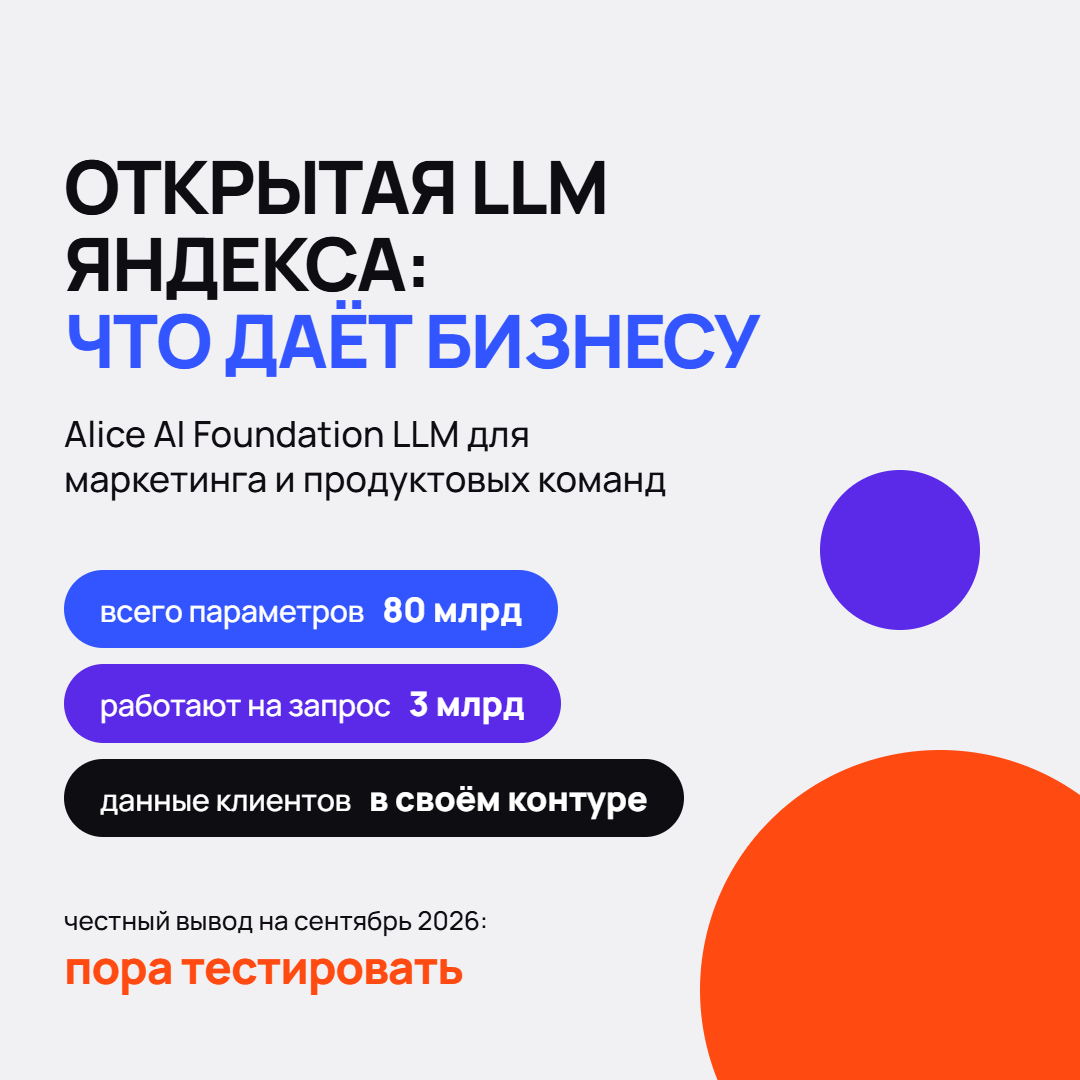
Модель весит 80 млрд параметров. На каждый запрос из них работают три миллиарда.
В этом разрыве и спрятан главный смысл релиза для тех, кто отвечает за бюджеты на ИИ. Громкое слово «суверенная» привлекает внимание, но решение о внедрении будут принимать по другим параметрам: сколько стоит один ответ, где хранятся данные клиентов и насколько хорошо модель понимает русский язык. По всем трём пунктам у новой модели Яндекса есть что обсудить. Есть и ограничения, о которых пресс-релизы обычно молчат.
Что именно выпустил Яндекс 21 сентября 2026 года
Alice AI Foundation LLM построена на архитектуре Mixture of Experts («смесь экспертов»). Из 80 млрд параметров при обработке запроса задействуются только 3 млрд, поэтому модели нужно заметно меньше вычислительных ресурсов. По данным Яндекса, модель уверенно справляется с программированием, математикой и вопросами на русском языке.
Результаты тестов компания привела такие. На олимпиадных задачах по математике модель разделила первое место с Qwen3.5-35B-A3B-Base. В тестах на написание кода она обошла Nvidia Nemotron-3-Super-120B-Base, у которой активных параметров в четыре раза больше. В заданиях на знание фактов модель опередила более крупную открытую DeepSeek-V4-Flash-Base и показала результаты на уровне предыдущей закрытой модели Яндекса, Alice AI LLM, хотя у той втрое больше параметров и в семь раз больше активных.
Вместе с моделью Яндекс опубликовал два открытых теста для русскоязычных задач. WikiWebFacts проверяет знание дат, событий, определений и персоналий. HardMultiQA собран на основе обезличенных запросов к «Алисе AI» и включает задания по медицине, праву, IT и искусству. Модель, технические отчёты и оба теста доступны на Hugging Face.
Почему бизнесу важна архитектура, а не статус «суверенной» модели
Архитектура Mixture of Experts напрямую влияет на стоимость каждого ответа. Модель хранит много знаний, но на конкретный запрос включает только нужную часть. Для компании это означает менее мощное и более дешёвое оборудование под ту же задачу. Когда ИИ разбирает тысячи обращений в день или генерирует описания для всего каталога, разница в стоимости одного ответа быстро превращается в строку бюджета.
Второй аргумент касается открытого доступа. Модель можно развернуть в собственном контуре, а не отправлять запросы во внешний облачный сервис. Для маркетинга это принципиально: CRM, история заказов и переписка с клиентами содержат персональные данные, и их обработка подпадает под ФЗ-152. Модель на своих серверах снимает вопрос о том, куда уходят эти данные.
Третий аргумент – русский язык. Западные модели понимают русский, но на запросах с местным контекстом ошибаются чаще. Это касается законодательства, названий, сленга и того, как люди на самом деле формулируют жалобы. Яндекс сделал русскоязычные задачи отдельным фокусом и выложил тесты для их проверки. Любая компания может прогнать через них свою модель и сравнить.
Где открытая модель пригодится маркетингу и продукту
Модель с хорошим русским и невысокой стоимостью ответа подходит для задач, где объём большой, а цена ошибки умеренная:
- Классификация входящих обращений и отзывов: жалоба, вопрос, предложение, срочность.
- Черновики описаний товаров для маркетплейсов и сайта по шаблону бренда.
- Поиск по внутренней базе знаний для поддержки и отдела продаж.
- Разметка и суммаризация данных для исследований аудитории.
- Внутренние ассистенты, которым нельзя отправлять данные во внешние сервисы.
Отдельная линия связана с планами самого Яндекса. Компания проверяет на этой модели архитектурные решения для будущей единой рассуждающей модели, которая должна лечь в основу агентных функций «Алисы AI». Пользователи смогут поручать ассистенту конкретные действия, а не только задавать вопросы. Для брендов это сигнал заранее продумать, как их продукт будет выглядеть для ИИ-агента, который выбирает и покупает за человека.
Чего релиз пока не решает
Яндекс сам называет модель экспериментальной. Это не готовый продукт для внедрения в понедельник, а основа для исследований и дальнейшей разработки.
Есть ещё три ограничения, которые стоит держать в голове. Первое: все результаты тестов приведены самим Яндексом, независимых сравнений на реальных бизнес-задачах пока нет. Второе: модель сравнивали с базовыми версиями других моделей, то есть с моделями до дообучения под диалог и инструкции. Чтобы базовая модель вела себя как ассистент поддержки или копирайтер, её придётся дообучать, а это отдельный проект со своими данными и сроками. Третье: развёртывание в своём контуре требует серверов и людей, которые будут это сопровождать. Перед коммерческим использованием стоит отдельно прочитать условия лицензии.
Честный вывод такой: для большинства компаний Alice AI Foundation LLM на сентябрь 2026 года – повод начать тестирование, а не менять текущий стек.
Как подходить к выбору модели: опыт проекта Fortech
Fortech (fortech.dev), аккредитованная IT-компания из Ростова-на-Дону, работает с ИИ-функциями в маркетинговых продуктах. Один из проектов – платформа автоматизации инфлюенс-маркетинга с полным циклом работы с блогерами. Платформа ищет и анализирует подходящих инфлюенсеров через ИИ, автоматизирует переписку с ними по почте и считает эффективность кампаний. Команда Fortech построила интеграцию между интерфейсом и внешним ИИ-сервисом через систему обмена сообщениями NATS, встроив её в микросервисную архитектуру. Для общения ИИ-бота с пользователями в реальном времени сделала отдельный канал на WebSocket.
Главный урок таких проектов: ИИ-сервис стоит подключать как заменяемый модуль. Если модель вызывается через отдельный слой, её можно поменять без переписывания всего продукта. Сегодня это внешний сервис, завтра открытая модель в собственном контуре, послезавтра следующая версия. Когда компании приходят за внедрением ИИ в бизнес-процессы, первый вопрос обычно звучит как «какую модель выбрать». Практичнее начинать с архитектуры, в которой выбор модели можно пересмотреть через полгода без потерь.
Рынок это подтверждает. По данным исследования AIANA RAI-2026, объём рынка ИИ в России за 2025 год составил 316,1 млрд рублей. При таком росте новые модели будут выходить постоянно, и привязывать продукт к одной из них всё рискованнее.
С чего начать
Alice AI Foundation LLM не отменяет текущие решения, но добавляет реальный вариант для компаний, которым важны русский язык, стоимость ответа и данные внутри контура. Первый шаг простой: выбрать одну задачу с большим объёмом, например разбор отзывов, прогнать на ней открытые тесты Яндекса и собственную выборку, а затем сравнить результат с моделью, которая работает сейчас.