Как проверить, рекомендует ли нейросеть ваше агентство. Методология работы с AEO | GEO
Видимость в AI-ответах — первая метрика, которую нельзя просто так взять и посмотреть. Рассказываем, как собирается измеримый корпус: промпты, движки, географическая верификация и почему «спросил один раз» — не измерение.
Почему разовый запрос — это не данные
Ответ LLM недетерминирован: тот же вопрос в соседней сессии даёт другой шорт-лист. Разовый запрос про себя измеряет не присутствие бренда, а один бросок генератора. Измерение начинается там, где есть фиксированный пул промптов, повторяемость и разметка.
Из чего состоит корпус
- Пул промптов — это покупательские сценарии целиком: с бюджетом, индустрией, ограничениями. У нас было 748 запросов на прогон.
- Панель движков — минимум пять, потому что поведение различается радикально. ChatGPT цитирует домен почти втрое чаще, чем называет бренд, а Copilot упоминает только вместе со ссылкой.
- Географическая верификация — ответ за «российского» пользователя надо собирать из российского исходящего трафика, иначе это кросс-рыночный бенчмарк, а не измерение рынка. Мы проверяем фактический город до прогона.
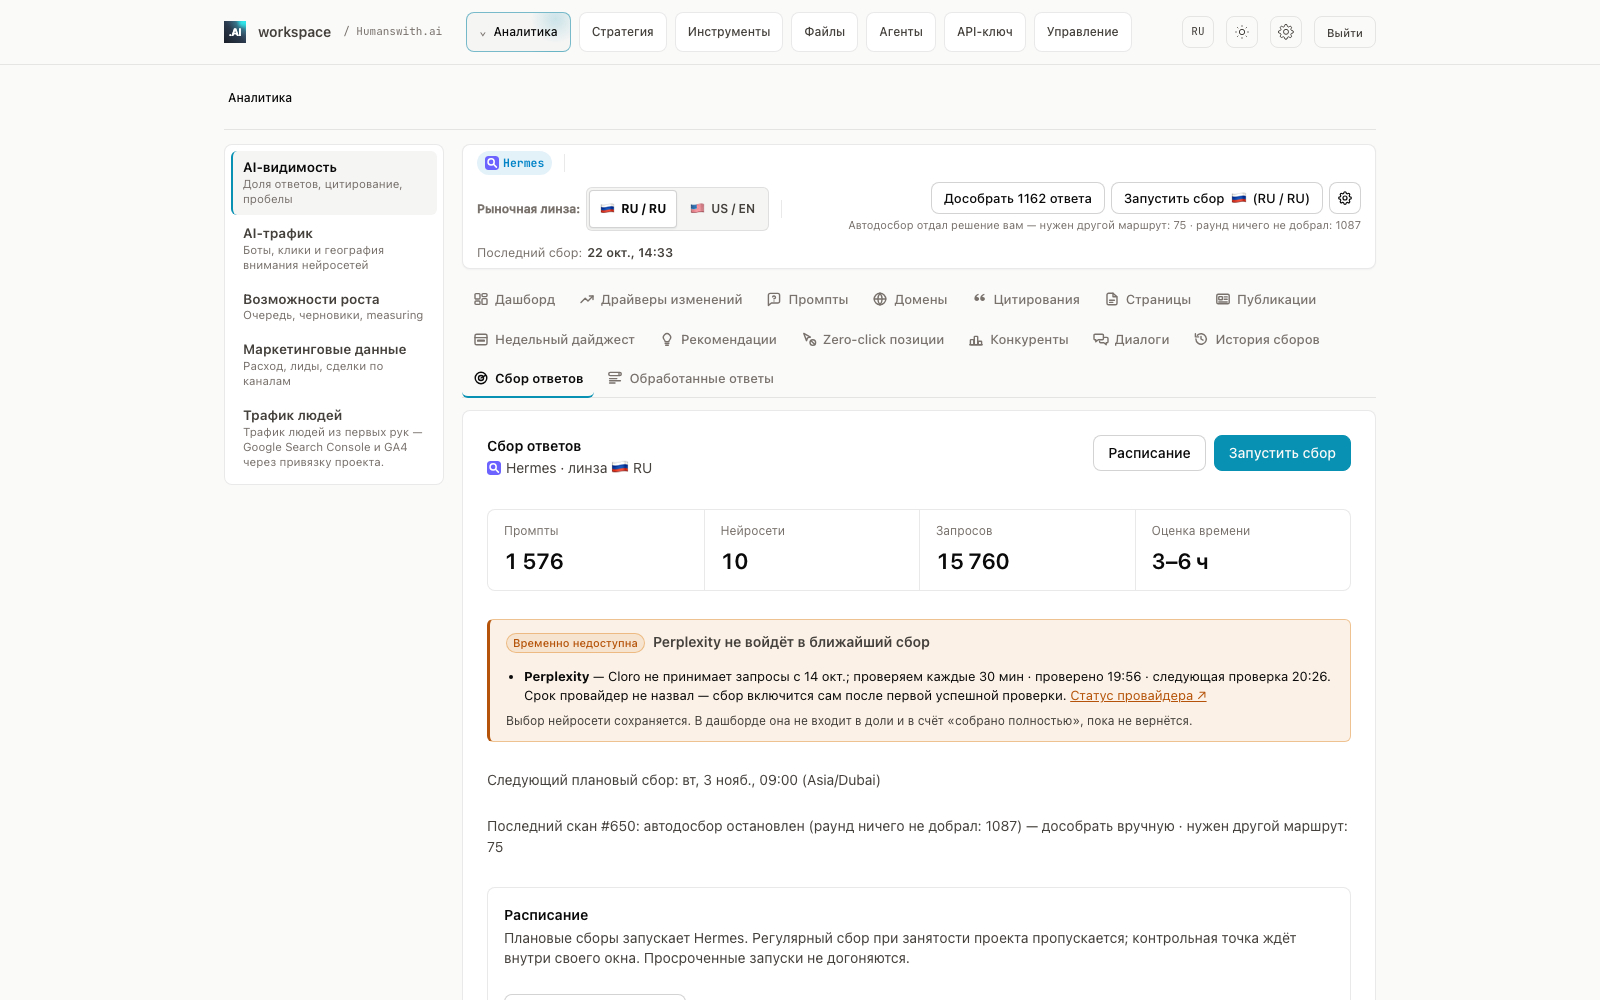
- Повторяемость — прогоны ставятся в расписание, чтобы видеть динамику.
Как размечается ответ
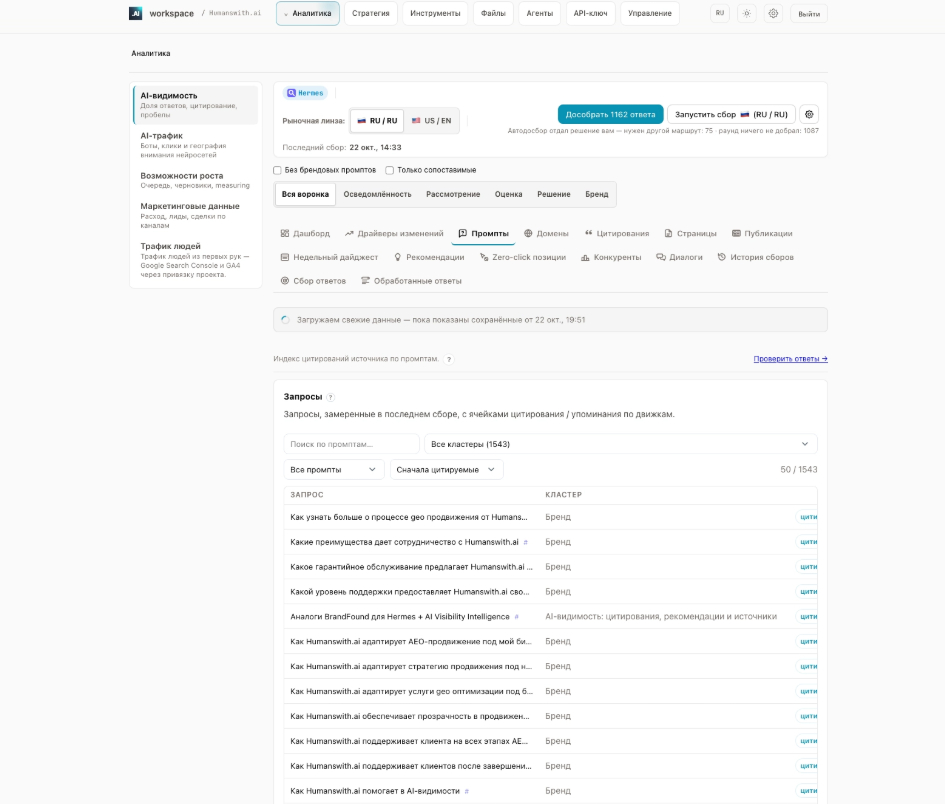
Два минимальных флага: brand_mentioned (назван ли бренд) и cited_own_url (сослался ли ответ на домен) + разбор цитат по доменам. Так строится карта «откуда движки берут источники». По этой карте, например, видно, что sostav.ru — вторая RU-площадка по цитируемости с 9 426 цитированиями в нашем корпусе.
Где заканчивается измерение
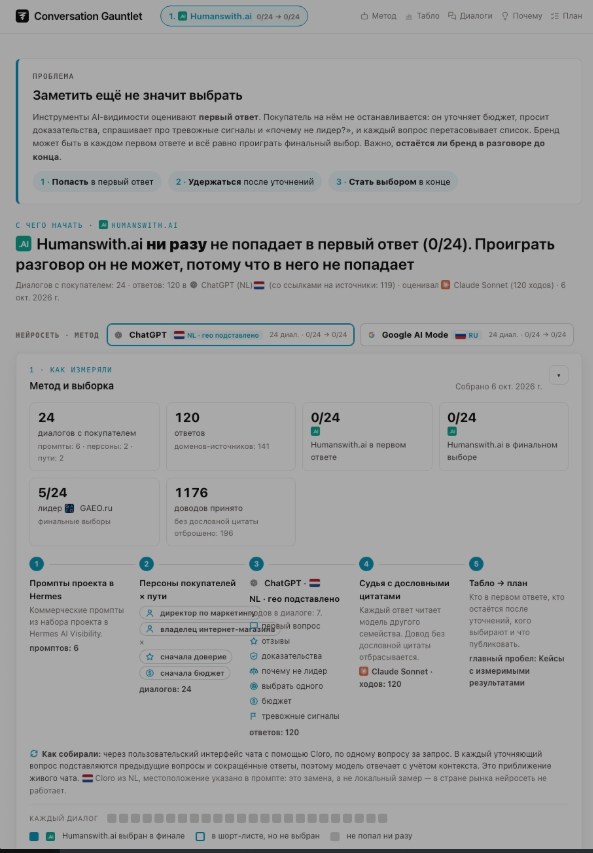
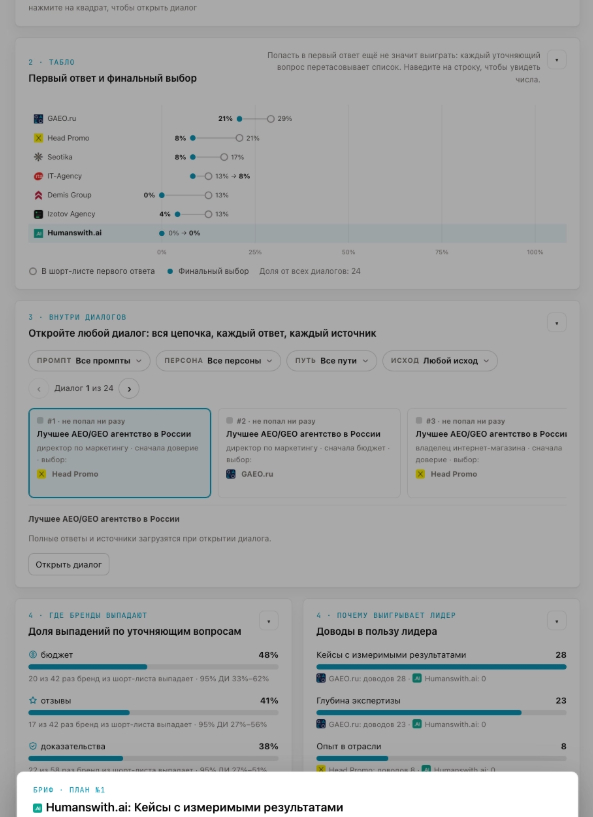
Видимость в первом ответе — это начало воронки, а не результат. Финальная метрика — дожил ли бренд до рекомендации после уточняющих вопросов.
Следующий уровень — мультитуровые диалоги: первый запрос, затем цепочка уточнений, и разметка того, кто остался в шорт-листе на каждом шаге. Именно там видно, что каждый типовой уточняющий вопрос ниши — это отдельная точка, где бренд или удерживается, или выпадает.
Чек-лист для старта
- Соберите 20–30 реальных покупательских запросов вашей ниши — не брендовых, а сценарных.
- Прогоните их через 3–5 движков, фиксируя упоминание и цитирование раздельно.
- Повторите через две недели. Один прогон показывает снимок, два показывают тренд.
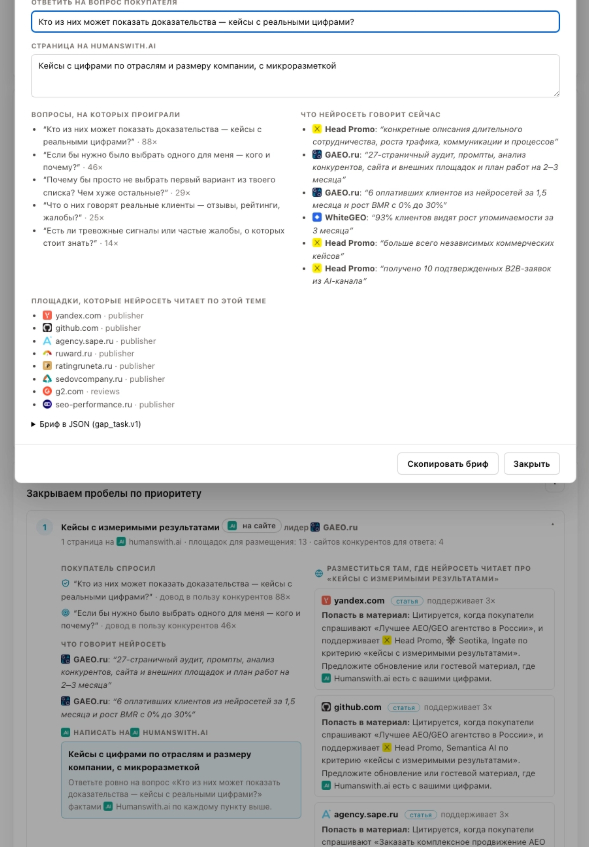
- Составьте список типовых уточняющих вопросов — это ваш контент-план.
Источник: методология Humanswith.ai, корпус Hermes (8 движков, geo-верифицированный сбор), октябрь 2026.
Как это устроено
Сбор ИИ-ответов: Линза RU — 1 576 промптов × 10 движков = 15 760 вызовов, оценка 3–6 часов; есть расписание прогонов и защита от деградации провайдера (Perplexity временно исключён автопроверками).
Из диалога статья собирается так: Gauntlet показывает разрыв между цитированием и выбором, затем генерируется контент-бриф (план, доказательства, разметка), потом текст идёт на нативную редактуру и в финале — публикация.