1 290 забытых URL: как страницы-сироты мешают поисковому продвижению интернет-магазина
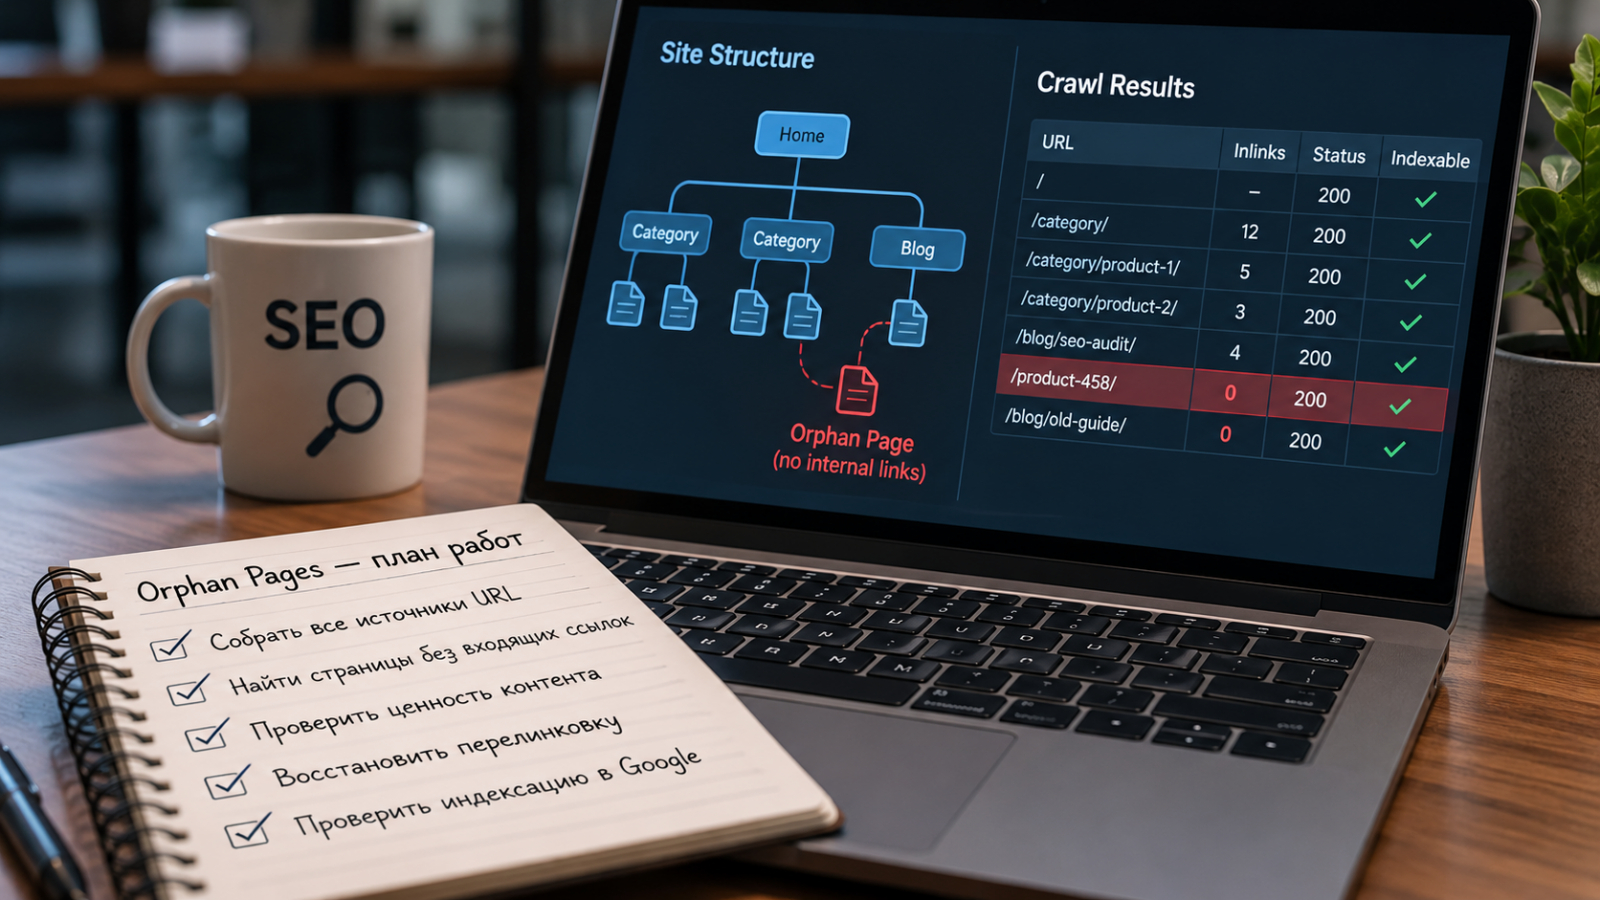
Интернет-магазин может содержать тысячи опубликованных страниц, исправно отдавать HTTP 200 и иметь актуальную XML Sitemap. Но часть товаров и статей при этом оказывается практически изолированной от остального сайта. Проблема называется Orphan Pages — страницы-сироты. Это URL, на которые не ведёт ни одна внутренняя ссылка с других страниц ресурса.
Для бизнеса это не просто техническая недоработка. Важные товарные карточки и информационные материалы могут терять возможности для обнаружения поисковыми роботами, получать меньше внутренних ссылочных сигналов и оставаться вне органического поиска. Разберём проблему на условном примере интернет-магазина строительных материалов. Примечание: проект, исходные данные, цифры и результаты в этом материале смоделированы автором для демонстрации методики. Они не относятся к реальному клиентскому проекту.
С чего начинается проблема?
Представим интернет-магазин с каталогом примерно на 12 000 URL. За несколько лет сайт пережил несколько изменений структуры, обновление каталога и перенос части материалов на новую CMS. После этих изменений обнаружилась интересная ситуация: некоторые страницы продолжали открываться по прямым адресам, но найти их через обычную навигацию сайта было невозможно. Часть товаров исчезла из категорий, некоторые статьи потеряли ссылки из тематических разделов, а отдельные посадочные страницы остались после рекламных кампаний. При этом URL продолжали возвращать HTTP 200. Некоторые находились в XML Sitemap, а другие были известны Google из предыдущих обходов.
Само по себе отсутствие внутренних ссылок не запрещает Google индексировать страницу. Поисковая система может обнаружить её через sitemap или внешние ссылки. Но страница без внутренних связей выпадает из нормальной архитектуры сайта.
Как искали потерянные страницы
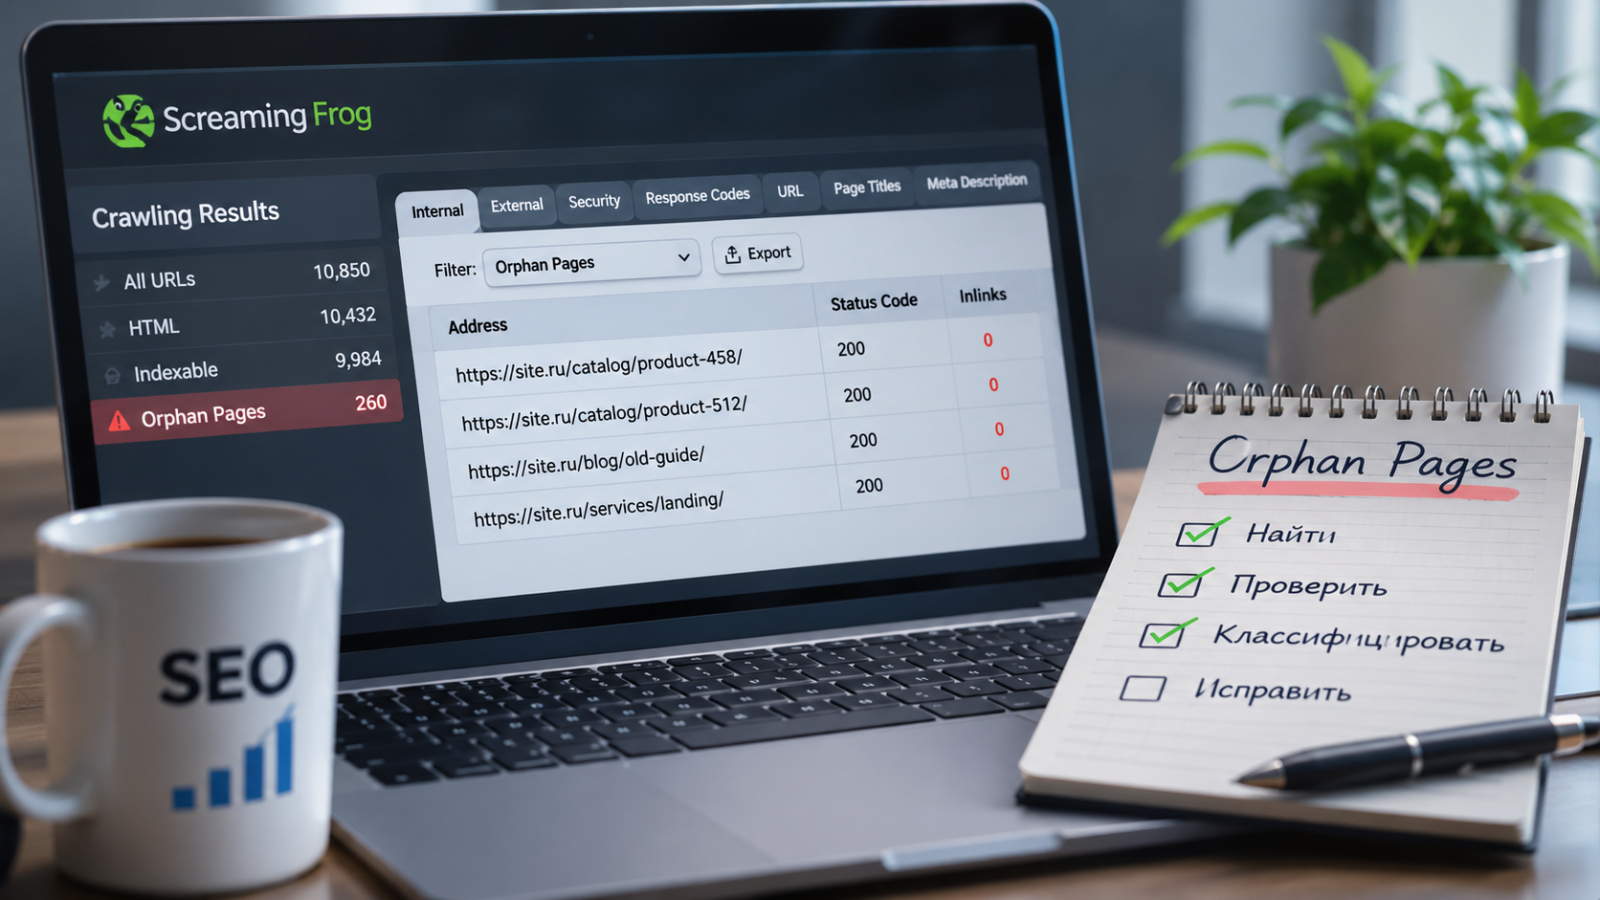
Первым этапом стал обычный краулинг сайта. С помощью Screaming Frog был получен список URL, доступных через внутренние ссылки. Однако использовать только результаты этого обхода было бы ошибкой: краулер не может самостоятельно обнаружить адрес, до которого нет ссылочного пути.
Поэтому список расширили за счёт дополнительных источников:
- XML Sitemap — адреса, заявленные сайтом для поисковых систем;
- Google Search Console — URL, известные Google;
- Google Analytics 4 — страницы, на которые приходили пользователи;
- серверные логи — адреса, которые запрашивали поисковые роботы;
- CMS — полный список опубликованных материалов и товаров.
Затем все данные объединили, нормализовали URL и удалили дубли.
Основная логика поиска выглядела следующим образом: URL из дополнительных источников минус URL, обнаруженные обычным краулингом = кандидаты на страницы-сироты.
Это ещё не окончательный список проблем. Каждый адрес необходимо проверить отдельно: возможно, он является редиректом, техническим дублем или страницей, которая изначально не должна участвовать в органическом поиске.
Почему нельзя просто добавить ссылки на все URL
На этом этапе начинается наиболее важная часть технического аудита — классификация. Для найденных адресов определили четыре основных сценария.
1. Полезные страницы, которые нужно вернуть в структуру.
Например, действующие карточки товаров с характеристиками, фотографиями и актуальным предложением. Для них восстановили ссылки из соответствующих категорий и тематических подборок.
2. Дублирующие материалы.
Если несколько URL содержали практически одинаковую информацию, определяли основную страницу, объединяли полезный контент и настраивали релевантные 301-редиректы.
3. Устаревшие страницы.
Снятые с продажи товары и старые посадочные страницы проверяли на наличие трафика, внешних ссылок и равноценной замены. В зависимости от результата использовали удаление с ответом 404 или 410 либо перенаправление на релевантный URL.
4. Страницы, которые не должны индексироваться.
Отдельные рекламные посадочные страницы сохраняли для пользователей, но исключали из органического поиска с помощью подходящих технических директив.
Таким образом, вместо массового добавления ссылок получили отдельный план действий для каждой группы URL.
Как восстанавливали внутреннюю архитектуру
Для ценных страниц использовали несколько типов внутренних связей:
- ссылки из соответствующих категорий и подкатегорий;
- контекстные ссылки из тематических статей;
- хлебные крошки;
- блоки сопутствующих товаров и материалов;
- ссылки из навигационных разделов.
Приоритет отдавали страницам, которые имели самостоятельную ценность, соответствовали реальным поисковым запросам и могли быть полезны покупателям. Например, карточку строительного материала возвращали в подходящую категорию, а информационную статью о выборе этого материала связывали с другими тематическими руководствами. Цель состояла не в том, чтобы увеличить количество внутренних ссылок любой ценой, а в том, чтобы восстановить логичные маршруты между связанными документами.
После внесения изменений провели повторный краулинг, проверили HTTP-ответы, canonical, robots directives и количество входящих внутренних ссылок. Для приоритетных URL дополнительно использовали Google Search Console и анализ серверных логов.
Что стоит контролировать владельцам сайтов
История с Orphan Pages показывает, что проблемы внутренней архитектуры могут накапливаться незаметно. Страница опубликована, сервер работает, ошибок в браузере нет — но из общей структуры сайта она уже выпала.
Чтобы не допускать повторения ситуации, полезно внедрить регулярные проверки:
- Сопоставлять XML Sitemap с результатами краулинга.
- Проверять опубликованные URL из CMS.
- Контролировать страницы без входящих внутренних ссылок.
- Проверять структуру после миграций и редизайна.
- Перед удалением категорий анализировать связанные с ними URL.
- Отслеживать страницы, которые получают органические показы или посещения, но не обнаруживаются обычным краулером.
Особенно важно проводить такую диагностику на крупных интернет-магазинах, где даже небольшие изменения каталога могут затрагивать сотни или тысячи адресов.
Главный вывод: страницы-сироты — не всегда проблема индексации в чистом виде. Часто это симптом того, что сайт постепенно теряет собственную архитектуру. Поэтому грамотная диагностика должна начинаться с объединения источников URL и оценки ценности каждой страницы, а не с массового добавления внутренних ссылок.
Автор: Александр Синов, независимый SEO-специалист. Специализация — техническая оптимизация сайтов, индексация Google и Яндекса, внутренняя архитектура и GEO.
Дополнительный технический разбор темы: Orphan Pages: как найти страницы-сироты и почему они не попадают в индекс Google.