SEO в 2026 году: сущности, онтологии, интенты и чанки. Как поиск перестал считать слова и начал понимать смыслы
Долгое время SEO было похоже на бухгалтерию: собрать семантику, посчитать вхождения, разложить ключи по посадочным страницам. Сейчас поисковики работают иначе. Они строят графы знаний, извлекают факты из текста и сами собирают ответ из фрагментов чужих страниц. В выдаче это выглядит как «Нейро» в Яндексе и AI Overviews в Google, а за её пределами как ответы ChatGPT, Perplexity и Алисы.
От ключевых слов к смыслу: короткая история сдвига
Классическое ранжирование опиралось на лексическое совпадение. Алгоритм проверял, встречается ли фраза из запроса в title, заголовках и тексте, как часто и в какой форме. Отсюда страницы с «созданием сайтов под ключ недорого» в каждом втором абзаце: при такой модели это работало.
Перелом шёл постепенно. В 2012 году Google запустил Knowledge Graph и начал думать «вещами, а не строками» (things, not strings). Яндекс в 2016 году выпустил «Палех», который сопоставлял смысл запроса с заголовками страниц через нейросетевые векторы. «Королёв» в 2017 году распространил этот подход на весь текст документа. В 2019 году Google внедрил BERT, двунаправленную трансформерную модель, которая читает слово с учётом контекста слева и справа. В 2020 году Яндекс показал трансформерную модель YATI и обновление «Вега», а Google объявил о passage ranking, то есть о ранжировании отдельных фрагментов страницы, а не документа целиком. В 2021 году появилась MUM, мультимодальная и многоязычная модель, которая, по заявлению Google, в 1000 раз мощнее BERT.
Следующим шагом стали генеративные ответы прямо в выдаче. Поисковик больше не просто показывает десять ссылок. Он разбивает запрос на подзапросы (в Google этот механизм называют query fan-out), находит релевантные фрагменты на разных сайтах и синтезирует из них ответ, ссылаясь на источники.
Ключевые слова при этом никуда не исчезли. Они перестали быть единицей оптимизации и превратились в сигнал о теме, по сути в оглавление. Единицей оптимизации стал смысл: какие объекты описаны на странице, как они связаны и на какую потребность отвечает текст.
Семь терминов, без которых сложно говорить о SEO в 2026 году
Семантическое ядро как карта тем
Раньше ядро было выгрузкой фраз из Wordstat с частотностями. Сейчас это модель информационного поля аудитории: какие у неё вопросы, на каком этапе пути клиента они возникают, какие смежные темы её беспокоят. Для психолога ядро не заканчивается на запросе «психолог тревожность цена». В него входят вопросы о том, как отличить тревогу от тревожного расстройства, чем КПТ отличается от гештальт-терапии, сколько длится курс. Рабочее ядро сегодня отвечает на вопрос «о чём мы говорим с аудиторией», а не «какие слова вписать».
Сущности (entities)
Сущность – это однозначно идентифицируемый объект с набором свойств: человек, организация, продукт, вещество, понятие, услуга. Поисковики хранят сущности в графах знаний и сопоставляют с ними упоминания в тексте. Этот процесс называется entity linking. Сущность «банковский вклад» связана со ставкой, сроком, капитализацией и системой страхования вкладов. «Лендинг» и «интернет-магазин» в разработке сайтов – разные сущности с разным назначением и структурой.
Практический вывод такой: текст, где объекты названы однозначно и описаны через свои свойства, машина интерпретирует с высокой уверенностью. Текст из общих слов («современные решения», «индивидуальный подход») не даёт ей ни одной сущности, за которую можно зацепиться.
Таксономия
Таксономия – иерархическая классификация по принципу «род – вид», для сайта это дерево разделов. У косметологической клиники услуги делятся на инъекционные, аппаратные и уходовые, а внутри каждой ветки лежат конкретные процедуры. У студии разработки портфолио делится на лендинги, корпоративные сайты и e-commerce. Логичная таксономия облегчает краулинг, распределяет внутренний ссылочный вес и показывает поисковику, какие кластеры тем закрывает сайт.
Онтология
Онтология устроена сложнее. Таксономия описывает только отношение «является видом», а онтология – типизированные связи между сущностями: «лечится методом», «зависит от», «противопоказан при», «входит в состав».
Паническое расстройство относится к тревожным расстройствам, имеет характерную симптоматику и корректируется методами КПТ. Ставка по вкладу зависит от ключевой ставки ЦБ.
Поисковик восстанавливает такие связи из текстов сайта. Чем полнее и непротиворечивее онтология предметной области на ваших страницах, тем выше оценка тематической глубины, или topical authority. Это объясняет, почему кластер из десяти связанных статей стабильно сильнее одной «простыни» на 20 тысяч знаков.
Триплеты
Триплет – минимальная единица факта в формате «субъект – предикат – объект». Из этих единиц строятся графы знаний, на их основе работает модель данных RDF. Пример: «Ретинол – ускоряет – обновление эпидермиса». Или: «Скорость загрузки – влияет на – конверсию интернет-магазина».
Языковые модели и системы извлечения информации хорошо вычленяют из текста такие утверждения. Отсюда простой редакторский критерий: в абзаце должны быть проверяемые утверждения о конкретных объектах. Абзац из эпитетов не содержит ни одного триплета, поэтому для машины он пустой, сколько бы ключей в нём ни было.
Интенты
Интент – потребность, которая стоит за запросом. Классическая схема делит их на информационные, навигационные, коммерческие и транзакционные, но на практике важнее более тонкая градация. Человек, который ищет «крем с ретинолом», чаще всего хочет выбрать продукт, а не прочитать обзор ретиноидов. Запрос «психолог или психотерапевт, к кому идти» говорит о том, что человек растерян и ему нужен навигатор, а не определения из справочника.
Современные модели ранжирования оценивают, насколько страница закрывает интент, а поведенческие сигналы это подтверждают или опровергают. Страница, точно попадающая в намерение, может обойти конкурента, у которого лексическое совпадение выше.
Чанки
Чанк (chunk) – фрагмент текста, который система поиска индексирует и извлекает как отдельную единицу. Генеративный поиск устроен по принципу RAG (retrieval-augmented generation): документы режутся на фрагменты, фрагменты превращаются в векторные представления (эмбеддинги), и под конкретный подзапрос извлекаются самые близкие по смыслу куски. Из них модель собирает ответ.
Отсюда требование к абзацу: он должен быть самодостаточным. Сущность названа прямо, а не через «он» или «этот метод», дано определение или утверждение, есть короткий пример или цифра. Такой фрагмент можно извлечь без контекста, и он не потеряет смысл. Мысль, растянутая на полэкрана с отсылками «как мы писали выше», при извлечении ломается и в ответ не попадает.
SEO, AEO и GEO: в чём разница
Эти три аббревиатуры часто используют как синонимы, хотя у них разные цели и разные метрики.
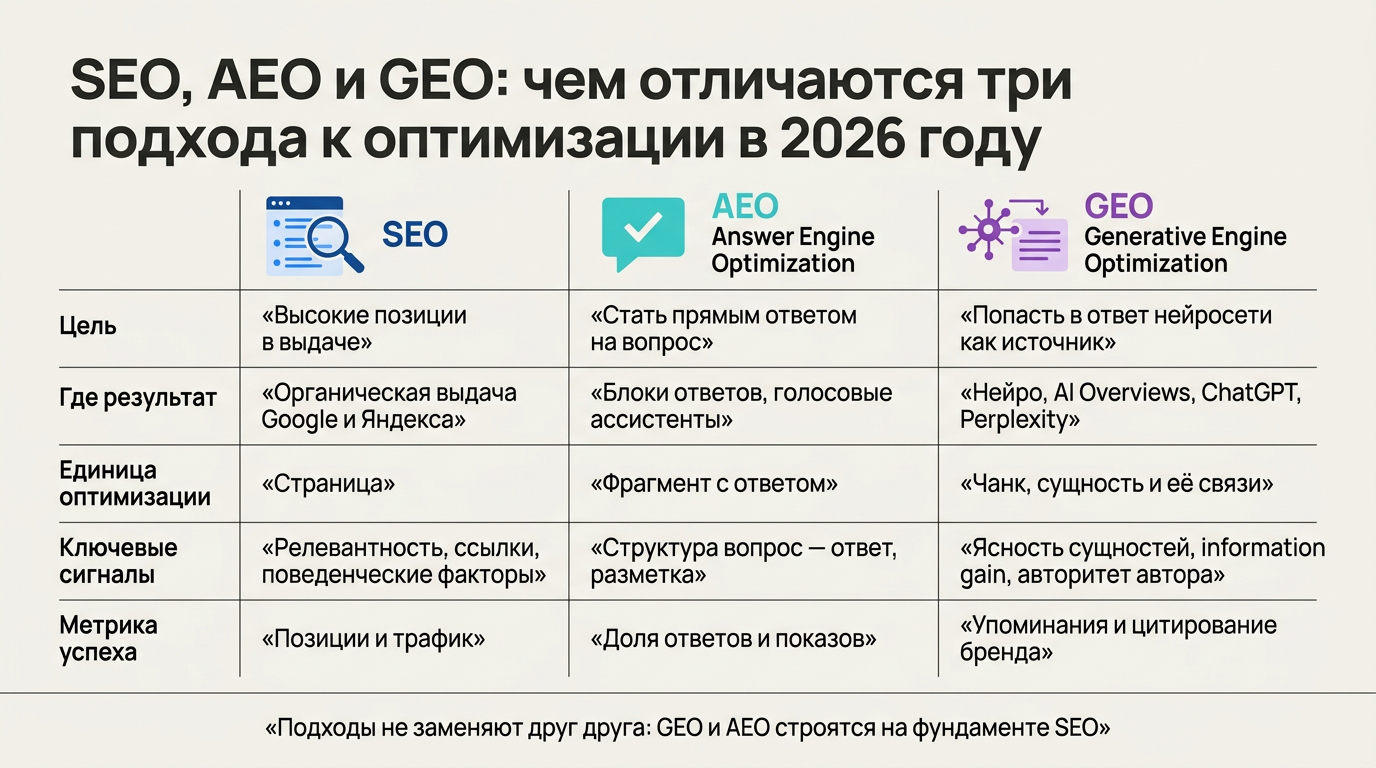
Это не три отдельные дисциплины, а три слоя одной работы. Для GEO не нужен «особый» контент: нужен контент, который хорошо структурирован семантически, содержит проверяемые факты и подкреплён авторитетом автора и бренда за пределами сайта.
Экспертность как фактор ранжирования
Модель E-E-A-T (Experience, Expertise, Authoritativeness, Trust) пришла из руководства Google для асессоров, но сама логика актуальна для обеих поисковых систем. Для тем YMYL (Your Money or Your Life), то есть здоровья, финансов, права и безопасности, требования к источнику строже. Психология и финансы лежат прямо в этой зоне, косметология находится на границе.
С точки зрения сущностей автор тоже сущность. Профиль с образованием, практикой, публикациями на внешних площадках и единообразным упоминанием в сети делает автора узнаваемым объектом графа. Его тексты получают больше доверия. Разметка Schema.org (Person, Organization, Article, author, sameAs) помогает связать эти сигналы, но работает только когда есть реальная репутация, которую можно связать.
Дальше включаются глубина раскрытия, ссылки на первоисточники и поведенческие факторы: дочитываемость, время на странице, возвраты. Документов о квалификации поисковик не запрашивает, но выводы делает по совокупности косвенных сигналов.
Ранжируются ли тексты, написанные нейросетями
Ранжируются, и это стоит признать без паники. Ни Google, ни Яндекс не наказывают текст за сам факт генерации. Оценивается полезность. В выдаче лидирующие позиции могут занимать материалы, где модель помогла со структурой и черновиком, а эксперт добавил собственную практику: данные из проектов, кейсы, проверенные факты, позицию.
Массовая генерация без редактуры проигрывает по понятной причине: она воспроизводит усреднённое знание, которое уже есть в обучающей выборке. В терминах GEO такой текст не несёт новой информации (information gain), и генеративной системе незачем его цитировать, ведь то же самое она может сказать сама. Цитируют источники, где есть то, чего у модели нет: оригинальные данные, наблюдения из практики, точные формулировки, новые связи между сущностями.
Что это значит для экспертного сайта
Сайт из страницы «О нас» и трёх услуг не даёт поисковику материала для оценки тематической глубины. Блог решает эту задачу системно: каждая статья добавляет в граф сайта новые сущности и связи, расширяет покрытие интентов, создаёт точки входа для внутренней перелинковки на коммерческие страницы и регулярно обновляет сигнал свежести.
Рабочий чек-лист для редакции:
- Планировать контент кластерами вокруг сущностей и интентов, а не вокруг отдельных ключей.
- В каждом материале явно называть ключевые сущности и описывать их через свойства и связи.
- Писать абзацами-чанками: один абзац, одна мысль, сущность названа прямо, есть факт или пример.
- Использовать подзаголовки в формате вопросов, которые реально задаёт аудитория, и отвечать на них в первом же предложении раздела.
- Добавлять то, чего нет у конкурентов и модели: собственные данные, кейсы с цифрами «до и после», экспертную позицию.
- Делать авторство видимым: профиль автора, разметка, публикации на внешних площадках.
- Отслеживать не только позиции, но и упоминания бренда в ответах «Нейро», AI Overviews и ИИ-ассистентов.
Регулярность здесь важнее объёма. Одна содержательная статья в месяц, написанная экспертом на основе практики, даёт больше, чем десять сгенерированных заметок «для отчёта».
Заключение
Если отбросить терминологию, требования поиска в 2026 году сводятся к трём вещам. Нужно называть объекты своими именами и описывать связи между ними, точно отвечать на реальную потребность читателя и приносить в текст знание, которого нет в других источниках. Алгоритмы научились отличать такие тексты от имитации, и маркетологам выгоднее инвестировать в смысл, чем в плотность ключей.