Разработка — самая дорогая статья расходов: как управлять ею не вслепую
Фонд оплаты труда команды разработчиков — весомая строка бюджета продуктовой компании, а решения о том, на что он потрачен, нередко принимаются по громкости голоса. Разбираем систему: прозрачное правило отбора задач, метрики-посредники между функциями и выручкой, лимит на срочное.
Каждое место в спринте стоит компании денег — буквально это и есть зарплата разработчиков. Но спросите продуктовые команды, как задача попала в текущий план. Частый ответ: ее автор убедительнее остальных попросил. Я управляю разработкой Аспро.Cloud, и мы перестроили отбор задач так, что решение объясняется цифрой, а не настойчивостью. Разберем конструкцию по частям — от оценок до внеплановых заявок.
Почему побеждает настойчивый, а не важное
Типичная картина планирования: продакт приносит идеи из клиентских встреч, менеджер — функцию ради контракта на подписи, разработчики — рефакторинг с долгой историей. Каждая позиция обоснованна, ресурс один. Бэклог SaaS-продукта питают пять-шесть источников — от продукта и продаж до поддержки, маркетинга, клиентов и самой команды, — и у каждого — собственный критерий истины: сделка, метрика, чистый код. Без общей меры планирование — перетягивание каната, и выигрывает самый напористый.
Общей мерой стал скоринг RICE по четырем критериям: охват, влияние, уверенность в прогнозе, трудозатраты. Произведение первых трех, поделенное на четвертую, дает балл; в работу отправляются записи с его наибольшими значениями. Ценность не в арифметике, а в смене типа спора. Вместо «моя задача важнее» команда обсуждает цифры: за что влиянию тройка вместо пятерки, что стоит за уверенностью в восемьдесят процентов, охват — половина пользователей или лишь десятая доля. Подобный спор завершается решением, а не позиционной войной.
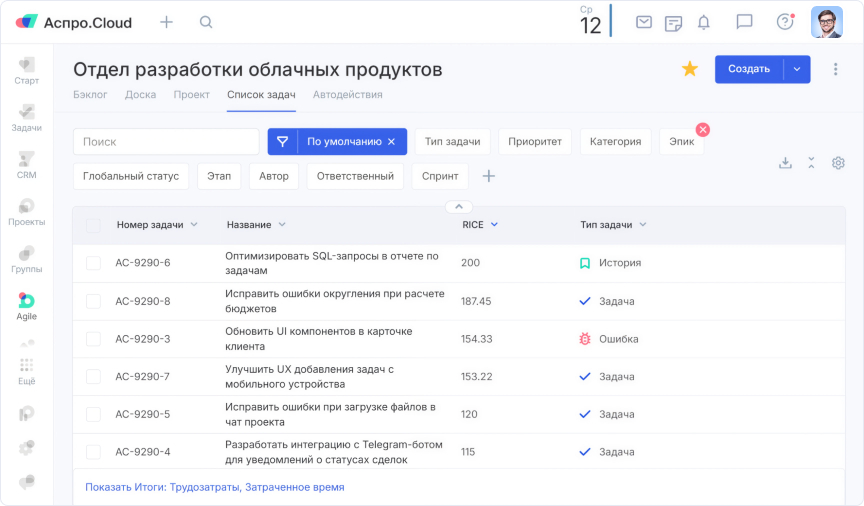
Для руководителя здесь три управленческих условия. Цифры выставляются коллективно и вслух — молчаливая единоличная оценка выражает позицию самого шумного и выхолащивает механизм. Шкалы сознательно грубые: влияние измеряется единицей, тройкой или пятеркой, уверенность — пятьюдесятью, восемьюдесятью и ста процентами; детальная шкала рисует ложную точность и умножает дискуссии. И решение сверху остается, но в статусе исключения: пока прямых распоряжений меньше десятой доли, система дышит. Если словом назначается половина работы — приоритизирует руководитель, а балл декорация.
Ожидаемые сбои, к которым надо готовиться: авторы переоценивают эффект своих идей — лечится публичностью: приукрасить в лицо коллегам труднее, чем в безликий опросник; первый месяц-два команду тянет к старому способу — вера в цифры приходит со временем; оценки без пересмотра ветшают вместе с контекстом.
Метрика вместо движения на ощупь
У скоринга есть слепое поле: балл выстраивает заявки по ценности относительно друг друга, но не отвечает, куда движется продукт. Можно кварталами наполнять спринты улучшениями с высоким баллом — и год простоять при полной загрузке. Когда бэклог разрастается до тысяч записей, влияние превращается в лотерею: у заявок из разных отделов нет единой линейки.
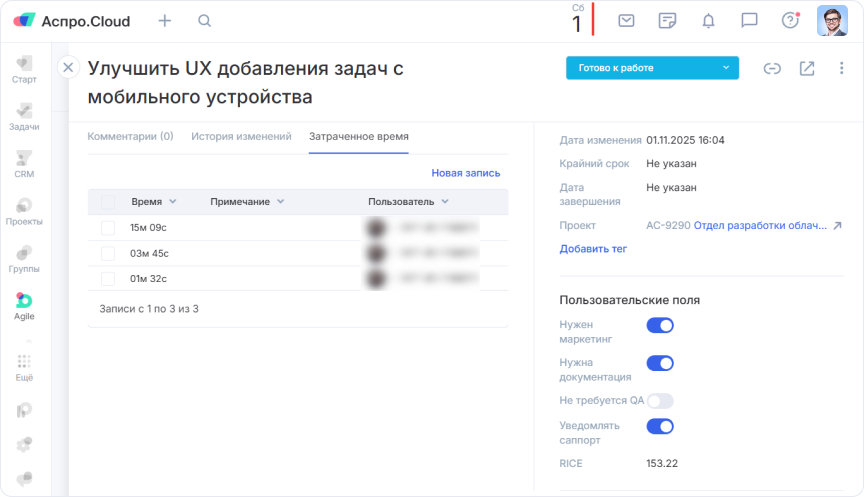
Ответ — продуктовые треки. Трек — рабочее направление с одним закрепленным показателем; вокруг него прямо в общей очереди образуется набор задач-гипотез. Наш рабочий пример — активация новичков: показатель — часть новых пользователей, создающих первый проект в первые семь дней после регистрации. В набор входят: предложение создать проект из готового шаблона на старте, внутренние подсказки, ведущие к первому результату, письмо-напоминание на вторые сутки без первого шага, перестройка первого шага — меньше кликов до появления первого проекта.
Идеи из набора оцениваются наравне со всеми — автоматической дороги в план не существует. К каждой приписываются точка отсчета и ожидаемый прирост, после чего спор о влиянии опирается на цифры, как и спор о трудозатратах. Управленческий смысл — в дисциплине после релиза: рост показателя усиливаем, отсутствие роста записываем и освобождаем следующий спринт от этого рычага. Без треков опыт испаряется: релиз состоялся, команда переключилась, и месяц спустя никто не скажет, что обещала функция. Треки превращают каждую проверку в строчку базы знаний о продукте.
Условия честности: показатель обязан двигаться от действий команды — если его качают маркетинговый бюджет или сезонность, показаниям верить нельзя; набор из единственной гипотезы — иллюзия трека, нужны хотя бы четыре-пять вариантов; и без зафиксированной точки отсчета после релиза нечего сравнивать — все превращается в формальность.
Связка с выручкой: где она возможна
Гендиректору нужен ответ на прямой вопрос: сколько принесла конкретная функция? В крупном продукте соединить функцию с выручкой напрямую не выходит: тысячи клиентов, десятки модулей, тариф оплачивается целиком. Клиент продлил подписку — и непонятно, кого благодарить: подсказки, менеджера, отчет или конкурента, поднявшего цены. Разнести продление по причинам невозможно. И все же махнуть рукой на связь с деньгами — все равно что рулить самой весомой статьей расходов с завязанными глазами.
Рабочая схема — цепочка «фича — метрика — деньги». Активация напрямую выручки не дает, зато пользователи с высокой активностью продлеваются охотнее и живут дольше, и это видно в цифрах. К метрике-посреднику три требования: от показателя до выручки — максимум пара звеньев; реакция проявляется за неделю-две после выхода; показатель подвластен команде, а не внешним факторам.
Прямой замер возможен для функции, продаваемой отдельно: покупатели действуют осознанно, у функции свой прайс и своя статистика — рано или поздно расходы на разработку уравниваются с выручкой в отчете. Таких функций у нас две: «Зарплата» и «Складской учет». Для управляющей команды они служат калибровочной линейкой: точность прогноза по платной функции подсказывает, сколько доверия заслуживают оценки по остальным задачам.
Срочное — управленческая проблема, а не техническая
Незапланированные заявки — отдельный класс: в наших спринтах до трети мощности, как правило меньше. Причин две: обращение клиента, которому не пересидеть до следующего планирования, и инциденты — инфраструктура или безопасность. Работа под конкретную сделку сюда не относится: это плановая заявка, она проходит оценку и конкурирует с остальными на равных.
В учете внеплановая работа выглядит ничего не стоящей — часы сопоставимые. Реальный счет больше: заявка останавливает постановщика, исполнителя и тестировщика, оценка в два часа на деле съедает день у троих, а вдобавок выпадает запланированная задача, в которую тоже вложили разбор. Базовые Cycle Time и Lead Time делают эту цену видимой.
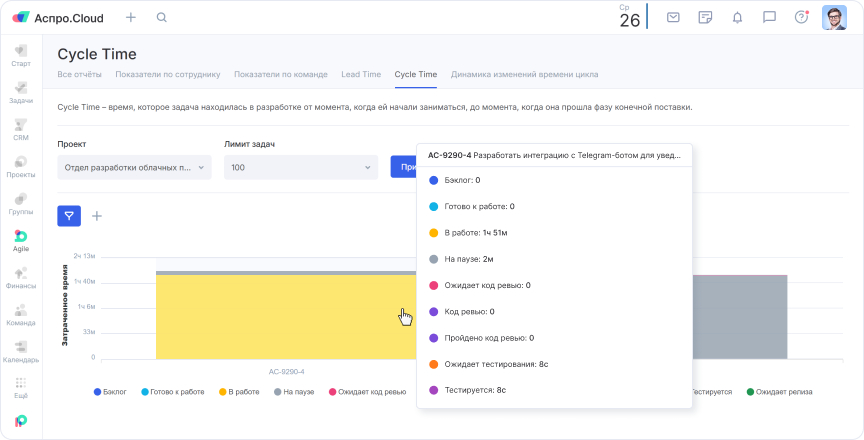
Управленческий контур из трех решений. Один канал: срочное заходит в спринт через единый вход с арбитром — личное сообщение разработчику еще не задача, им оно становится только после канала. Объявленный лимит: определенный процент мощности резервируется под незапланированное по измеренной доле — пока лимит не зафиксирован, его раздает очередной сбой, и побеждает тот, кто громче настаивает. И вопрос о цене выбора: исключить внеплановые заявки нельзя, обращения никуда не исчезнут, зато у каждого просителя можно уточнить, что не будет сделано взамен. С этим вопросом половина срочного рассыпается.
С чего начать: регламент на четыре шага
1. Измерить долю внепланового. Расчет: суммарные часы по незапланированным заявкам, отнесенные к общей мощности спринта. Снимите значение на трех-четырех итерациях — получится собственная цифра, у нас около трети.
2. Ввести общий скоринг. Каждая заявка в очереди оценивается по четырем критериям — охват, влияние, уверенность, трудозатраты — и получает автора. Разбор коллективный и вслух, шкалы грубые.
3. Привязать гипотезы к показателям. Для каждого направления фиксируются метрика, точка отсчета и ожидаемый прирост; после релиза — проверка и запись результата в базу знаний.
4. Назначить окно для срочного. Единый канал с арбитром, лимит мощности под незаплановое и обязательный вопрос о цене выбора каждой внеплановой заявке.
Сама формула выбирается за вечер. Конструкция очереди собирается дольше: у каждой заявки — балл и владелец, у гипотезы — показатель и пост-релизная проверка, у срочного — лимит и один канал, а запросы от продаж связаны с контрактами и просматриваются на горизонт квартала. Эту логику новый сотрудник осваивает за пять минут. И место в спринте — деньги компании: выигрывать его задача должна по правилу, а не по напору автора.