Что такое токены в нейросетях простыми словами, чем они отличаются от слов и как посчитать размер текста
Алгоритм, которым сегодня режут текст для ChatGPT, придумали в 1994 году, чтобы сжимать файлы. Его автор вряд ли догадывался, что однажды этот алгоритм станет «глазами» нейросетей.
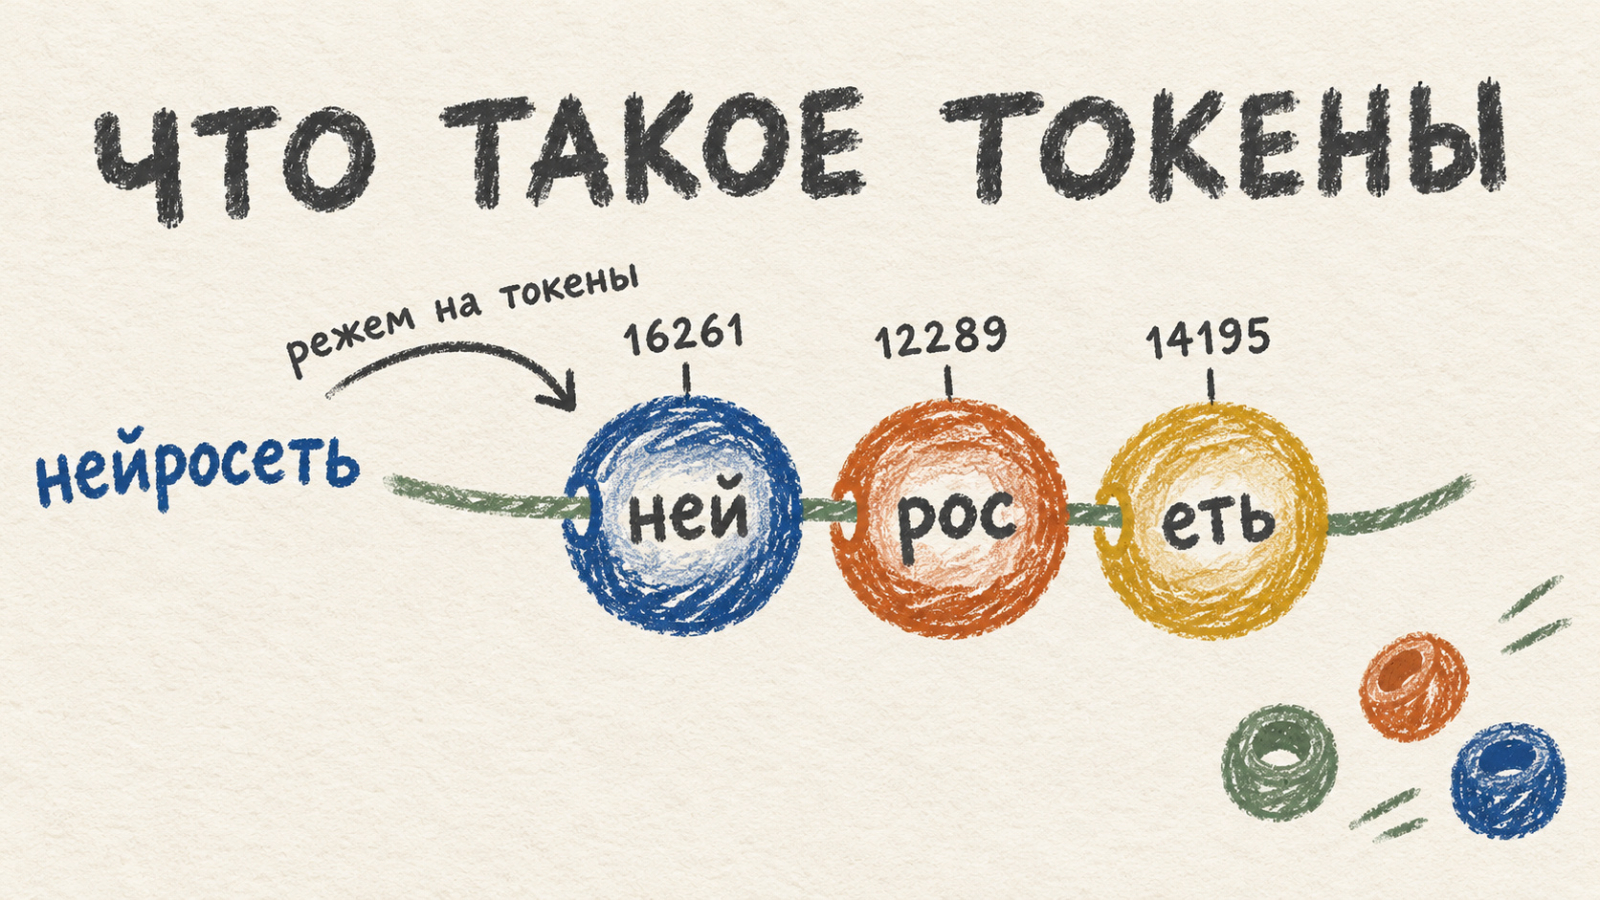
Токены в нейросети – это кусочки текста, на которые языковая модель режет всё, что читает и пишет: целое слово, его часть, пробел, запятую или эмодзи. У каждого кусочка есть номер в словаре модели, и дальше нейросеть работает только с цепочкой чисел. В токенах измеряют, сколько текста влезет в запрос, сколько модель удержит в памяти чата и сколько стоит работа через API.
Механика тут простая, и, разобравшись в ней один раз, вы начнёте получать ответы точнее и дешевле.
«Привет» в разобранном виде
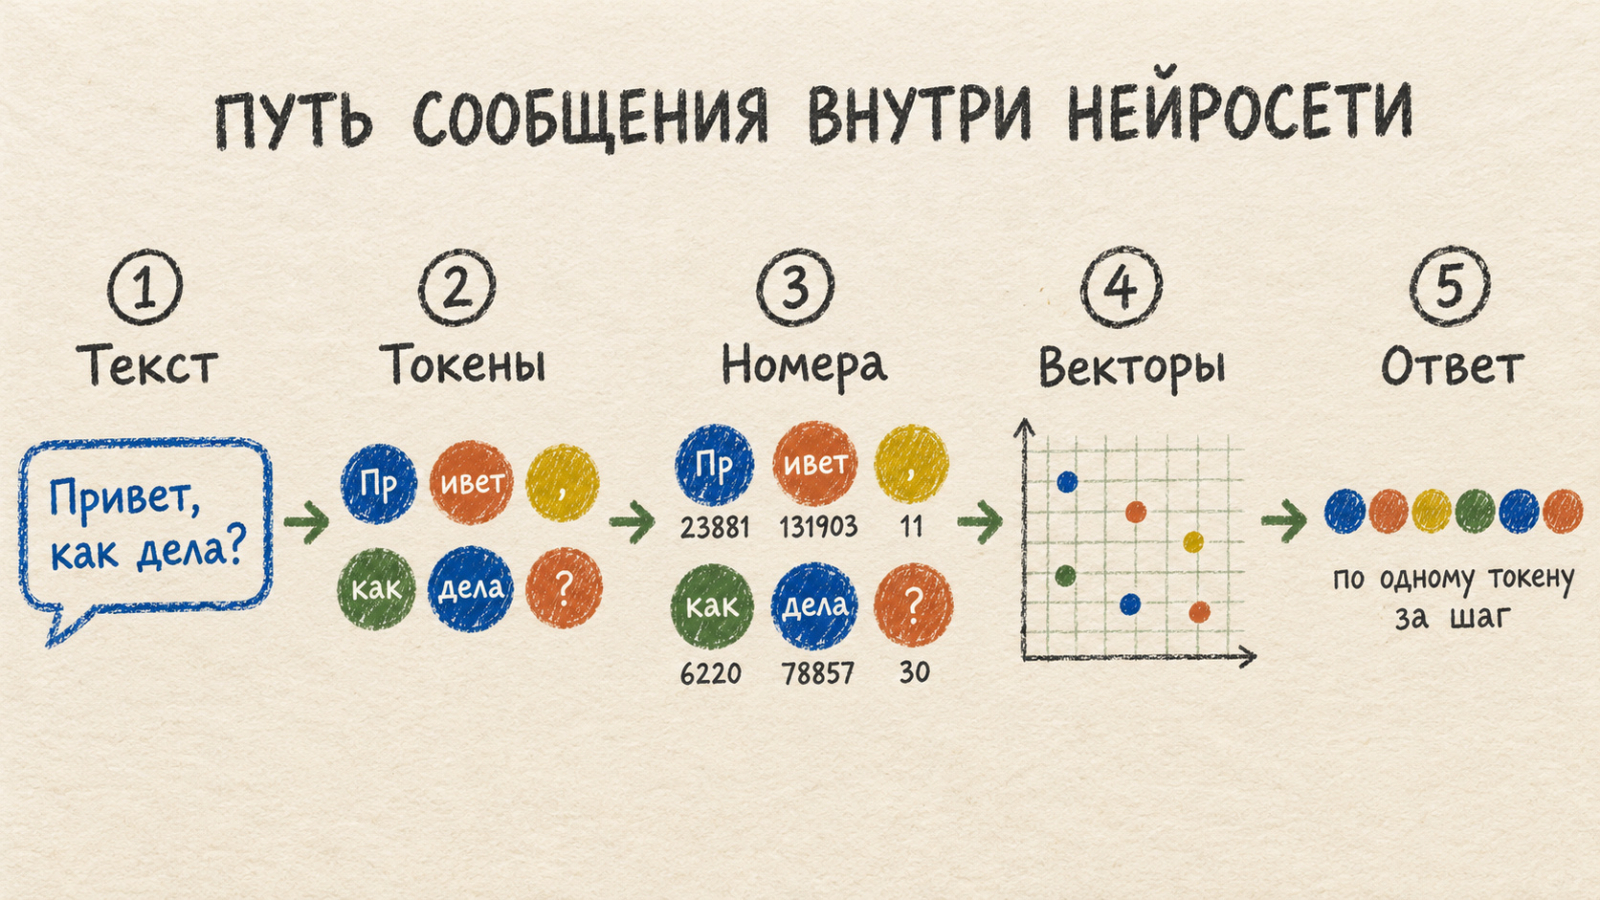
Компьютер понятия не имеет, что такое буква «П»: он умеет только перемножать числа, зато триллионы раз в секунду. Поэтому вопрос сначала разбирает отдельная программа – токенизатор:
- Текст → токены. В GPT-4o «Привет, как дела?» превращается в шесть кусочков: «Пр», «ивет», «,», « как», « дела», «?». Пробел прилипает к следующему слову, а «Привет» разрезано пополам.
- Токены → номера. У каждого кусочка свой ID: например, « дела» – это 78857.
- Номера → векторы. Номер заменяется набором чисел-координат, и близкие по смыслу кусочки оказываются рядом.
- Векторы → следующий токен. Модель смотрит на всю цепочку и угадывает следующий кусочек, потом ещё один. Любой ответ чат-бота собран так, по токену за шаг.
Почему не целые слова? Словоформ в русском бездна, и каждая просилась бы в словарь отдельно. А по буквам цепочка раздулась бы в разы. Компромисс – именно токены: частые слова хранятся целиком, редкие собираются из запчастей. Поэтому даже вчерашний неологизм «нейромаркетплейс» разберётся на знакомые детали.
Режет текст чаще всего алгоритм BPE (Byte Pair Encoding). Его придумал в 1994 году программист Филип Гейдж – для сжатия файлов. В 2015-м исследователи из Эдинбургского университета приспособили его для машинного перевода, а оттуда он переехал в GPT. Принцип такой: разбиваем гору текстов на символы, находим самую частую пару соседей, склеиваем её в новый токен и повторяем десятки тысяч раз.
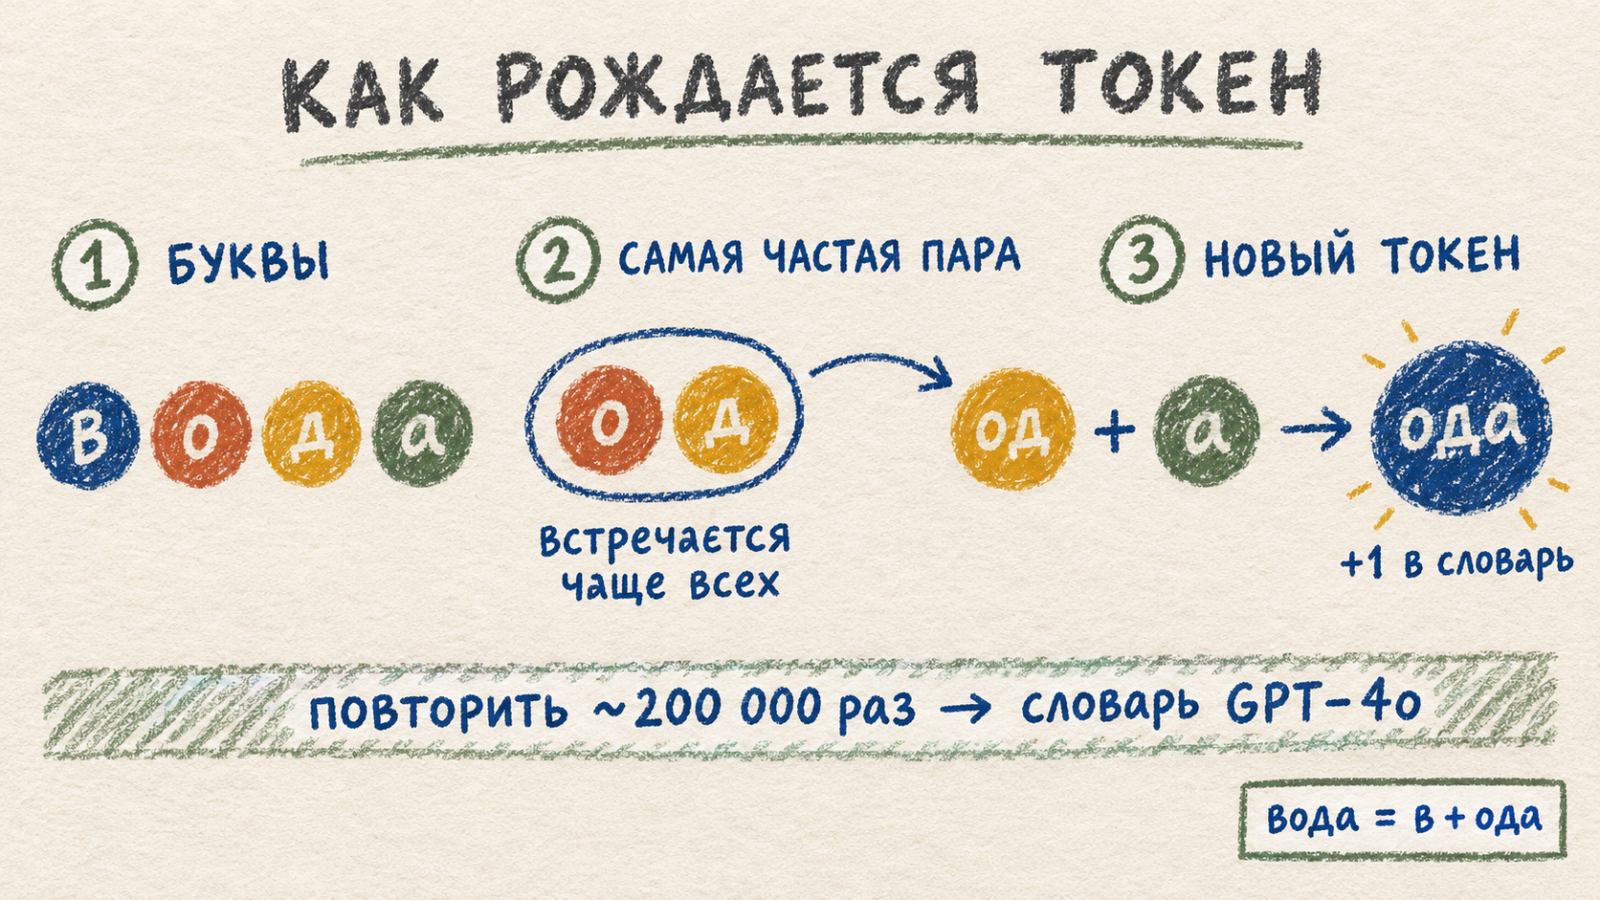
Словари с годами разрастались: у GPT-2 в 2019-м было 50257 токенов, у GPT-4 – около 100 тысяч, у GPT-4o и более новых моделей OpenAI – около 200 тысяч. Чем больше словарь, тем крупнее «бусины» и короче цепочка для того же текста.
А как режется ваш собственный текст, видно в бесплатном OpenAI Tokenizer: каждый токен там подсвечивается своим цветом.
Русский тяжелее. Но уже не так, как вы думаете
По правилу самой OpenAI, один токен – это примерно 4 символа английского текста, или три четверти слова. Для русского годами повторяли «слово – два-три токена». Я прогнал один и тот же абзац на 550 знаков, по-английски и в русском переводе, через три поколения токенизаторов OpenAI:
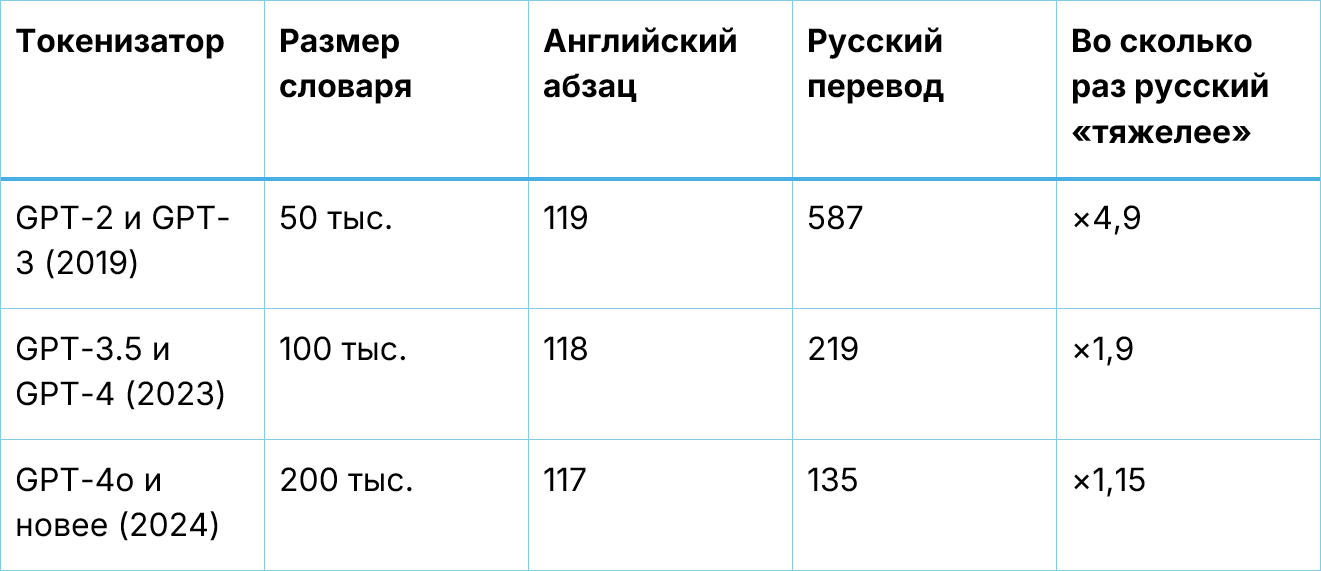
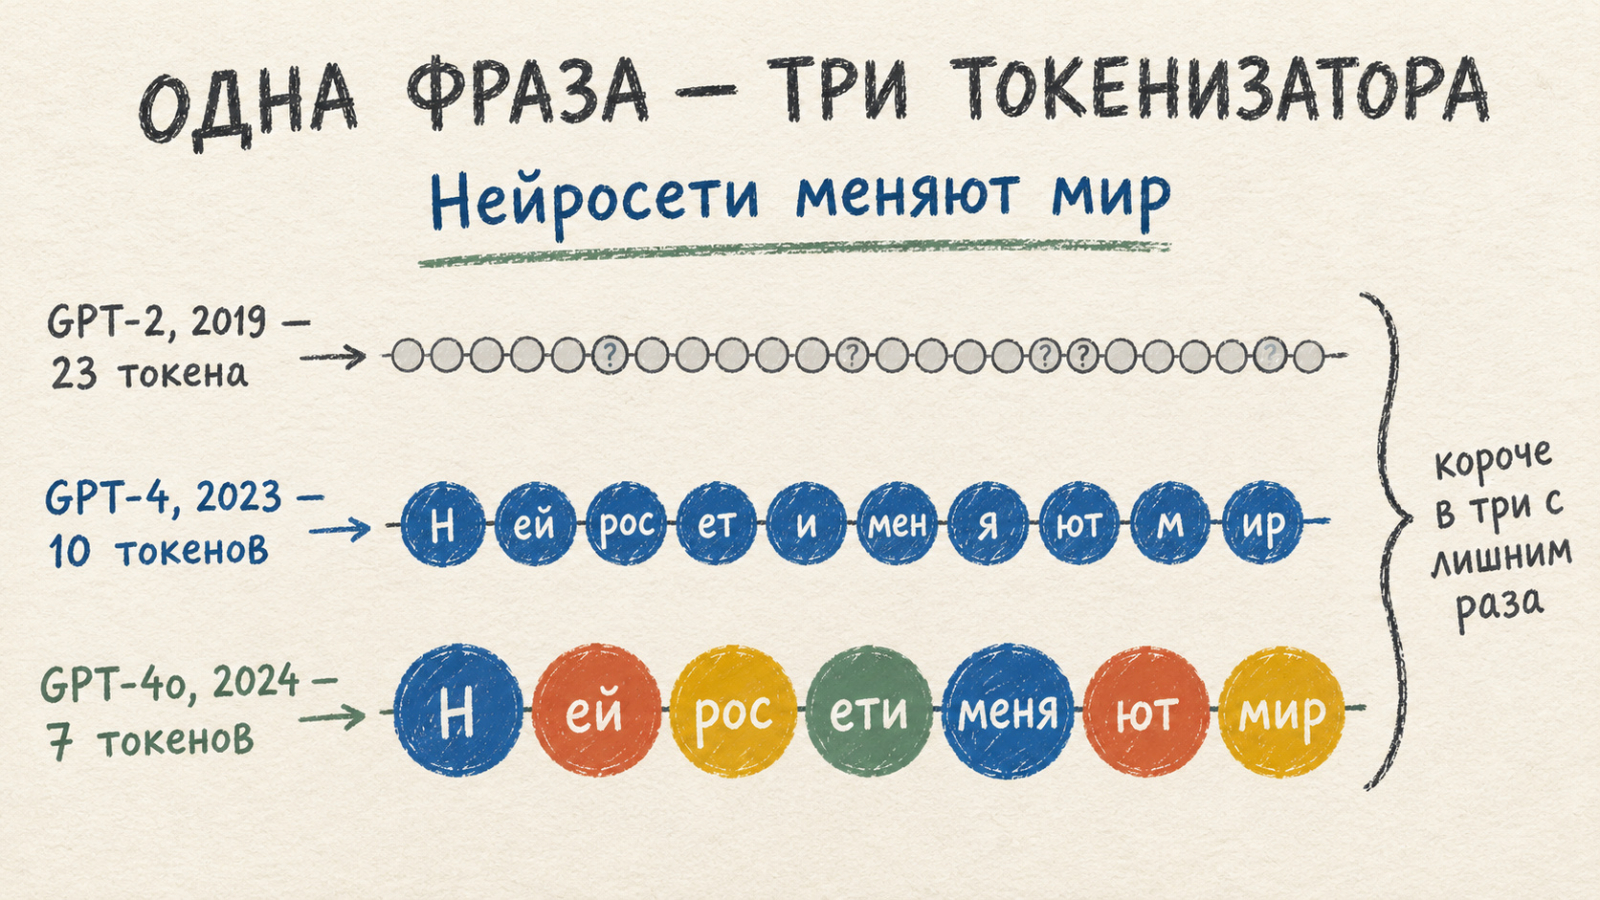
В эпоху GPT-2 кириллицу резали на байты: фраза «Нейросети меняют мир» весила 23 токена, в GPT-4 – уже 10, в GPT-4o – 7. Правило «два-три токена на слово» честно описывает 2023 год, а в свежих моделях OpenAI выходит около 1,6.
Русский тяжелее английского по трём причинам:
- словари строили в основном на англоязычных текстах
- кириллическая буква в UTF-8 занимает два байта вместо одного
- а приставки и окончания удлиняют слова
В 2023-м для некоторых языков одинаковый по смыслу текст требовал до 15 раз больше токенов, чем английский.
Модели при этом сильно различаются. Вот небольшой независимый тест 2026 года:
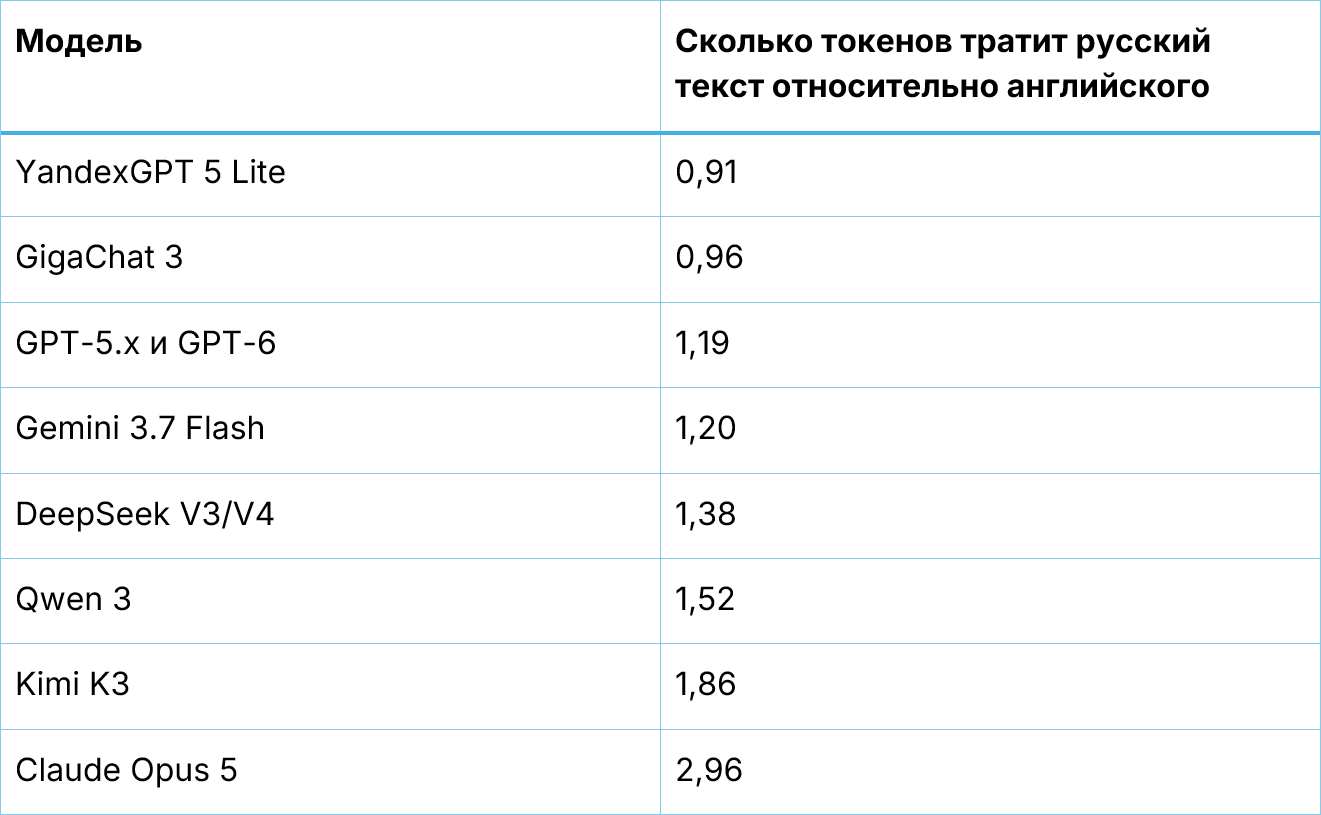
Отечественные YandexGPT и GigaChat тратят на русский даже меньше, чем на английский: их словари собирали на русском инете. На другом полюсе Claude: с версии Opus 4.7 Anthropic перешла на новый токенизатор, который тратит на тот же текст до 1,35 раза больше токенов.
Практический вывод. Длинные системные инструкции для бота выгодно писать по-английски, попросив отвечать по-русски. Для обычной переписки выигрыш копеечный – к тому же оттенки формулировок при переводе теряются.
Клубника, «проклятые» токены и другие фокусы
Помните мем? Нейросеть спрашивали, сколько букв «r» в слове strawberry, и она уверенно отвечала «две». Для GPT-4o это слово – три бусины: «st», «raw», «berry». Отдельных букв модель не видит. По-русски так же: «клубника» – это «к», «луб», «ника». Отсюда ошибки в анаграммах, рифмах и арифметике: числа режутся кусками до трёх цифр, и 2249 превращается в «224» и «9».
Рассуждающие модели обходят ловушку, сначала выписывая слово по буквам. Забавно, что проект таких моделей в OpenAI назывался Strawberry. Совет простой: для задач про буквы просите разложить слово по символам, для вычислений – посчитать с помощью кода.
А в 2023 году нашлись настоящие «проклятые» токены. Строка « SolidGoldMagikarp» в словаре GPT-2 и GPT-3 была одним токеном под номером 43453 – ником пользователя Reddit из сообщества, где годами считают до бесконечности. В текстах, на которых строили словарь, таких ников было полно, а в обучении самой модели они почти не встречались. На просьбу повторить это «слово» модель выдавала что-то вроде «distribute». Феномен назвали глитч-токенами, а в GPT-4 эту строку режут уже на пять обычных кусочков.
Контекстное окно
Контекстное окно – это максимальное число токенов, которое модель обрабатывает за один вызов. В него входит всё сразу: служебные инструкции сервиса, история переписки, файлы, ваш новый вопрос и будущий ответ.
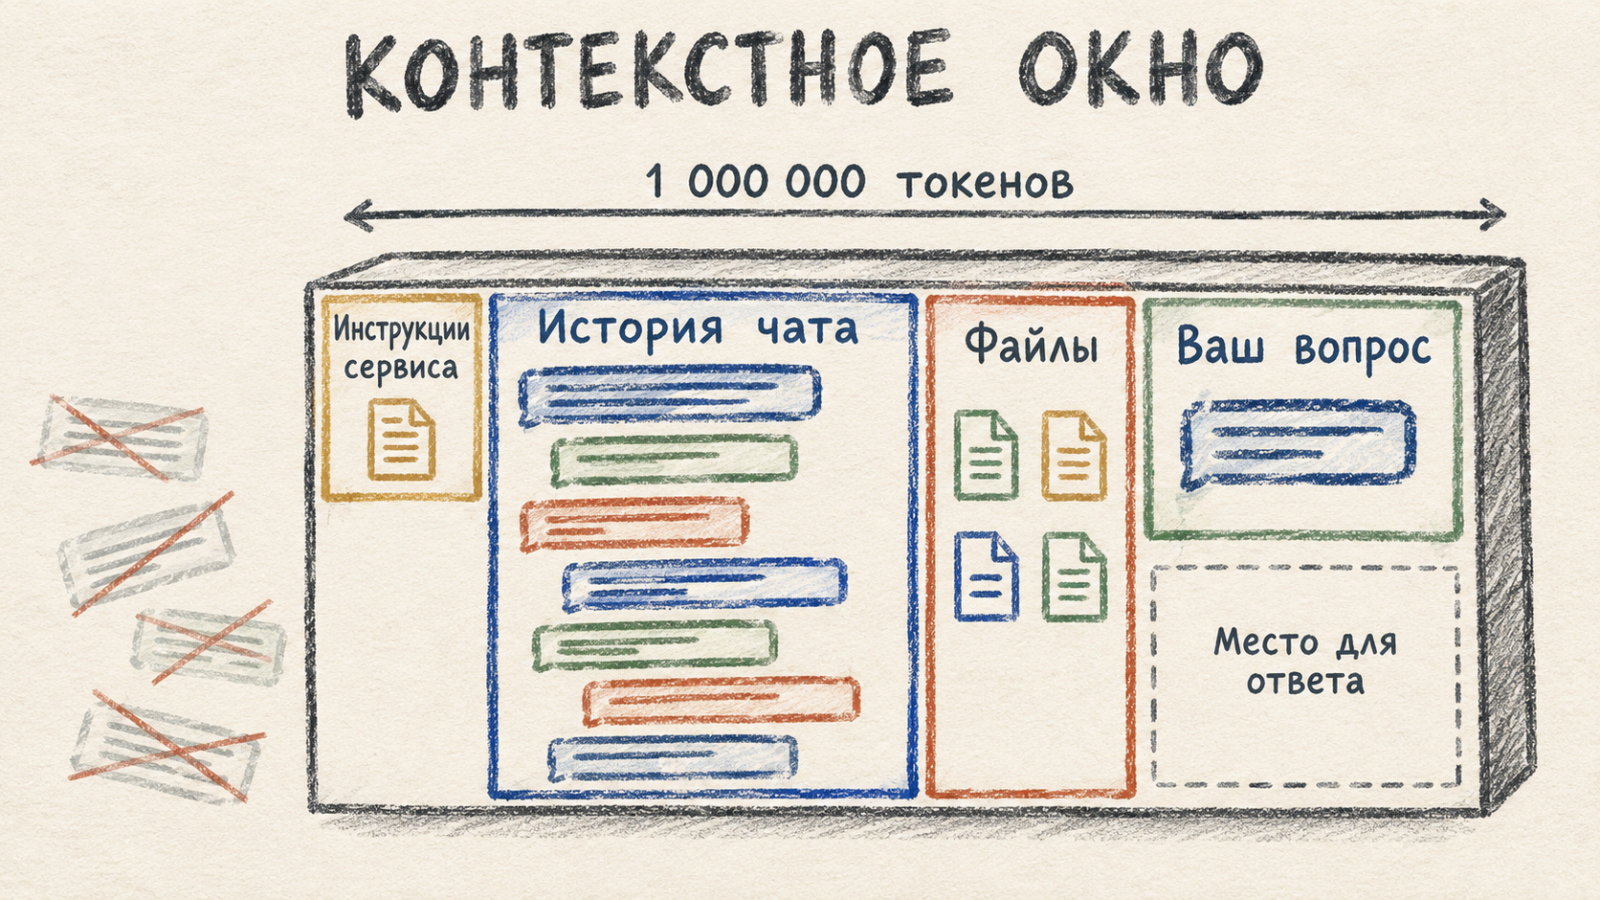
В ноябре 2022-го ChatGPT на GPT-3.5 держал около 4 тысяч токенов – пару страниц. Сегодня у Claude Opus 5.5, Sonnet 5.5 и Fable 5.1 в чате миллион токенов. Через API новые модели OpenAI тоже принимают около миллиона, а в приложении ChatGPT окно уже: на Plus это 54 тысячи токенов у быстрых моделей и 256 тысяч у рассуждающих.
Семь привычек, которые экономят токены и нервы
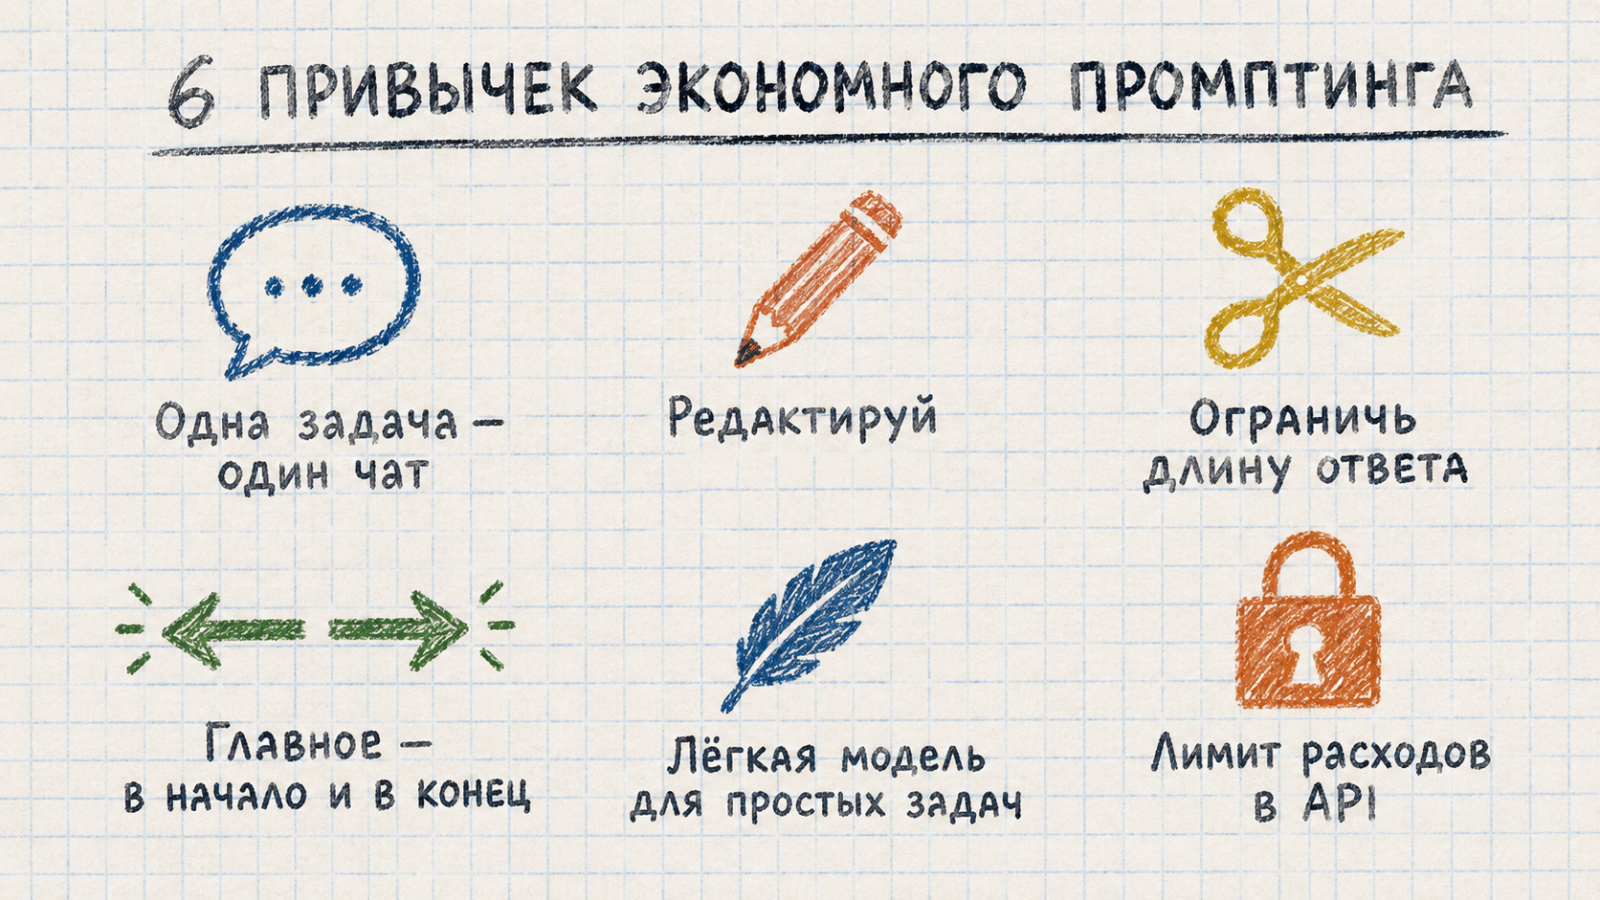
- Одна задача – один чат. Закончили тему – попросите памятку (задача, условия, что уже сделано) и перенесите её в новый диалог.
- Ограничивайте ответ. «Пять пунктов, без вступления»; в API для этого есть параметр max_tokens.
- Главное – в начало и в конец. Правила – первыми строками, вопрос – последней.
- Не кормите лишним. Фрагмент лога вместо всего файла.
- Подбирайте модель под задачу. Опечатки и таблицы осилят GPT 5.4 Mini или Gemini 3.5 Flash-Lite в десятки раз дешевле флагманов, а Claude Sonnet 5 и Opus подойдут для длинных документов.
- Длинные процессы – на шаги. В воркфлоу каждый блок получает на вход только результат предыдущего, без хвоста переписки.
- Считайте заранее. Большой документ прогоните через OpenAI Tokenizer или метод подсчёта токенов Anthropic и оставьте в окне место для ответа.