Галлюцинации нейросетей: как проверять ответы в рабочих задачах
Нейросеть сообщает выдуманный факт тем же тоном, каким сообщает настоящий, и по тексту эти два случая не различаются. Такие выдумки называют галлюцинациями нейросети.
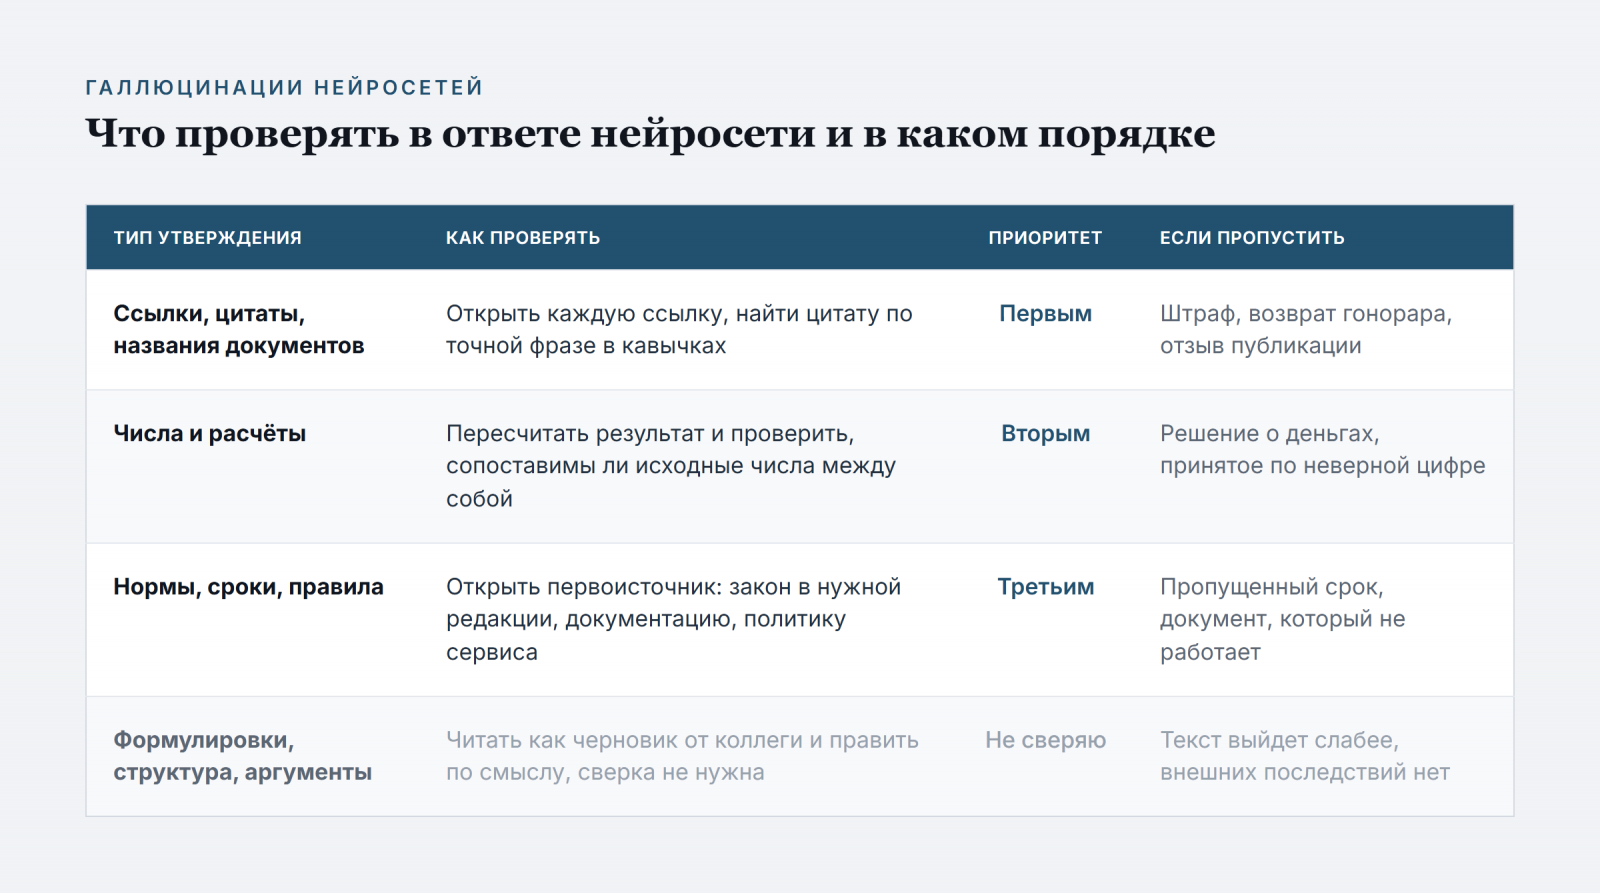
Проверять весь ответ подряд не выходит, на это уходит больше времени, чем на саму задачу. Начинаю я с сортировки. В ответе есть три типа утверждений, которые модель выдумывает чаще всего: ссылки и цитаты, числа и расчёты, нормы и сроки. Их я сверяю с источником всегда. Рассуждения, структуру и формулировки читаю как черновик и не сверяю вовсе. Сортировка по типу занимает минуты и ловит те ошибки, за которые потом платят. В мае 2026 года арбитражный суд оштрафовал компанию на 50 000 рублей за ссылки на судебные решения, которых не существует.
Почему галлюцинацию не видно при чтении
Модель не выбирает между «знаю» и «не знаю». В сентябре 2025 года OpenAI вместе с Georgia Tech выпустила работу «Why Language Models Hallucinate», где причину свели к системе оценки. Бенчмарки, на которых измеряют модели, дают балл за верный ответ и ноль одинаково за ошибку и за отказ отвечать. Угадать выгоднее, чем промолчать.
Уверенный тон получается из того же обучения, что и правильный ответ, и для читателя он не значит ничего. Совет насторожиться, если модель звучит слишком уверенно, на практике не работает, ведь звучит она так всегда.
У выдуманного судебного акта правдоподобный номер и правдоподобное название, сфабрикованная цитата написана в стиле того, кому приписана. Разница видна только при сверке с источником.
Как бороться с галлюцинациями нейросети: что проверять первым?
Дороже всего ошибка обходится в ссылках, цитатах и названиях документов, потому что её увидит кто-то третий. Суд, заказчик или рецензент откроют ту же ссылку и не найдут по ней документа. Я открываю каждую ссылку сам и смотрю, существует ли документ, относится ли он к теме и действует ли в нужной редакции. Цитату ищу по точной фразе в кавычках, и если фраза не находится нигде, она сочинена.
Считает модель верно, а за тем, что она сравнивает, не следит. В одном моём тексте она поделила сумму за восемь месяцев на цену за один месяц и выдала «в 18 раз». Арифметика сошлась, а сравнивать эти два числа было нельзя. Числа и расчёты я из-за этого пересчитываю сам и отдельно смотрю, сопоставимы ли между собой исходные цифры.
Сроки модель называет уверенно, в том числе те, которых в законе нет. В тексте на юридическую тему она написала 30 дней вместо 15 и привязала срок исковой давности не к тому требованию. При чтении обе ошибки выглядели правдоподобно, так что нормы, сроки и правила я сверяю с первоисточником всегда.
Формулировки, структуру, ход рассуждения и подбор аргументов я читаю как черновик от коллеги и правлю по смыслу, без сверки. Ошибки там тоже бывают, но они видны сразу и наружу не выходят.
Съедает ли проверка всё сэкономленное время?
Проверка по типам упирается в сам текст. Ссылки и числа в нём наперечёт, и видно их сразу, не вчитываясь. Время съедает другой сценарий, когда ответ проверяют целиком, от первой строки до последней.
Оценить это на глаз не получается, и тут выручает сторонний замер. Исследование METR (июль 2025 года, 16 опытных разработчиков на своих же open-source проектах) зафиксировало, что с доступом к ИИ-инструментам задачи занимали на 19% больше времени. Участники до начала ждали ускорения на 24%, а после эксперимента всё ещё считали, что ускорились на 20%. В феврале 2026 года METR уточнила, что за прошедший год ускорение стало заметнее, но сам разрыв между ощущением и замером никуда не делся.
Доводку и проверку человек в потраченное время не засчитывает, и считать их приходится отдельно, по тому же принципу, по которому метрику первого пилота фиксируют до старта и не восстанавливают потом по памяти.
Помогает ли спросить у модели, уверена ли она?
Нет. Совет спросить у модели, уверена ли она, встречается чаще любого другого. Её просят оценить достоверность по шкале от 1 до 100, разрешают сказать «не знаю», спрашивают, нет ли в ответе ошибок.
Свою уверенность модель генерирует тем же способом, что и сам ответ. Бенчмарк AA-Omniscience от Artificial Analysis (ноябрь 2025 года, 6 000 вопросов) устроен так, что неверный ответ штрафуется, а отказ отвечать нет. Выше нуля по нему набрали три модели из всех протестированных. На сложном вопросе почти любая модель скорее выдумает ответ, чем скажет «не знаю», и уверенность в нём сообщит такую же.
Повторный одинаковый ответ означает только устойчивость выдумки. Вторую модель я спрашиваю, но её согласие подтверждением не считаю. На распространённом заблуждении две модели сходятся так же охотно, как на верном факте. Если ответы разошлись, тему надо смотреть руками.
Чем оборачивается пропущенная галлюцинация
14 мая 2026 года Арбитражный суд Западно-Сибирского округа оштрафовал на 50 000 рублей кемеровскую компанию по делу А27-7831/2025. В кассационную жалобу попали ссылки на судебные акты, часть которых относилась к другим делам, а решений ВАС и Верховного суда не оказалось в системе вообще. Цитаты из них были сфабрикованы целиком. Суд указал, что использование нейросети от ответственности не освобождает и за достоверность сведений отвечает тот, кто подал документ. Штраф наложили на компанию, поэтому смена представителя её не спасла. В России это первый такой случай.
В августе 2025 года академические рецензенты нашли в отчёте Deloitte Australia для государственного заказчика три несуществующие научные ссылки и неверно приписанную цитату из решения федерального суда. В октябре компания признала ограниченное использование генеративного ИИ, выпустила исправленную версию отчёта и вернула часть гонорара по контракту почти на 440 тысяч австралийских долларов.
Ни одну из компаний не поймали на слабом рассуждении или неудачной формулировке, претензии в обоих случаях касались ссылок и цитат.
Стало ли меньше галлюцинаций ИИ в новых моделях?
Галлюцинаций стало заметно меньше, но не до нуля. Vectara Hallucination Leaderboard проверяет модели в самом щадящем режиме, когда им дают документ и просят пересказать его, опираясь только на этот текст. В выборке больше 7 700 статей из разных областей, от новостей до медицины и права.
В обновлении от 11 мая 2026 года лучший результат составил 1,8% пересказов с добавленной выдумкой, у следующих четырёх моделей от 3,1% до 4,1%. Исходник модели дан, придумывать ей нечего, и всё равно примерно два пересказа из ста содержат то, чего в тексте не было.
Без поиска и без данного ей документа модель работает в условиях AA-Omniscience, где выше нуля вышли три модели из всех. Поэтому в ответе по незнакомой мне теме я первым делом смотрю, был ли у модели источник или она отвечала из головы.
Как я проверяю ответы нейросети в своей работе
Я готовлю тексты и аналитику с нейросетями каждый день, и процедура выросла из собственных промахов.
В одном черновике статьи модель подставила три цитаты, которых не существует. Все три поймала сверка с файлом, куда я до начала работы собираю факты со ссылками. Готовый текст я прохожу по этому файлу и сверяю каждую цифру и каждую цитату, а утверждение, которого в файле нет, либо получает источник, либо удаляется. В другой раз так же нашлась ссылка на исследование с несуществующего сайта.
Ни инструментов, ни второй пары глаз для этого не нужно. Вся процедура держится на том, что источники собраны заранее и лежат в одном месте.
Частые вопросы
Что такое галлюцинация нейросети простыми словами?
Выдуманный факт, поданный так же уверенно, как настоящий. Несуществующая ссылка, сочинённая цитата, неверный срок или число. Модель предсказывает правдоподобное продолжение текста и не проверяет, соответствует ли оно реальности.
Как бороться с галлюцинациями нейросети в рабочих задачах?
Сверять с источником три типа утверждений в таком порядке. Сначала ссылки, цитаты и названия документов, потом числа и расчёты, потом нормы и сроки. Промпты и просьбы «не выдумывать» долю ошибок снижают, но сверку не заменяют.
Как быстро понять, что нейросеть выдумывает?
По самому тексту никак, стилистических признаков у выдумки нет. Быстрее всего идти через источник. Открыть ссылки, поискать цитату по точной фразе, пересчитать числа.
Можно ли попросить нейросеть не выдумывать?
Помогает ограничить её тем текстом, который ей дан. Я так и делаю, когда прошу пересказать документ, но полностью проблему это не снимает. По замерам Vectara на май 2026 года лучшие модели добавляют выдумку в 1,8-4,1% пересказов даже с данным им исходником.
Помогает ли спросить у второй нейросети?
Расхождение ответов даёт надёжный повод открыть источник. Совпадение не гарантирует ничего, потому что одно и то же заблуждение две модели повторяют охотно.
Кто отвечает, если в документ попала ошибка нейросети? Тот, кто подал документ. В мае 2026 года Арбитражный суд Западно-Сибирского округа оштрафовал компанию на 50 000 рублей за выдуманную судебную практику в кассационной жалобе и указал, что использование ИИ от ответственности не освобождает.
Стало ли меньше галлюцинаций в новых моделях?
Заметно меньше, но не ноль. На пересказе готового документа лучший результат в замере Vectara от 11 мая 2026 года составил 1,8% ответов с выдумкой. Когда документа нет и модель отвечает по памяти, картина другая. По бенчмарку AA-Omniscience выше нуля вышли три модели из всех протестированных, а разброс между ними большой, поэтому под конкретную задачу их приходится выбирать отдельно.
В каких задачах проверять обязательно, а где можно не тратить время?
Обязательно там, где утверждение увидит третья сторона и сможет его опровергнуть. Документы для суда и госорганов, отчёты заказчику, публикации. В черновиках, конспектах и внутренней переписке проверять по типам не нужно, цена ошибки в них равна времени на переделку.
Об авторе
Тимур Яковлев — экспертный редактор бизнес-сообщества по искусственному интеллекту. Внедряет нейросети в собственные процессы, от контента до продаж, и разбирает на своих цифрах, что из этого окупается.