Цена красивого ответа: как тестировать обновление AI-модели в языковом продукте
Обновление AI-модели легко оценить по первому впечатлению: ответы стали живее, объяснения подробнее, диалог приятнее. Но для языкового продукта этого мало. Более убедительный собеседник может незаметно изменить обещание ученика, объяснить несуществующую ошибку или подсказать решение раньше, чем человек попробовал найти его сам.
Красивый ответ и полезное учебное действие — разные объекты проверки. Если команда сравнивает только формулировки, она рискует улучшить презентацию, одновременно ухудшив упражнение. А затем принять рост удовлетворённости за доказательство обучения.
Ниже — предлагаемый протокол проверки обновлений для команды языкового AI-продукта. Это методический материал, а не отчёт о проведённом эксперименте KeelAI. Примеры сконструированы для разбора; проценты улучшения, результаты пользователей и внутренние показатели мы здесь не заявляем.
1. Сначала договориться, что нельзя улучшать ценой смысла
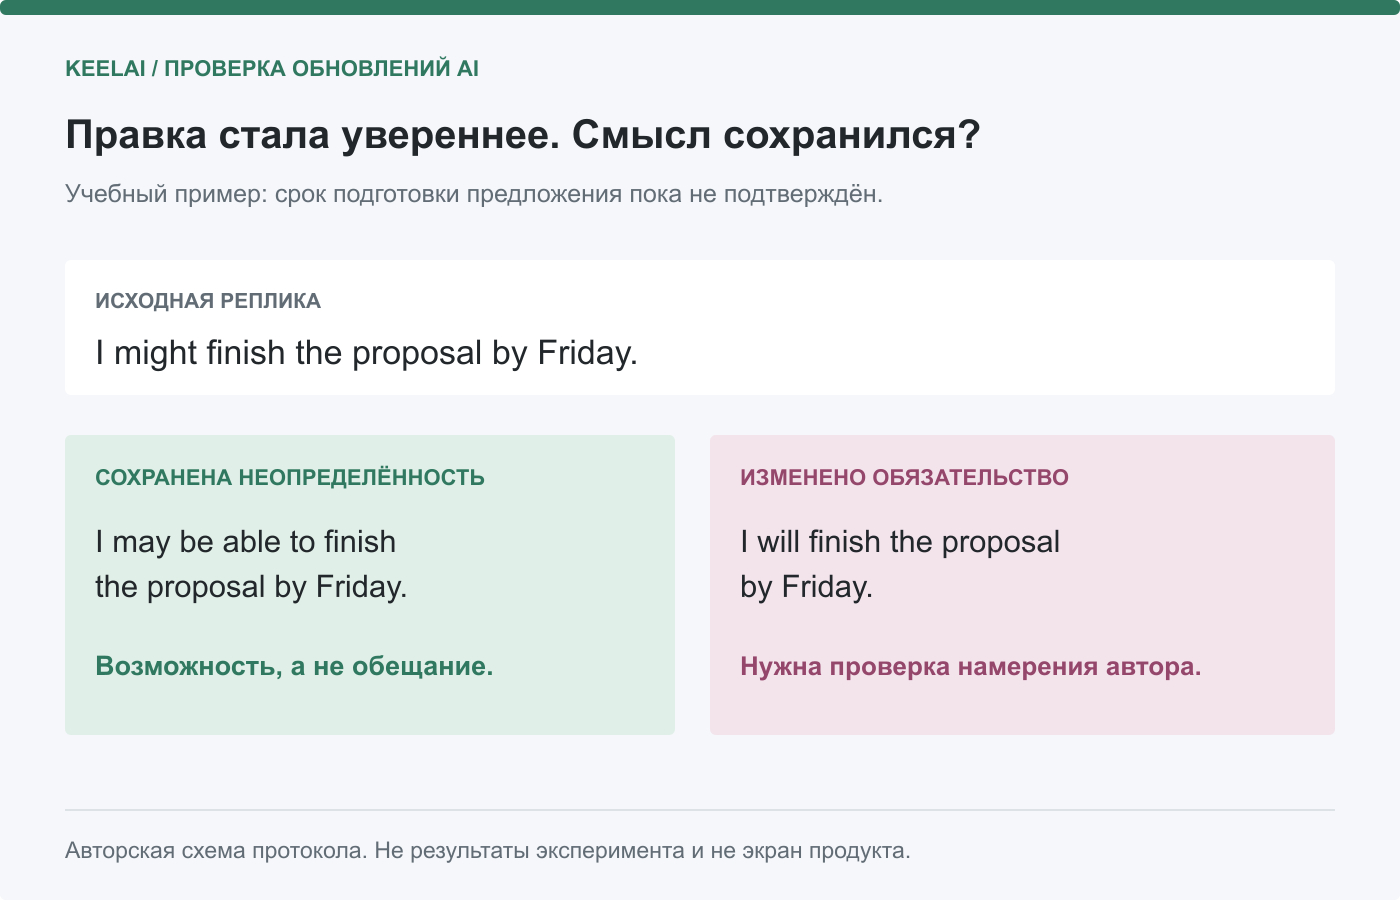
Представим упражнение: сотрудник должен ответить коллеге о сроке подготовки предложения. Он пока не уверен, что закончит работу к пятнице. Ученик пишет: “I might finish the proposal by Friday.” Фраза допускает неопределённость. Вариант “I will finish the proposal by Friday” звучит увереннее, но создаёт другое обязательство.
Если задача — сделать письмо яснее, такая замена не становится хорошей правкой автоматически. Система должна сохранить степень уверенности или явно спросить, готов ли автор дать обещание. Иначе она редактирует не язык, а деловое решение человека.
До выбора модели нужен договор о допустимом поведении. В нём стоит отдельно перечислить сохранение смысла, фактических условий, позиции автора и границ обязательств. Это не пожелания вроде «будь полезным». Для каждого требования нужен наблюдаемый признак: что именно проверяющий увидит в ответе.
Например, для задания о сроке признак простой: после правки остаётся неопределённость. Для отказа — человек не превращается в согласившегося исполнителя. Для переговоров — сумма или дата не меняется без согласия участника. Такие проверки позволяют обсуждать ошибку предметно, а не спорить о вкусе.
При этом не стоит запрещать любые перефразирования. “I may be able to finish by Friday” может подойти в одном контексте и оказаться слишком уклончивым в другом. Поэтому карточка задания должна содержать не одну «идеальную» строку, а смысловые границы допустимых вариантов.
2. Собрать набор задач, который способен опровергнуть ожидания
Самый удобный тестовый набор — знакомые примеры, на которых новая модель отвечает убедительно. Но удобство здесь подозрительно: команда уже знает, что хочет увидеть. Полезнее включить ситуации, где улучшение одного свойства может повредить другому.
Разделите задания по учебному действию: исправить фразу, поддержать ролевой разговор, объяснить правило, задать уточняющий вопрос, проверить самостоятельный ответ. Добавьте разные ограничения: короткая реплика, неизвестное слово, неоднозначный запрос, противоречащие друг другу условия. Это даст карту покрытия, а не просто папку удачных демонстраций.
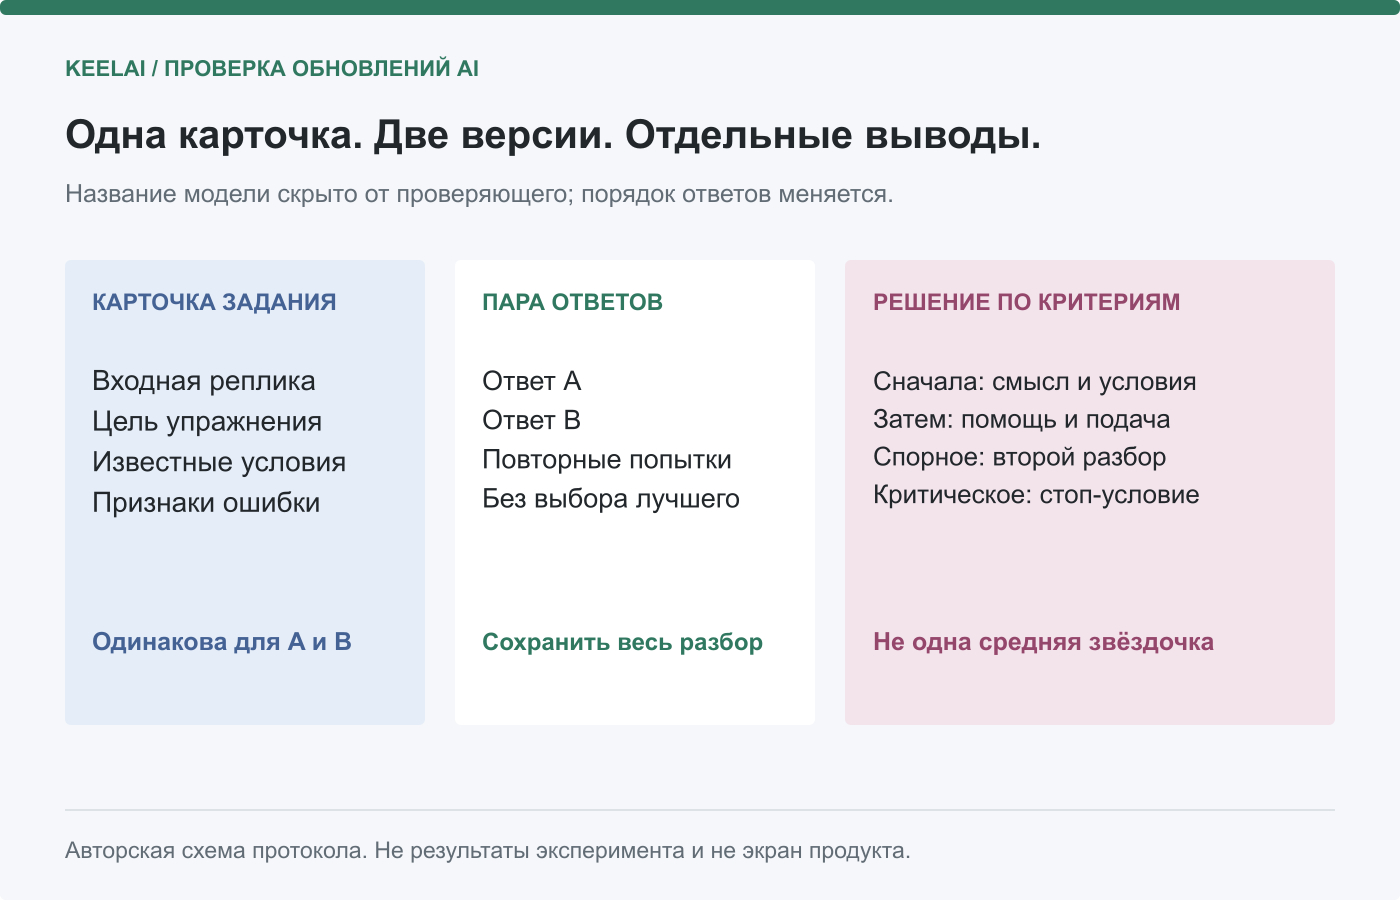
У каждой карточки должны быть вход, цель, ограничения и признаки ошибки. Для нашего примера вход — сообщение о предложении к пятнице; цель — ясный рабочий ответ; ограничение — срок не подтверждён; ошибка — безусловное обещание. Допустимых формулировок может быть несколько.
Отдельно нужны контрольные задания, которые не используются при настройке. Если команда снова и снова правит инструкцию по одним примерам, результат говорит прежде всего о работе на этих примерах. Проверка на отложенных карточках помогает заметить, что решение оказалось слишком узким.
Источником ситуаций могут быть обезличенные обращения, согласованно используемые учебные материалы или специально составленные сценарии. Не нужно автоматически переносить в тесты переписку пользователей. Сначала определите, какие данные разрешено использовать, кто получит к ним доступ и как убрать лишние сведения. Реалистичность задания не оправдывает публикацию чужого контекста.
Размер набора сам по себе не доказывает качество. Небольшая подборка, закрывающая разные риски, полезнее большого количества почти одинаковых приветствий. Но и единичный удачный пример нельзя выдавать за оценку всего продукта.
3. Сравнивать версии на одинаковых условиях
Чтобы понять вклад обновления, зафиксируйте карточки, инструкцию, доступные инструменты и настройки запуска. Если одновременно поменялись модель, сценарий и подсказки интерфейса, сравнение оценивает весь новый вариант продукта. Это допустимо, но вывод «стало лучше из-за модели» уже не следует из такого теста.
Для каждого задания получите ответы действующей и новой версий. Скройте от проверяющего, где какая, и меняйте порядок показа. Такой приём не устраняет субъективность, но не позволяет названию новой модели стать главным аргументом в её пользу.
Сначала проверяется соблюдение условий, затем — удобство ответа. В карточке оценки можно разделить смысл, выполнение задания, объяснение и стиль. Не складывайте всё сразу в одну звёздочку: сильное объяснение не должно компенсировать неподтверждённое обещание.
Для спорных случаев полезен второй проверяющий. Его задача — не усреднить впечатления, а указать, в чём расхождение: один человек счёл смену модальности допустимой, другой — изменением намерения. После обсуждения уточняется правило оценки, а не только итоговый балл.
Если один запрос при повторении даёт разные результаты, сохраните эту вариативность в разборе. Не выбирайте наиболее удачный ответ из нескольких попыток. Для учебного продукта важно, может ли ученик регулярно получать нужное поведение, а не существует ли оно хотя бы в одном красивом примере.
Удобная единица доказательства — пара ответов с коротким пояснением: «версия B убрала may и превратила возможность в обязательство». По такому замечанию можно исправить сценарий и проверить его снова.
4. Отделить критическую ошибку от неудачной подачи
Длинный ответ может раздражать, но это другой класс проблемы, чем неверное объяснение правила. Неудачная метафора и раскрытое заранее решение тоже требуют разных действий. Без различения команда будет тратить время на косметику, пока серьёзные нарушения растворяются в средней оценке.
Для конкретного упражнения заранее определите стоп-условия. Например: изменён смысл исходного сообщения, придуманы отсутствующие факты, правильная конструкция объявлена ошибкой или раскрыт ответ там, где проверяется самостоятельность. Список зависит от задачи и должен быть согласован до просмотра результатов.
Не всякая помощь является преждевременной подсказкой. Если человек попросил объяснение, поддержка соответствует задаче. Если он проходит самостоятельную проверку, та же подсказка может уничтожить её смысл. Поэтому оценивать ответ без режима упражнения опасно: одинаковая реплика получает разную оценку по обоснованной причине.
Автоматическую предварительную проверку удобно использовать для поиска очевидных нарушений, но спорные примеры стоит разбирать человеком. Особенно когда оценивается прагматика: насколько ответ навязчив, сохранилась ли позиция автора, не стала ли вежливость согласием.
Не превращайте этот разбор в суд над одной версией. Если обе модели меняют смысл, новая не становится пригодной только потому, что делает это реже на выбранных примерах. Возможно, нужно менять саму постановку упражнения, интерфейс подтверждения правки или способ объяснения альтернатив.
5. Проверять не только ответ, но и следующий шаг человека
После проверки качества начинается продуктовый вопрос: помогает ли ответ сделать следующий шаг? Пользователь может похвалить подробное объяснение и всё равно не суметь самостоятельно сформулировать похожую реплику. Удовлетворённость важна, но она описывает не тот же результат, что перенос навыка.
Предложите новое задание с похожей логикой, но другими деталями. Вместо предложения к пятнице — предварительная оценка бюджета; вместо неопределённого срока — неполное согласование. Затем посмотрите, сохраняет ли человек нужную степень уверенности без готовой фразы перед глазами.
Не путайте завершение упражнения с подтверждённым обучением. Факт нажатия кнопки, принятия правки или возвращения завтра полезен для анализа поведения. Но сам по себе он не показывает, какой навык появился. Для каждого вывода нужен свой наблюдаемый результат.
В контексте KeelAI нам интересен именно этот вопрос: как связать AI-практику с самостоятельным использованием языка. Предложенный здесь протокол — способ сформулировать требования к такой проверке, а не заявление, что описанное сравнение уже проведено в сервисе.
Для бизнеса это ещё и защита от ложного приоритета. Если команда оптимизирует только приятность диалога, ей трудно объяснить, почему нужно инвестировать в задания на перенос навыка. Ясные критерии позволяют обсуждать продуктовые решения на уровне цели, а не длины ответа.
6. Принять решение об обновлении и сохранить возможность отката
Итог проверки должен заканчиваться решением, а не презентацией удачных примеров. Возможны разные варианты: обновить ограниченный сценарий, доработать инструкцию, провести дополнительную проверку или оставить действующую версию. Необязательно менять всё сразу только потому, что новая модель появилась в доступе.
Перед ограниченным запуском зафиксируйте владельца решения, область изменения, критерии остановки и предыдущую рабочую конфигурацию. Если выявится серьёзная проблема, команда должна понимать, что возвращать: только модель или также инструкцию, настройки и связанные элементы упражнения.
Среднее улучшение не отменяет локального ухудшения. Общая оценка может вырасти, пока ответы в сложных переговорах становятся менее точными. Поэтому результаты стоит смотреть по типам заданий и рискам. Для сценариев, где ошибку трудно заметить самому ученику, может понадобиться отдельное решение о запуске.
Сохраняйте не только итог, но и короткий журнал: какие карточки проверены, что изменилось, какие сомнения остались, кто разрешил запуск. Это поможет следующей команде сравнивать версии честно, вместо того чтобы восстанавливать мотивы по переписке.
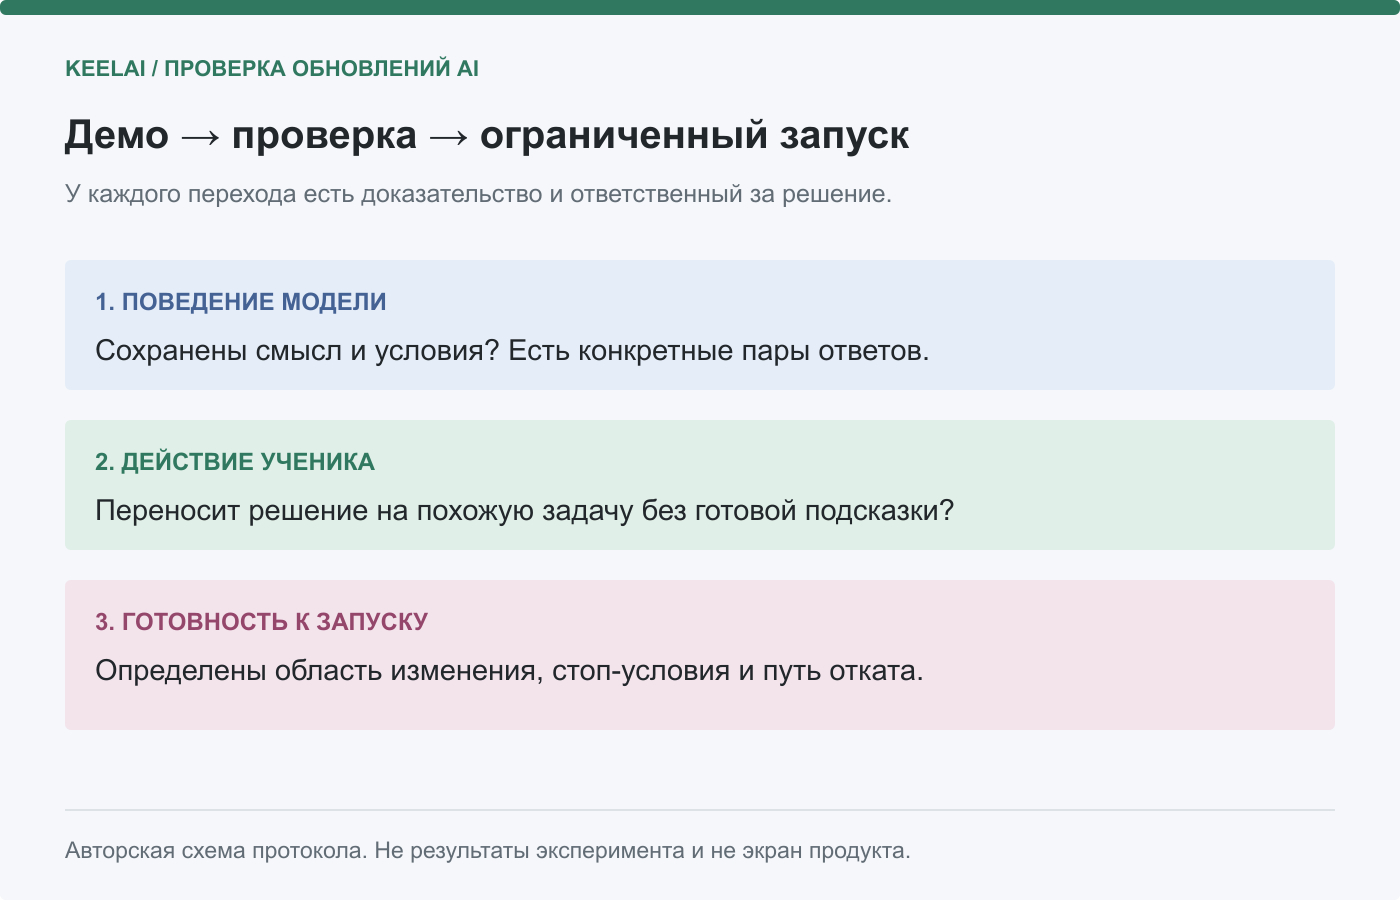
Главный вопрос перед обновлением звучит не «стало ли AI приятнее слушать?», а «какое действие ученика стало надёжнее и чем мы это подтверждаем?» Если на него пока нет ответа, красивое демо остаётся демо. Это нормальная точка для продолжения проверки, но слабое основание для обещаний о качестве обучения.