Урок завершён. А рабочую задачу человек решит? Как проверять перенос языкового навыка
Сотрудник прошёл занятие по английскому, собрал правильные ответы и вернулся на следующий день. Для продуктовой аналитики это понятные события. Но руководителю международной команды нужен другой результат: сможет ли человек уточнить неоднозначный запрос клиента, объяснить задержку и договориться о следующем шаге без постоянного перевода?
Завершённый урок и решённая коммуникативная задача — разные результаты. Между ними нельзя автоматически ставить знак равенства. Особенно в AI-продукте, где подсказка может незаметно выполнить за пользователя существенную часть работы.
Мы развиваем KeelAI и рассматриваем эту проблему как задачу проектирования проверки. Ниже — предлагаемый протокол, а не отчёт о проведённом исследовании. В статье нет заявленных приростов эффективности, клиентских историй или обещания, что определённое количество занятий гарантирует рабочий результат. Есть критерии, которые команда продукта и заказчик корпоративного обучения могут обсудить до запуска эксперимента.
1. Начать не с уровня, а с наблюдаемого действия
Формулировка «подтянуть деловой английский» слишком широкая для продуктового решения. В неё одновременно помещаются словарь, понимание речи, уверенность и умение вести переговоры. Если собрать всё в одну оценку, будет трудно понять, что именно изменилось после практики и какой экран приложения этому помог.
Для первой проверки лучше выбрать одну законченную задачу. Например: прочитать запрос партнёра, обнаружить недостающую информацию и задать уточняющий вопрос. Это учебный сценарий, не описание случая из нашей клиентской практики. Его преимущество в том, что результат можно проверить по содержанию сообщения, а не по впечатлению от красивого текста.
У задачи должны быть исходные условия. Что известно о сроке? Что нельзя обещать? Какая информация нужна для решения? Если условия не записаны, один проверяющий сочтёт ответ вежливым, другой — недостаточно уверенным, а третий пропустит выдуманный срок. Спор будет не о навыке пользователя, а о личных ожиданиях оценщиков.
Рабочий артефакт для команды: карточка с исходным сообщением, ограничениями и перечнем обязательных смысловых действий. Её стоит согласовать раньше, чем выбирать анимацию завершённого урока или формулировать рекламное обещание. Уровень языка остаётся полезным контекстом, но сам по себе не заменяет критерий выполнения конкретной задачи.
2. Развести тренировку и контрольную попытку
В тренировке помощь уместна. Можно разобрать непонятное слово, ещё раз прослушать фрагмент, увидеть пример и переписать ответ. Цель этого режима — дать человеку опору. Ошибка возникает тогда, когда результат с полной поддержкой продукта начинают интерпретировать как самостоятельное выполнение.
Контрольная попытка должна отвечать на отдельный вопрос: что пользователь делает сам при заранее оговорённых условиях? Не обязательно запрещать все инструменты. Если на работе разрешён словарь, разумно разрешить его и в проверке. Но режим с готовым ответом от AI нельзя смешивать с режимом, где человек формулирует сообщение самостоятельно.
Полезно заранее разделить помощь на категории: объяснение слова, указание на пропущенное условие, предложение фразы и полный вариант ответа. Это разные вмешательства. Счётчик «использовал подсказку» стирает различие между уточнением значения и фактической передачей задачи модели.
Интерфейс должен честно обозначать смену режима. Если кнопка помощи выглядит одинаково, а правила внезапно становятся строже, пользователь может воспринимать проверку как наказание. Лучше объяснить цель до старта и не превращать отказ от подсказки в соревнование. Нам нужен интерпретируемый результат, а не мотивация любой ценой закончить без помощи.
Для пилота достаточно простого журнала: какое задание выполнялось, какие виды поддержки открывались и что вошло в итоговый ответ. Это предложение к измерению, а не утверждение, что подобный журнал уже внедрён в KeelAI.
3. Менять условия, сохраняя проверяемый навык
Повторить знакомый диалог полезно для практики, но недостаточно для вывода о переносе. Пользователь мог запомнить последовательность реплик. Поэтому для проверки нужен новый материал: другой собеседник, предмет запроса или формулировка. При этом сложность нельзя менять настолько, чтобы сравнивались принципиально разные задачи.
Предположим, в тренировке партнёр просит прислать материалы, не указав формат. В проверке коллега просит подготовить встречу, не указав часовой пояс. Это два придуманных учебных задания для иллюстрации метода. Общий навык — заметить неоднозначность и запросить конкретное уточнение. Слова различаются, а смысловое действие сохраняется.
Однако такое сходство ещё нужно проверить. Во втором задании могут оказаться более редкие слова или более длинное исходное сообщение. Тогда неудача будет связана с чтением, а не с умением уточнять. Перед пилотом полезно дать задания людям, которые не участвовали в их написании, и собрать замечания о непонятных условиях.
В каждом варианте желательно фиксировать длину сообщения, обязательные действия и допустимые инструменты. Не ради сложной исследовательской системы, а чтобы команда могла объяснить, почему считает варианты сопоставимыми. Если объяснения нет, проценты в итоговом отчёте будут выглядеть точнее, чем позволяет метод.
Перенос — это не просто другое оформление того же вопроса. Новая ситуация должна требовать выбора, а не воспроизведения единственной заученной реплики.
4. Оценивать смысл отдельно от гладкости текста
AI может сделать ответ грамматически аккуратным и убедительным, не исправив его главную проблему. Например, сообщение звучит профессионально, но обещает срок, которого нет в условиях. Для рабочей коммуникации такая ошибка важнее неидеального артикля. Поэтому единый балл «качество английского» здесь неудобен.
Предлагаем разделять оценку на несколько независимых вопросов:
- Понимание: верно ли человек определил запрос и ограничения?
- Действие: задал ли нужный вопрос или предложил допустимый следующий шаг?
- Точность: не добавил ли несуществующие факты и обязательства?
- Понятность: может ли адресат однозначно интерпретировать сообщение?
Языковые ошибки стоит разбирать отдельно: какие мешают смыслу, какие создают нежелательный тон, а какие пока не препятствуют решению. Это не отменяет работу над грамматикой. Такое разделение помогает увидеть, что именно надо тренировать следующим и почему общий красивый балл может скрыть критическую ошибку.
Если первичную оценку даёт модель, её ответ не следует автоматически считать объективной разметкой. Для пилота нужен ручной просмотр примеров и разбор расхождений. Особенно важны пограничные ответы: вежливые, но уклончивые; краткие, но достаточные; грамматически слабые, но точно решающие задачу.
Полезная проверка самого критерия: смогут ли два оценщика независимо объяснить решение одинаковыми фактами из ответа? Если один ссылается на настроение текста, а другой на обязательный уточняющий вопрос, критерий ещё требует доработки.
5. Связать продуктовые события с результатом, не подменяя его
Воронка приложения показывает, где пользователь начал упражнение, остановился или вернулся. Она необходима для диагностики интерфейса. Но рост числа завершённых заданий не доказывает, что человек лучше общается: упражнение могли упростить, подсказку сделать заметнее или сократить обязательную часть.
Для эксперимента стоит хранить рядом два отдельных ряда показателей: поведение внутри продукта и выполнение контрольной задачи. В первом ряду — начало, завершение, виды помощи и повторное посещение. Во втором — смысловые критерии, условия проверки и доля ответов, прошедших ручную оценку. Склеивать их в единый «индекс прогресса» на старте необязательно.
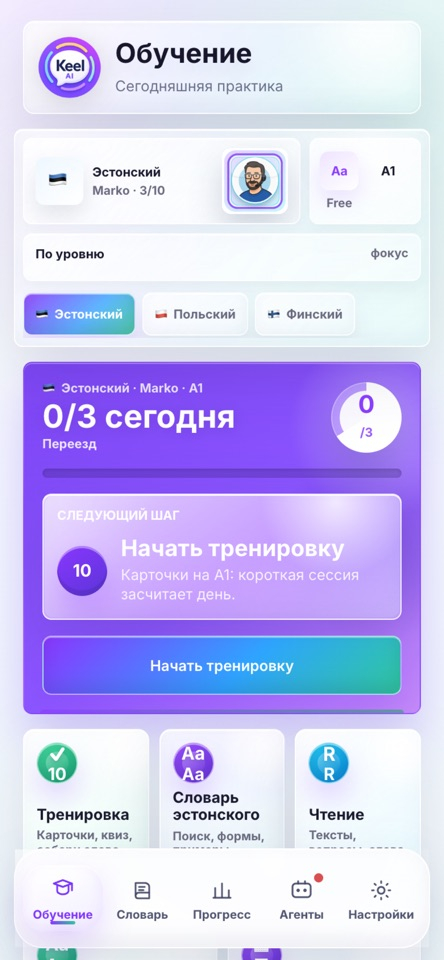
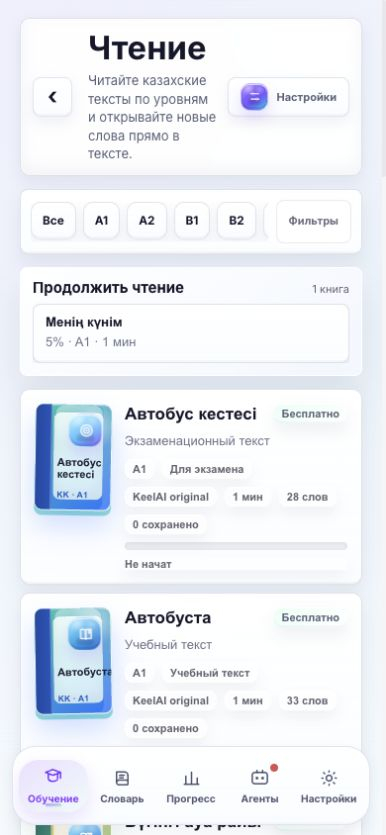
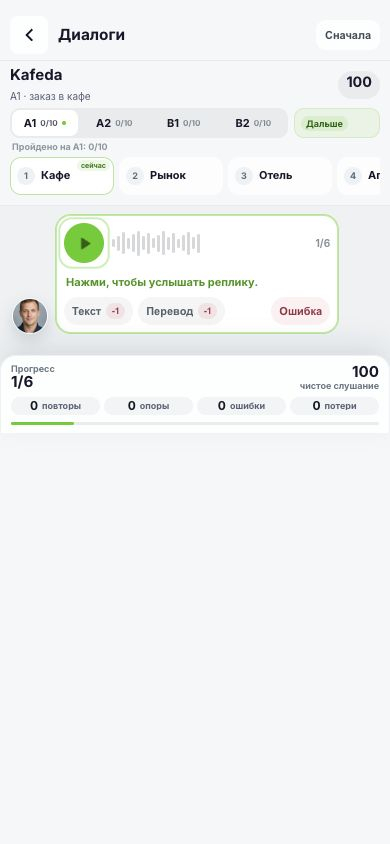
В KeelAI можно посмотреть продуктовый контекст этой задачи: языковая практика объединяет разные форматы, и важно не путать взаимодействие с интерфейсом с результатом обучения. Иллюстрации в статье показывают сам продукт; они не являются доказательством эффективности описанного протокола.
Отдельно нужен знаменатель. Если сравнивать только людей, дошедших до проверки, можно потерять тех, кому сценарий оказался слишком сложным. В отчёте следует показать и число начавших, и число завершивших, и доступность контрольных ответов. Отсутствующий результат нельзя молча считать ни успехом, ни провалом.
Для бизнеса это позволяет сформулировать более точное решение: улучшать вход в упражнение, перерабатывать тренировку или пересматривать сам способ проверки. Без разделения причин команда рискует лечить учебную проблему новой кнопкой, а неудобный интерфейс — дополнительным уроком.
6. Завершать пилот решением, а не обещанием роста
До старта полезно записать, какой результат изменит следующий шаг команды. Например, если человек справляется только после готовой фразы, нужно исследовать зависимость от помощи. Если смысловые действия выполнены, но пользователь не возвращается, это отдельный вопрос ценности и регулярности сценария. Здесь нет универсального порога, который можно честно назначить всем продуктам.
Минимальный пакет пилота: согласованная рабочая задача, тренировочный вариант, новый контрольный вариант, правила помощи, критерии оценки и список ограничений вывода. Лучше закончить небольшой разбор с понятными границами, чем подготовить громкую презентацию, где завершение экрана называется доказанным улучшением языка.
Не менее важно заранее решить, какие данные действительно нужны. Для оценки учебного ответа обычно полезнее обезличенный текст и условия задания, чем название работодателя или содержимое реальной переписки. Учебные сценарии стоит составлять без клиентских секретов. Это уменьшает ненужный объём чувствительной информации и облегчает обсуждение примеров внутри команды.
Итогом первого прогона может стать не рекламная цифра, а исправленная карточка задания: убрали неоднозначное условие, уточнили допустимую помощь, разделили две разные ошибки. Это полноценный результат продуктовой работы, если он делает следующую проверку понятнее и воспроизводимее.
Главный вопрос для международной команды: какую конкретную ситуацию сотрудник должен научиться проходить иначе? Пока ответа нет, счётчики занятий будут удобны для отчётности, но слабо помогут принять решение о пользе обучения. Начать стоит с одной ситуации и честной проверки того, что человек действительно сделал.