Нейросети для аудио и звука: подробный обзор ИИ-моделей для работы со звуком
Ещё недавно возможности нейросетей в работе со звуком сводились главным образом к простым эффектам и синтетической речи. Сегодня технологии шагнули значительно дальше: искусственный интеллект умеет создавать полноценные музыкальные композиции с вокалом, озвучивать тексты на разных языках, генерировать звуковые эффекты, преобразовывать голос в готовой записи и поддерживать практически полноценный разговор в реальном времени.
 Все модели для генерации и обработки аудио доступны в агрегаторе STIVA.ai. Платформа предоставляет доступ к современным ИИ-моделям без VPN и зарубежных банковских карт. Новым пользователям доступно 100 приветственных токенов бесплатно.
Лучшие ИИ-инструменты для работы с аудио и звуком
Нейросетевые сервисы существенно упрощают обработку аудио. С их помощью можно удалять шумы, повышать качество записей, расшифровывать речь и создавать новый голосовой контент. Мы собрали инструменты для разных сценариев использования — от обработки подкастов и видео до профессиональной работы со звуком.
1. Голосовые ассистенты
ChatGPT Голос (Advanced Voice Mode)
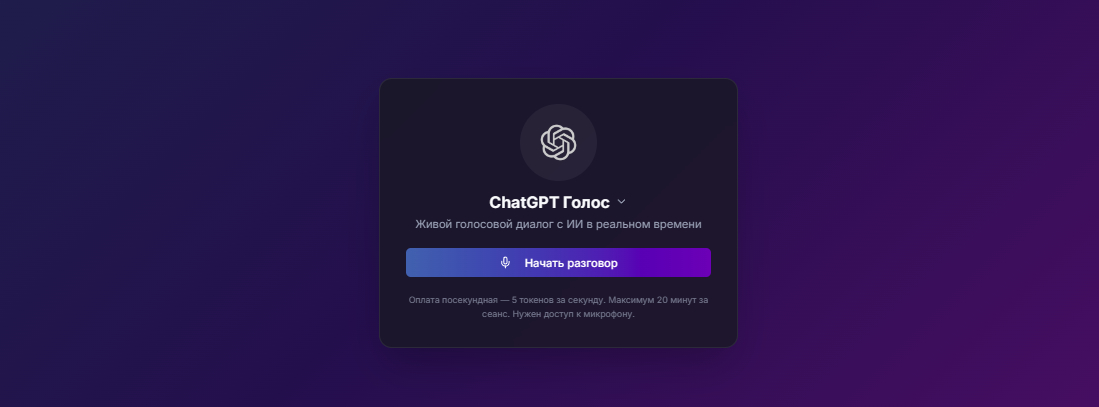
Голосовой режим ChatGPT от OpenAI в первую очередь создан для естественного общения, а не для подготовки готовых аудиофайлов. В отличие от традиционной последовательности «распознавание → текст → ответ → синтез», современные модели могут непосредственно работать с речью, учитывая скорость разговора, паузы, интонацию и другие характеристики живой беседы.
Режим позволяет вести диалог практически в реальном времени. Пользователь может перебить ассистента, попросить говорить иначе, изменить громкость или сделать интонацию более эмоциональной. Поддерживается несколько языков: во время разговора можно переходить с одного языка на другой. Также доступны разные варианты голоса, отличающиеся манерой и характером звучания. Базовая голосовая функция предоставляется бесплатно с ограничениями, а расширенные возможности зависят от выбранного тарифа.
ChatGPT Голос может пригодиться для практики разговорной речи, подготовки к собеседованиям, изучения иностранных языков, создания голосовых заметок и обычного общения. При этом сервис не рассчитан на коммерческую дикторскую запись. Экспорт и коммерческое применение аудио имеют ограничения, а на некоторых менее распространённых языках качество может быть менее стабильным.
2. Синтез речи и работа с голосом: ElevenLabs
ElevenLabs предлагает целый набор специализированных инструментов для работы с голосом. Они позволяют озвучивать текст, создавать звуковые эффекты и изменять голос в уже существующих записях.
ElevenLabs Озвучка (Text to Speech)
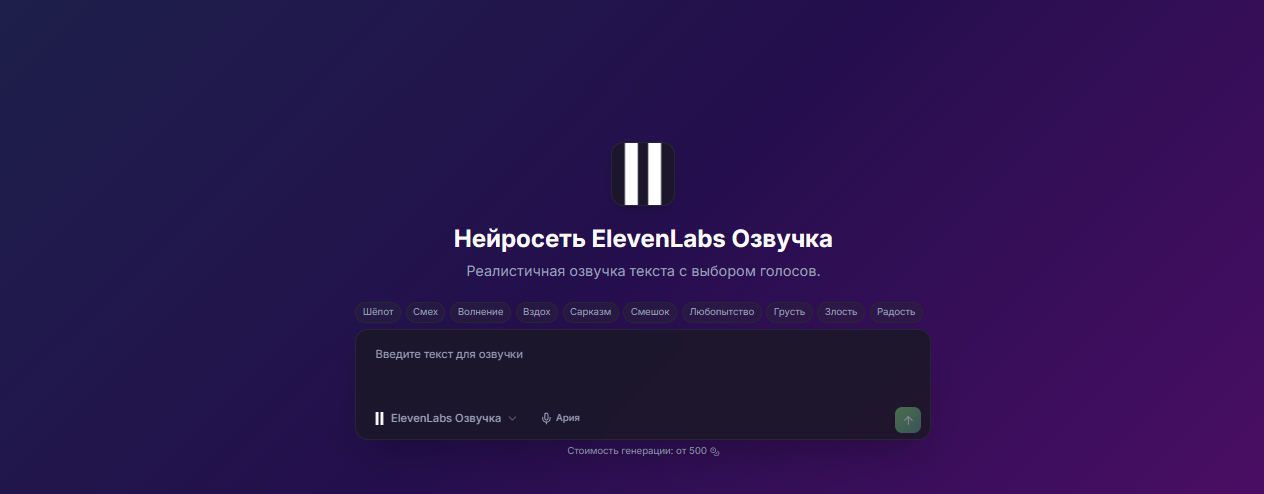
ElevenLabs Озвучка преобразует написанный текст в речь, стараясь воспроизводить естественные паузы, эмоции и изменения интонации. Сервис поддерживает более 70 языков, включая русский, предлагает большую библиотеку готовых голосов и функцию Voice Design, с помощью которой можно создать собственный вариант голоса на основе текстового описания.
Также доступны технологии клонирования голоса в режимах Instant и Professional. В Eleven v3 эмоциональную подачу можно задавать с помощью текстовых инструкций. Для разработчиков предусмотрен API с небольшой задержкой, который можно использовать в чат-ботах, игровых персонажах и голосовых агентах.
Бесплатный тариф включает около 10 000 кредитов в месяц. Стоимость платных планов начинается ориентировочно от $6 в месяц, а вместе с ними предоставляется коммерческая лицензия. Инструмент подходит для производства аудиокниг, рекламных роликов, видео, подкастов, образовательных курсов и голосовых интерфейсов.
ElevenLabs Sound Effects
Генератор ElevenLabs Sound Effects позволяет получать готовые звуковые эффекты из обычного текстового описания. Пользователю достаточно указать, какую сцену или источник звука необходимо воспроизвести.
Сервис способен создавать бытовые и природные звуки, кинематографические эффекты и аудио для игр. В зависимости от версии можно генерировать фрагменты продолжительностью от долей секунды примерно до 22–30 секунд. Дополнительно регулируется влияние текстового промпта на результат, автоматически подбирается продолжительность, а также можно получить несколько разных вариантов одного эффекта.
В среднем одна генерация обходится примерно в 200 кредитов. При использовании API стоимость составляет около $0,12 за минуту аудио. Инструмент будет полезен разработчикам игр, монтажёрам, саунд-дизайнерам, создателям рекламы, видео и подкастов.
ElevenLabs Voice Changer
ElevenLabs Voice Changer предназначен для преобразования голоса в уже готовой записи. При этом технология старается сохранить оригинальную манеру исполнения: интонацию, темп, эмоциональность и особенности подачи.
Можно преобразовывать как обычную речь, так и вокальные партии, выбирая один из тысяч доступных голосов. Поддерживается более 70 языков. Такой подход позволяет, например, заменить черновую запись на более качественно звучащий голос, сохранив живую манеру исполнения. Также доступна интеграция через API, в том числе для быстрой обработки аудио.
Технология может применяться при создании голосов игровых персонажей, работе с подкастами, изменении голоса и обработке вокала. При этом итог во многом зависит от исходной записи: сильный шум и низкое качество сигнала способны заметно ухудшить результат.
3. Генерация музыки
Suno
Suno превращает текстовое описание или готовую лирику в полноценную песню. Сервис самостоятельно формирует вокальную партию, аранжировку, куплеты и припевы.
Актуальная версия — v5.5, выпущенная в марте 2026 года. Модель умеет создавать реалистичный вокал в различных музыкальных жанрах. Среди доступных функций — Voices для генерации песен с голосом пользователя после необходимой проверки, обучение Custom Models на собственной музыкальной коллекции и персонализация рекомендаций с помощью My Taste.
Пользователь также может управлять структурой композиции и её стилем при помощи текстовых инструкций. Готовые треки можно разделять на отдельные стемы, чтобы затем продолжить работу над ними в редакторе.
У Suno есть бесплатный тариф с ограничениями. Платные планы начинаются приблизительно от $10 в месяц и предусматривают коммерческое использование. Сервис особенно удобен музыкантам, авторам контента и всем, кому нужно быстро превратить музыкальную идею в готовую композицию.
MiniMax Music 2.6
Музыкальная модель MiniMax создаёт композиции на основе текста песни и описания желаемого стиля. При необходимости можно отключить вокал и получить инструментальный трек. В версии 2.6 появилась отдельная генерация инструментальной музыки по описанию, а также автоматическое создание текста, если поле для лирики оставить пустым.
Из предыдущей версии сохранились реалистичный вокал с дыханием и естественной динамикой. Для управления развитием композиции предусмотрено более 14 структурных тегов. Через промпт можно задавать BPM и тональность, выбирать расширенный набор инструментов, включая оркестровые и традиционные.
Модель способна создавать композиции длительностью до 6 минут. Максимальный объём текста составляет до 3500 символов, а описание музыкального стиля — до 2000 символов. Наиболее предсказуемые результаты обычно получаются при работе с английским и китайским языками. Русский язык поддерживается, однако качество и естественность вокала могут варьироваться.
MiniMax Music интересен прежде всего разработчикам и авторам, которым необходим программный доступ к генерации и более детальный контроль над параметрами музыки. API доступен через Replicate, WaveSpeed и другие платформы.
Stable Audio 2.5
Stable Audio 2.5 от Stability AI ориентирована в первую очередь на профессиональные команды, бренды и агентства. Модель представили в сентябре 2025 года.
Она способна создавать структурированные композиции продолжительностью до 3 минут и поддерживает стереоформат 48 кГц, ориентированный на профессиональное производство. Управлять жанром, настроением и развитием композиции можно обычным языком.
Кроме генерации, предусмотрены Audio-to-Audio и инпейнтинг для изменения уже существующего материала. Модель использует лицензированные данные для обучения и защитные фильтры. Также предусмотрена возможность дообучения под собственную фирменную звуковую библиотеку.
Stable Audio 2.5 подходит для саунд-брендинга, рекламных материалов, музыки для цифровых сервисов и приложений, а также крупных корпоративных процессов по созданию контента.
Stable Audio 3
Stable Audio 3 — новое поколение моделей Stability AI, представленное в мае 2026 года. Одной из ключевых особенностей стала доступность открытых весов и нескольких вариантов модели: Small, Medium и Large.
Модель способна создавать стереотреки продолжительностью до 6 минут 20 секунд с частотой 44,1 кГц. Она работает как с музыкой, так и со звуковыми эффектами, позволяет редактировать отдельные участки аудио с помощью инпейнтинга и продолжать существующие композиции.
Также поддерживается переменная продолжительность генерации и быстрое создание длинных аудиофрагментов на производительном GPU. Stable Audio 3 можно запускать локально, причём версия Small рассчитана в том числе на работу на MacBook Pro без отдельной видеокарты.
Stable Audio 3 будет интересна разработчикам, исследователям и студиям, которым важны локальная обработка, контроль над собственными данными и возможность интегрировать модель в свои продукты.
Какую нейросеть выбрать для конкретной задачи
📌 Для общения с ИИ, практики иностранных языков и репетиций оптимальным вариантом будет ChatGPT Голос.
📌 Для создания аудиокниг, роликов, курсов и профессиональной озвучки подойдёт ElevenLabs Озвучка.
📌 Если нужны звуковые эффекты для видео или игр, стоит обратить внимание на ElevenLabs Sound Effects. Для изменения голоса с сохранением оригинальной манеры исполнения предназначен ElevenLabs Voice Changer.
📌 Для быстрой генерации готовой песни удобно использовать Suno. Если важнее программное управление структурой, BPM и тональностью, стоит выбрать MiniMax Music 2.6.
📌 Для корпоративных проектов, саунд-дизайна и задач, где особенно важны вопросы лицензирования, подойдёт Stable Audio 2.5. Для локальной генерации и работы с открытыми моделями — Stable Audio 3.
Главные тенденции генеративного аудио
Одно из главных изменений — переход от генерации коротких фрагментов к созданию полноценных музыкальных произведений. Современные модели уже способны формировать композиции продолжительностью в несколько минут и создавать в них относительно понятную структуру.
Вторая важная тенденция — персонализация. Благодаря клонированию голоса пользователь может переносить собственную манеру звучания в новые проекты.
Третье направление связано с развитием открытых моделей. Stable Audio 3 демонстрирует, что всё более сложные аудиосистемы можно использовать локально, сохраняя больший контроль над данными.
Ещё одна тенденция — превращение голоса в полноценный интерфейс взаимодействия с технологиями. Разговорные режимы и API с небольшой задержкой делают общение с ИИ всё более похожим на естественный диалог.
Наконец, всё большее значение получает лицензирование. Для бизнеса важно учитывать не только качество сгенерированного результата, но и то, на каких условиях его можно использовать.
Генеративный звук уже перестал быть исключительно экспериментальной технологией. Сегодня он применяется музыкантами, монтажёрами, маркетологами, разработчиками и другими создателями контента.
Нейросети для аудио: генерация, обработка, расшифровка и создание звуков
Современные ИИ-сервисы значительно расширили возможности работы со звуком. Они могут создавать музыку и эффекты, превращать текст в речь, распознавать аудиозаписи, переводить голос, удалять шумы и редактировать готовые дорожки.
Такие решения подходят как профессионалам из музыкальной и видеосферы, так и обычным пользователям. Многие сервисы работают непосредственно в браузере и не требуют установки сложного программного обеспечения.
Что умеют нейросети для аудио
Функциональность зависит от конкретного сервиса, однако современные ИИ-инструменты способны создавать речь по текстовому запросу, генерировать музыку и эффекты, преобразовывать текст в аудио, распознавать человеческую речь и переводить аудиозаписи в текст.
Кроме того, нейросети умеют переводить речь на другие языки, удалять шумы и посторонние звуки, повышать качество голоса, создавать звуковое сопровождение для видео и редактировать готовые записи. Поэтому сегодня под понятием «нейросеть для аудио» объединяется сразу несколько разных категорий технологий.
Бесплатные нейросети для аудио
Для несложных задач необязательно приобретать профессиональную подписку. Бесплатные инструменты позволяют создавать голосовые дорожки, расшифровывать интервью, экспериментировать с генерацией звуков и выполнять базовую обработку аудио.
У бесплатных тарифов обычно есть ограничения по длительности файлов, количеству генераций или доступным функциям. Тем не менее для повседневных задач такого набора возможностей часто достаточно.
Например, бесплатный сервис можно использовать для быстрой расшифровки разговора, озвучивания небольшого видео или удаления фонового шума.
Нейросеть для генерации аудио
Генеративные модели создают новый аудиоконтент на основе текстового описания или другого исходного материала. Пользователь задаёт параметры и формулирует желаемый результат, после чего модель генерирует соответствующую звуковую дорожку.
В зависимости от сервиса это может быть музыкальная композиция, голос, атмосферный фон, отдельный звуковой эффект, короткий аудиофрагмент или музыка для подкаста и видео. Особенно полезны такие инструменты авторам, которым постоянно требуется большое количество оригинального аудиоконтента.
Нейросеть для создания аудио
ИИ можно применять для автоматизированного создания самых разных звуковых материалов — от рекламной озвучки до аудиосопровождения презентаций, подкастов и образовательных роликов.
Главное преимущество таких решений — скорость. Вместо поиска студии, диктора и организации записи достаточно подготовить текст и получить готовую дорожку за относительно короткое время. Современные модели также позволяют управлять тембром, интонацией и эмоциональной окраской речи.
Нейросеть для аудио из текста
Технология Text-to-Speech (TTS) преобразует письменный текст в звучащую речь. Она используется для создания роликов, аудиокниг, рекламных материалов, обучающих курсов, презентаций, статей и голосовых сообщений.
Сам процесс обычно достаточно прост: пользователь вводит текст, выбирает голос и необходимые параметры звучания, после чего сервис генерирует готовую аудиозапись.
Нейросеть для расшифровки аудио
Обратная задача — преобразование речи из записи в текст — также давно решается с помощью ИИ. Такая технология особенно полезна при работе с интервью, лекциями, совещаниями, телефонными разговорами и диктофонными записями.
Современные системы способны распознавать нескольких участников разговора, автоматически добавлять знаки препинания и структурировать полученную расшифровку.
Нейросеть для расшифровки аудио в текст
Автоматическая транскрибация избавляет от необходимости многократно прослушивать одну и ту же запись и вручную переносить содержание в документ.
Пользователю достаточно загрузить аудиофайл, дождаться завершения обработки и проверить полученный текст. После этого расшифровку можно отредактировать вручную. Точность результата зависит от качества записи, языка, уровня фонового шума и особенностей речи говорящих.
Нейросеть для перевода аудио
Перевод голосовой записи обычно включает сразу несколько операций: распознавание речи, перевод полученного текста и последующий синтез голоса.
Таким способом исходную аудиозапись можно превратить в текст, перевести на нужный язык и затем получить новую голосовую дорожку. Технология особенно полезна для видео, интервью, образовательных материалов и международных проектов.
Некоторые современные решения стараются сохранять темп и особенности оригинальной подачи, благодаря чему итоговый перевод воспринимается естественнее.
Нейросеть для звука
Термин «нейросеть для звука» охватывает более широкий спектр инструментов, предназначенных для генерации, анализа и обработки аудиоматериалов.
ИИ может работать с речью, музыкой, шумами и отдельными эффектами. Благодаря этому подобные технологии востребованы в кино- и видеопроизводстве, игровой индустрии, рекламе, подкастах и музыкальной сфере.
Нейросеть для генерации звуков
Генераторы звуковых эффектов позволяют создавать отдельные аудиофрагменты по текстовому описанию.
Можно указать сцену, которую необходимо озвучить: например, дождь, городской шум, шаги, закрытие двери или природные звуки. После этого модель создаст соответствующий эффект. Такой подход позволяет сократить время, которое раньше требовалось на поиск подходящего файла в специализированных фонотеках.
Бесплатная нейросеть для звуков
Если звуковые эффекты нужны лишь время от времени, можно воспользоваться бесплатным тарифом подходящего сервиса. Как правило, такие планы ограничивают количество генераций или продолжительность создаваемых фрагментов.
Для небольших видео, презентаций и знакомства с возможностями генеративного ИИ этого часто бывает достаточно.
Нейросеть для создания звуков
Генератор звуков можно адаптировать под конкретный эпизод видеоролика. Вместо длительного поиска подходящего файла пользователь описывает нужную сцену и получает несколько вариантов.
Кроме отдельных эффектов, ИИ способен создавать фоновые шумы и атмосферные дорожки, которые делают происходящее в кадре более убедительным и реалистичным.
Нейросеть для звука видео
Во время видеомонтажа нередко требуется очистить голос от шума, добавить музыку, усилить отдельные эффекты или скорректировать громкость. ИИ-сервисы позволяют автоматизировать значительную часть этих операций.
Они анализируют аудиодорожку и применяют необходимые изменения без большого количества ручных настроек. Особенно востребованы инструменты шумоподавления, повышения разборчивости речи и автоматического выравнивания громкости.
Нейросеть для генерации звука для видео
Такие сервисы помогают создавать аудиосопровождение непосредственно под конкретную сцену. С их помощью можно генерировать звуки окружающей среды, шаги, движение предметов, атмосферные шумы, фоновые эффекты, музыку и голос.
Это расширяет возможности видеомейкеров, блогеров, разработчиков и других создателей цифрового контента.
Нейросеть для улучшения звука
Не всегда необходимо создавать новую запись. Во многих случаях достаточно обработать уже имеющийся материал.
Нейросеть может уменьшить фоновый шум, убрать отдельные помехи, сделать речь более разборчивой, улучшить звучание записи с микрофона, выровнять громкость и повысить качество голоса. Такие возможности особенно полезны при работе с записями, сделанными на смартфон или в помещениях с не самой хорошей акустикой.
Нейросеть для обработки звука
ИИ способен автоматизировать множество операций, которые раньше выполнялись вручную в аудиоредакторах. Модель может определить участки с речью и шумом, разделить составляющие записи и применить соответствующую обработку.
Во многих сервисах для этого достаточно загрузить файл и выбрать подходящий режим. В результате обработка занимает меньше времени, а качественный результат становится доступнее даже пользователям без глубоких знаний в области звукорежиссуры.
Как выбрать нейросеть для работы с аудио
Выбирать сервис лучше всего исходя из конкретной задачи.
Для преобразования текста в речь потребуется TTS-инструмент. Для обработки интервью, лекций и совещаний — сервис распознавания речи. При создании видео и игр пригодится генератор звуковых эффектов. Если нужно улучшить уже существующую запись, следует искать сервис с функциями обработки и шумоподавления.
При выборе также стоит обратить внимание на поддержку русского языка, условия бесплатного тарифа, допустимый размер и продолжительность файлов, качество генерации, доступные форматы экспорта, функции работы с голосом, скорость обработки и правила коммерческого использования.
Заключение
Искусственный интеллект постепенно делает работу со звуком быстрее и доступнее. Современные нейросети способны не только создавать новые аудиоматериалы, но и распознавать речь, переводить её, улучшать качество записей и автоматически выполнять различные операции обработки.
Бесплатные инструменты позволяют познакомиться с технологиями без покупки профессионального программного обеспечения, а генеративные модели дают возможность создавать музыку, голосовые дорожки и звуковые эффекты практически на основе одного текстового описания.
В результате ИИ уже можно использовать практически на любом этапе работы с аудио — от первоначального создания материала до его обработки, перевода и подготовки итоговой версии для видео.