Кейс: GEO‑продвижение в AI Search — как я систематизировал Digital Entity SEO-специалиста
Как согласование внешних источников изменило распознавание специалиста, его компетенций и профессиональной специализации в AI-ответах
Срок эксперимента: июль–сентябрь 2026 года
Объект эксперимента: собственный профессиональный профиль SEO-специалиста
Задача: проверить, изменится ли представление профессиональной сущности в серии AI-ответов, если систематизировать публичные источники, факты и связи вокруг уже существующего профиля.
Почему это GEO
SEO традиционно работает с поисковой выдачей: страницами, запросами, контентом, ссылками и техническими факторами.
GEO в этом кейсе я рассматриваю как дополнительный подход к работе с тем, как генеративные системы находят, интерпретируют и используют информацию о сущностях, фактах и источниках при формировании ответа.
В классическом поиске путь можно условно представить так:
запрос → поисковая выдача → страница → переход.
Для целей этого кейса генеративный поиск можно описать упрощённой схемой:
запрос → поиск и извлечение доступной информации → интерпретация сущностей и фактов → AI-ответ → ссылки на источники, если они отображаются.
Это не описание внутреннего алгоритма Gemini или другой конкретной модели, а рабочая схема, по которой я строил наблюдения.
Поэтому задача GEO здесь заключалась не просто в том, чтобы отдельные страницы были найдены. Важно было проверить, насколько последовательно AI распознаёт саму сущность, связывает с ней факты и отличает её от одноимённых объектов.
Я не нашёл публичной методики, которую можно было бы напрямую воспроизвести для проверки одного профессионального профиля в нескольких AI-сценариях. Поэтому собрал собственную рабочую схему наблюдений.
Почему эксперимент проводился на собственном профиле
Логичный вопрос: почему для эксперимента я выбрал собственный профессиональный профиль, а не крупного клиента?
Ответ связан с методологией самого эксперимента.
В GEO критически важно по возможности изолировать факторы. Работая со своим именем, я мог контролировать и отслеживать основные точки собственного упоминания как в Рунете, так и в зарубежном информационном пространстве: публикации, профили, исследования, репозитории и связанные источники.
Это позволяло существенно снизить влияние внешнего информационного шума — случайных публикаций, отзывов, упоминаний одноимённых людей и других изменений, которые сложно контролировать в эксперименте на стороннем бренде.
Вместо того чтобы одновременно наблюдать за десятками неизвестных изменений вокруг крупного клиента, я получил возможность последовательно фиксировать:
что было в информационном корпусе → что изменилось → как после этого изменились AI-ответы.
При этом я не утверждаю, что таким способом можно полностью исключить влияние внешней среды. AI Search работает с динамическим информационным пространством, и часть факторов всё равно остаётся неконтролируемой.
Но собственный профиль позволил сделать эксперимент значительно более управляемым: я лучше знал исходное состояние информационного корпуса и мог контролировать вносимые изменения.
Именно поэтому этот кейс следует рассматривать прежде всего как контролируемое практическое наблюдение за GEO-подходом, а не как попытку сразу измерить коммерческий эффект технологии на клиентском проекте.
Исходная проблема
К началу эксперимента в интернете уже существовала информация о моей профессиональной деятельности: я много лет работаю в SEO, являюсь основателем «Системного SEO» и платформы «СЕО-Модуль», публикую материалы о поисковом маркетинге, GEO и AI Visibility.
Однако отдельные публикации и профили ещё не означали, что AI-системы воспринимают их как единый профессиональный профиль.
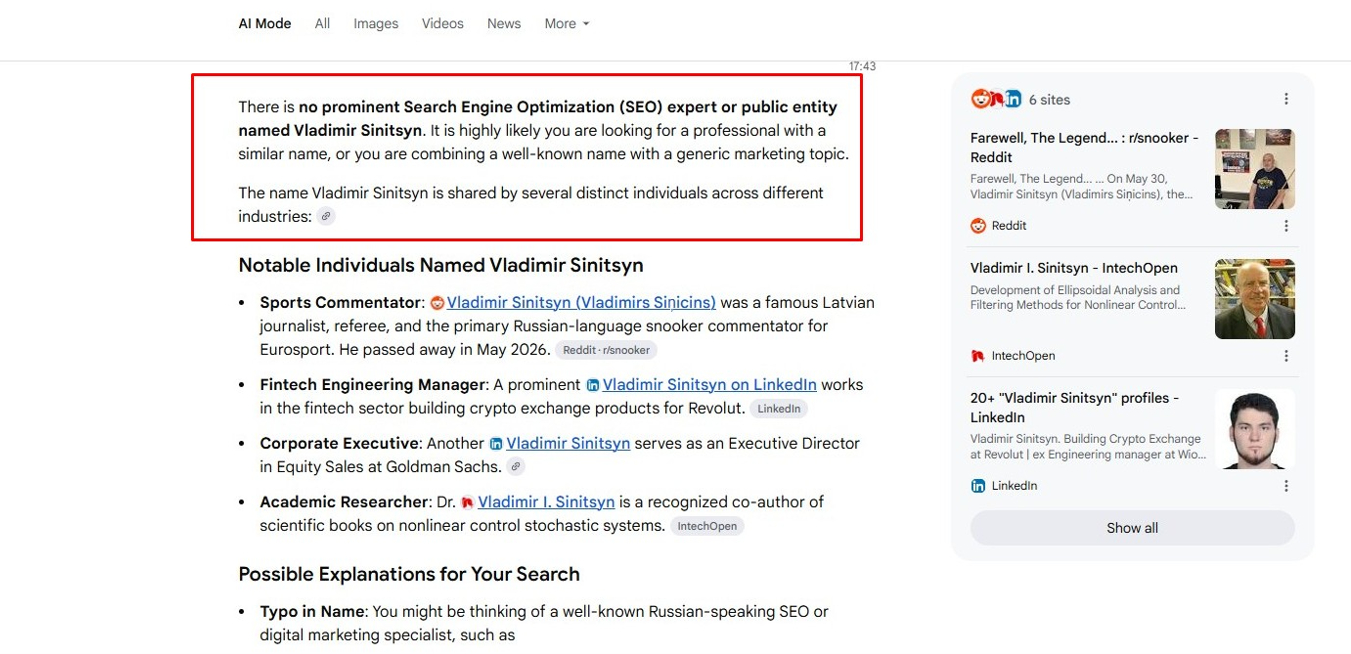
В августе 2026 года я провёл контрольную проверку в Google Gemini по запросу:
vladimir sinitsyn seo
Результат оказался показательным: модель не всегда корректно собирала информацию обо мне в единый профиль. В ответах появлялись люди с таким же или похожим именем, отдельные факты относились к другим сущностям, а связь имени с SEO была слабее, чем ожидалось.
Проблема заключалась не только в видимости информации, а в том, как AI идентифицировал сам объект поиска.
Один человек — разные AI-ответы
Затем я сравнил результаты на русском и английском языках.
Русскоязычный контекст заметно лучше связывал имя с SEO, а также с GEO и AI Visibility.
В англоязычном запросе чаще возникала проблема разрешения одноимённых сущностей: профессиональный контекст был менее устойчивым, а некоторые публикации и сведения не связывались с нужным человеком.
Получалась ситуация:
один человек → одно имя → разные информационные результаты в зависимости от языка запроса.
Для описания этого наблюдения я использую рабочий термин cross-lingual RAG asymmetry — различие качества извлечения и связывания информации об одной и той же сущности в разных языковых информационных корпусах.
Это не официальный термин Google и не утверждение о внутреннем устройстве конкретной модели, а рабочее описание наблюдаемого различия результатов.
GEO-гипотеза
Возник вопрос:
можно ли изменить представление профессиональной сущности в AI Search, если системно согласовать информацию о ней в разных публичных источниках?
Гипотеза состояла в том, что AI будет проще правильно распознавать объект, если вокруг него существует более связный информационный корпус:
имя → профессия → компетенции → проекты → публикации → внешние источники → подтверждающие факты.
Я не пытался «заставить Gemini» выдавать определённый ответ.
Задача была создать более последовательную информационную среду вокруг уже существующей профессиональной сущности и затем проверить, изменится ли её представление в AI-ответах.
Digital Entity как объект наблюдения
Под Digital Entity в этом кейсе я понимаю не искусственно созданный образ и не одну страницу в интернете.
Это профессиональная сущность в цифровой среде: совокупность связанных сведений о специалисте, его компетенциях, проектах, публикациях, профилях и подтверждающих источниках.
Поэтому целью эксперимента было не «создать сущность с нуля», а сделать уже существующий публичный информационный корпус менее противоречивым и более связным.
Условно:
SEO: страница → запрос → поисковая выдача
GEO: сущность → факты → источники → связи → AI-ответ
Что я изменил
1. Унификация базовых данных
К единому виду были приведены:
- имя и профессиональное описание;
- роль и специализация;
- «Системное SEO» и «СЕО-Модуль»;
- направления работы;
- проекты;
- авторство;
- внешние профили;
- официальные ссылки.
Задача — исключить ситуацию, при которой разные источники создают несколько отличающихся версий одного профиля.
2. Формирование тематического кластера
Вокруг имени формировался согласованный тематический контур:
SEO → GEO → AI Visibility → AI Search → Entity → RAG → AI Content Verification
Отдельные материалы должны были не просто существовать в интернете, а формировать понятную связь между профессиональной деятельностью и новыми направлениями.
3. Структурированный информационный слой
Параллельно появились публичные исследования и материалы по направлениям:
- Entity Integrity Signals;
- AI Visibility;
- AI Search;
- AI-generated content verification;
- Reverse-RAG;
- Product RAG;
- Entity Resolution;
- проверка фактов и источников.
Часть материалов была оформлена как публичные исследовательские репозитории и машиночитаемые данные.
Это не способ гарантировать появление репозитория или отдельного материала в AI-ответе, а способ публично зафиксировать факты, связи, источники и результаты исследования в структурированном виде.
4. Связывание внешних источников
Я выстраивал связь между:
- официальным сайтом;
- страницами автора;
- профессиональными профилями;
- внешними публикациями;
- исследовательскими материалами;
- публичными репозиториями;
- другими источниками профессиональной информации.
В структурированных данных использовался, в частности, sameAs.
Свойство sameAs использовалось для отражения уже существующих официальных связей между профилями и ресурсами. Оно не рассматривалось как инструмент, который сам по себе влияет на ответы AI-систем или гарантирует их распознавание.
GEO-проверка: до и после
Главным элементом эксперимента стало повторное измерение.
Для каждой проверки я фиксировал:
- язык запроса;
- дату;
- AI-систему и режим;
- полный ответ;
- использованные источники;
- правильность атрибуции;
- наличие одноимённых сущностей;
- профессиональный контекст.
До систематизации информационного корпуса основной проблемой была нестабильная идентификация: имя могло связываться с другими людьми, отдельные факты приписывались другим сущностям, а профессиональная специализация отображалась неполно.
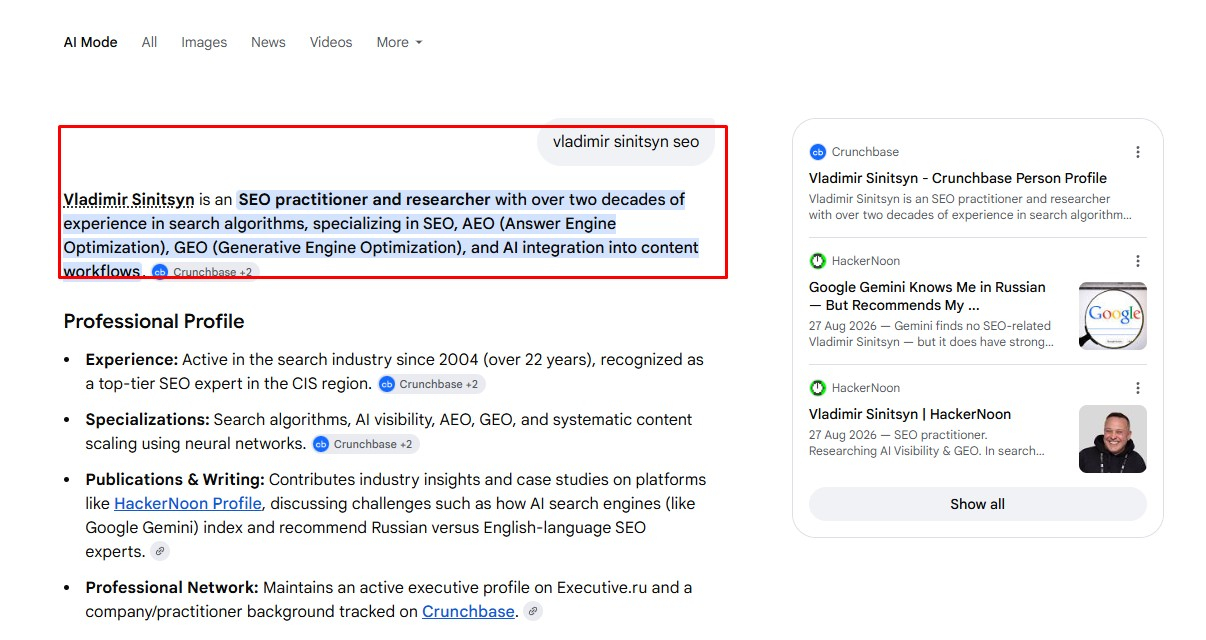
После формирования более согласованного корпуса AI-ответы стали чаще связывать имя с SEO, «Системным SEO», «СЕО-Модулем», профессиональными публикациями, GEO и AI Visibility.
Стало заметнее и тематическое направление:
SEO → GEO → AI Visibility → AI Search.
Скриншот 1. До изменений
Скриншот 2. После изменений
Как оценивался результат
Я не использовал один условный «балл AI Visibility».
Результат оценивался по семи критериям:
- Entity Recognition — правильно ли система распознаёт нужную сущность.
- Entity Resolution — отделяет ли её от одноимённых людей.
- Attribution — правильно ли связывает факты, публикации и проекты.
- Source Selection — какие источники используются.
- Cross-Lingual Consistency — насколько сопоставимы результаты на разных языках.
- Factual Accuracy — насколько корректны приведённые сведения.
- Recommendation Context — в каком профессиональном контексте используется информация.
Последний критерий принципиально отделён от распознавания сущности.
Если AI правильно определил человека, это ещё не означает, что он обязательно будет рекомендовать его пользователю.
Что изменилось
В повторной серии проверок AI-ответы стали чаще связывать профиль с:
- SEO;
- «Системным SEO»;
- «СЕО-Модулем»;
- профессиональными публикациями;
- GEO;
- AI Visibility;
- AI Search;
- исследовательскими материалами.
Профессиональная тематика описывалась более последовательно, а смешение с людьми с похожими именами в ограниченной серии проверок встречалось реже.
Это качественное наблюдение по ограниченной серии проверок, а не статистически подтверждённый результат.
Я также не называю это доказательством того, что конкретная публикация, ссылка, репозиторий или элемент разметки непосредственно вызвали изменение ответов.
За время эксперимента одновременно менялись внешний информационный корпус, поисковая среда, индексация, AI-системы, языки и формулировки запросов.
Поэтому корректнее говорить об наблюдаемом изменении AI Visibility на фоне систематизации публичных данных и связей вокруг профессионального профиля.
Что это означает для бизнеса
Эксперимент проводился на персональном профиле, но сама проблема Entity Recognition и Entity Resolution применима и к брендам, компаниям и продуктам.
Если потенциальный клиент получает информацию о компании, продукте или поставщике через генеративный AI, системе необходимо правильно распознать сущность, связать её с нужными фактами и отличить от других объектов.
Ошибка может проявляться не как классическое падение позиции в поисковой выдаче.
Бренд может:
- не попасть в сформированный AI-ответ;
- быть представлен неполно;
- смешиваться с другой компанией;
- получить некорректную атрибуцию;
- уступить место конкуренту, о котором в доступном информационном корпусе сформирована более связная картина.
Поэтому для бизнеса возникает дополнительная задача: не только продвигать отдельные страницы, но и контролировать, какая цифровая сущность формируется вокруг бренда, продукта или компании в информационной среде, из которой AI получает данные для ответа.
При этом влияние AI Visibility нельзя автоматически переводить в деньги или трафик.
В рамках этого эксперимента я сознательно не рассчитывал финансовый эффект: для этого нужна отдельная методика атрибуции переходов, лидов и продаж, связанных именно с AI-ответами.
Что это меняет в SEO
Этот эксперимент стал для меня практическим переходом от классического SEO к GEO.
SEO продолжает работать с:
страницами → запросами → контентом → ссылками → поисковой выдачей.
GEO добавляет работу с:
сущностями → фактами → источниками → связями → AI-интерпретацией → ответом пользователю.
Это не замена SEO.
Качественные страницы, техническая доступность, содержательный контент, репутация и проверяемость источников, а также поисковая видимость остаются фундаментом.
Но для AI Search появляется дополнительная задача — сделать так, чтобы эта информация могла быть правильно интерпретирована как единая сущность.
Ограничения эксперимента
У исследования есть ограничения.
Это эксперимент на одном профессиональном профиле с ограниченным набором запросов. Ответы генеративных систем меняются со временем и зависят от множества факторов.
Невозможно полностью отделить влияние публикаций, новых источников, индексации, языка запроса и других изменений.
Для более строгого исследования потребовались бы:
- несколько независимых Digital Entity;
- контрольная группа;
- фиксированная панель запросов;
- несколько языков и AI-систем;
- одинаковые временные интервалы;
- повторные измерения;
- единая методика оценки.
Поэтому этот материал — практический GEO-кейс и исследовательское наблюдение, а не доказательство универсального алгоритма продвижения в AI.
Что можно проверить у себя
Подобный эксперимент можно провести с любой публичной сущностью: специалистом, компанией, брендом или продуктом.
Минимальная контрольная таблица:
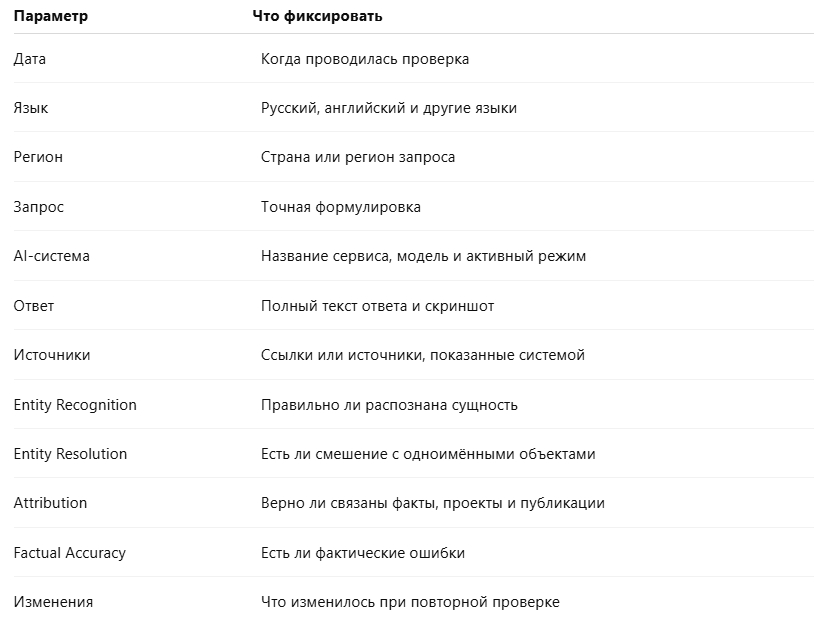
Важно фиксировать не только удачные ответы. В журнал нужно вносить ошибки, отсутствие упоминания, нерелевантные источники и смешение сущностей.
Иначе «до / после» легко превратить в подборку удобных примеров вместо полноценного наблюдения.
Итог
Эксперимент начался с простой проблемы: AI находил отдельные факты обо мне, но не всегда корректно связывал их в единый профессиональный профиль.
В рамках GEO-подхода я систематизировал публичный информационный корпус: унифицировал профессиональные данные, сформировал тематические связи и согласовал связи между внешними источниками.
В повторной серии проверок AI-ответы стали более последовательно связывать профиль с SEO, GEO, AI Visibility и AI Search. Это качественное наблюдение в рамках ограниченного эксперимента, а не доказательство того, что один конкретный фактор способен «продвинуть» сущность в AI.
Кейс показывает практическую сторону GEO: предметом работы может быть не только отдельная страница, но и связанное информационное представление специалиста, бренда, продукта или компании в генеративной среде.
Классическое SEO отвечает на вопрос:
«Как сделать страницу видимой для поисковой системы?»
GEO добавляет следующий вопрос:
«Какие публичные факты, источники и связи помогают AI корректно интерпретировать, кто вы, что вы предлагаете и чем это подтверждается?»
Для меня именно в этом заключается переход от SEO к GEO.