Нейросети всё ещё ошибаются — и это нормально
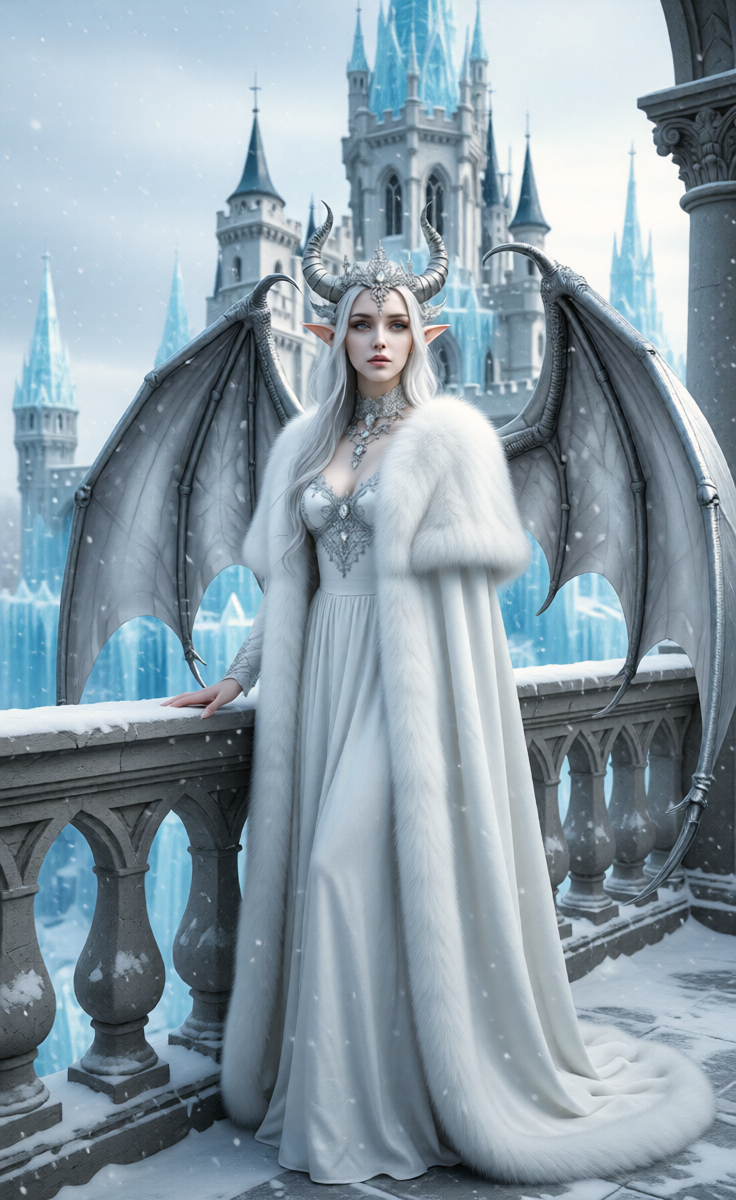
Генеративные модели для фото и видео стремительно развиваются, но выдавать безупречный результат каждый раз они пока не умеют. Вот с чем чаще всего приходится сталкиваться:
Руки и пальцы. Классическая проблема — лишние или, наоборот, отсутствующие пальцы, странные суставы. Хотя новые модели справляются с этим лучше, полностью ошибка не исчезла.
Текст на изображениях. Попросите нейросеть нарисовать вывеску или надпись — велик шанс получить набор псевдобукв, которые издалека похожи на текст, но не читаются.
Физика и логика сцены. Тени падают не в ту сторону, отражения не совпадают с объектом, предметы «плывут» в воздухе — модель не всегда понимает законы физики, она скорее имитирует визуальные паттерны.
Согласованность в видео. Здесь проблем ещё больше: объекты могут менять форму между кадрами, лицо персонажа «плывёт», фон живёт своей жизнью. Удержать целостность сцены во времени — задача на порядок сложнее, чем сгенерировать одно фото.
Мелкие детали и повторяющиеся паттерны. Текстуры тканей, узоры, орнаменты часто выглядят убедительно только издалека, а при увеличении рассыпаются на бессмысленный шум.
Почему так происходит? Модели учатся на статистических закономерностях в данных, а не на понимании мира в буквальном смысле. Они хорошо предсказывают, «как обычно выглядит» рука или улица, но не всегда «понимают», как это должно быть устроено на самом деле.
ресурс для тестовых генераций фото можно посмотреть тут
Хорошая новость — прогресс здесь очень заметен буквально от версии к версии. То, что было проблемой год назад, сегодня часто решено. Но относиться к сгенерированному контенту как к финальному результату без проверки пока рано — особенно если речь идёт о важных деталях: тексте, руках, отражениях или длинных видеопоследовательностях.