LLM-Студия в SYNTX: обновили работу с лимитами, добавили Grok 4.6 и увеличили лимиты в 3 раза
Мы постоянно прислушиваемся к пользователям и делаем SYNTX.AI удобнее — а на этот раз обновление получилось особенно крупным. Мы переработали всю систему лимитов в LLM-Студии: у каждой нейросети появилась шкала расхода токенов, лимиты можно сбрасывать не дожидаясь конца периода, а сами лимиты выросли в 3 раза на всех тарифах — без повышения цены. Плюс добавили свежий флагман Grok 4.6 от xAI.
В этой статье разберём все изменения по порядку: что такое LLM-Студия, как работает новый фильтр расхода лимита, как экономить токены, что умеет Grok 4.6 и как получить максимум пользы от обновлённой Студии.
Содержание статьи:
- Что такое LLM-Студия SYNTX
- Новый фильтр «Расход лимита»
- Лимиты увеличены в 3 раза
- Больше безлимитных моделей
- Сброс лимитов за токены
- Добавлен Grok 4.6 — флагман xAI
- Старая система LLM отключена
- Как экономить токены: практические советы
- Где попробовать
- FAQ
Что такое LLM-Студия SYNTX
LLM-Студия — это раздел SYNTX, где собраны топовые языковые модели (LLM) в одном окне: GPT, Claude, Gemini, Grok и другие. Вместо того чтобы оформлять отдельные подписки на каждый сервис (нередко с VPN и зарубежными картами), вы работаете со всеми моделями из единого интерфейса и одним балансом.
Главное преимущество такого подхода — гибкость: под каждую задачу можно выбрать оптимальную модель. Для сложного анализа — самую мощную, для простого вопроса — экономичную. А обновление, о котором пойдёт речь, делает этот выбор ещё проще и выгоднее.
💣 Новый фильтр «Расход лимита»
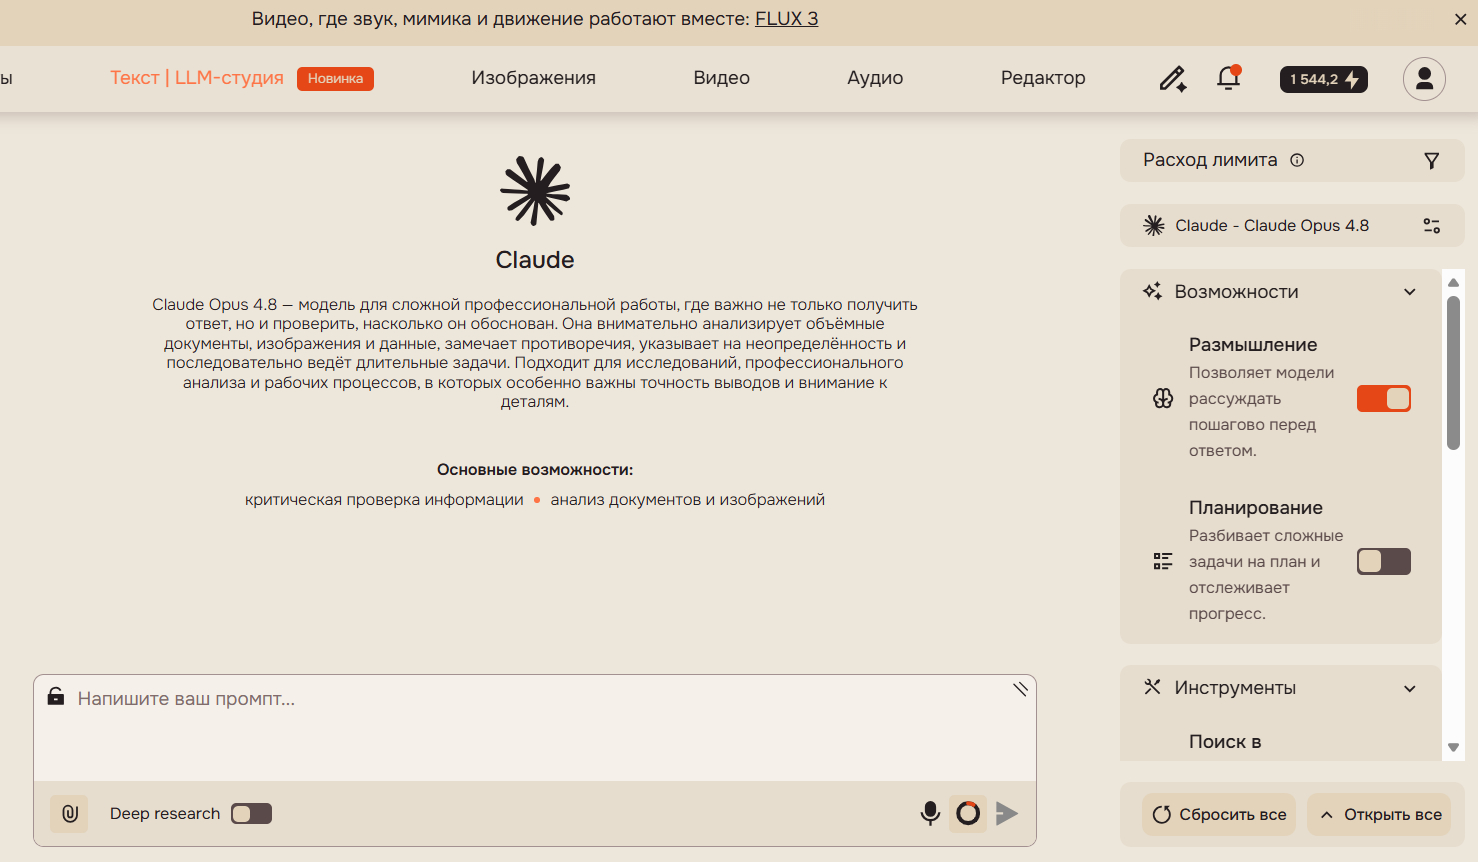
Главное нововведение — наглядная шкала расхода токенов у каждой модели. Теперь вы сразу видите, насколько «прожорлива» нейросеть, ещё до запуска задачи.
Как это работает:
- Рядом с каждой моделью появилась шкала из трёх делений. Чем больше делений закрашено — тем выше расход лимита у этой модели.
- Фильтр находится в правом верхнем углу — прямо над выбором нейросети.
- Теперь для простых задач можно осознанно выбирать только экономичные модели и не тратить лимит впустую.
Зачем это нужно? Раньше пользователь мог по привычке гонять тяжёлую флагманскую модель даже для элементарных вопросов — и быстро упирался в лимит. Теперь всё прозрачно: видишь расход — управляешь бюджетом токенов осознанно.
⚙️ Лимиты увеличены в 3 раза
Одно из самых приятных изменений: лимиты выросли втрое на всех тарифах — без изменения стоимости. То есть за те же деньги вы получаете в три раза больше генераций.
Это касается абсолютно всех тарифов — от базового до старших. Если раньше лимита не хватало на активный рабочий день, теперь запас стал заметно комфортнее.
Больше безлимитных моделей
Помимо роста лимитов, мы расширили список безлимитных моделей. Начиная с тарифа Pro, на каждом уровне стало больше нейросетей, которые не расходуют лимит вообще — ими можно пользоваться без оглядки на счётчик.
Полный список безлимитных моделей для каждого тарифа доступен на сайте. Практический смысл прост: рутинные и частые задачи можно закрывать безлимитными моделями, сохраняя лимит на действительно тяжёлые запросы.
Сброс лимитов за токены
Раньше, исчерпав лимит, приходилось ждать начала следующего периода. Теперь этого делать не нужно: лимиты можно сбросить в любой момент за токены.
Это особенно ценно, когда работа в разгаре и останавливаться нельзя — например, вы в середине большого проекта или горящей задачи. Сбросили лимит — и продолжаете без пауз.
▪️ Добавлен Grok 4.6 — свежий флагман xAI
В LLM-Студию добавлена одна из самых актуальных моделей на рынке — Grok 4.6 от xAI (компании Илона Маска). Это свежий флагман, вышедший в августе 2026 года, и он заточен под длительные, многошаговые задачи.
Чем интересен Grok 4.6:
- Не теряет нить в сложных сценариях. Модель рассчитана на «долгую жизнь внутри проекта»: держит контекст на протяжении большой задачи и не сбивается на многошаговых цепочках.
- Перепроверяет себя по ходу работы. Это снижает количество ошибок в объёмных задачах — модель критически оценивает промежуточные шаги.
- Огромное контекстное окно — около 500 000 токенов. Grok 4.6 «удерживает в голове» очень большие объёмы: длинные документы, кодовые базы, обширную переписку.
- Уровень топовых флагманов. По независимым бенчмаркам Grok 4.6 не уступает лидерам рынка, вернув xAI на передовую линию.
Проще говоря, если у вас объёмная задача с множеством шагов — большой анализ, работа с длинным документом, сложный код, многоэтапное рассуждение — Grok 4.6 отличный выбор.
Старая система LLM отключена
Переход на новую систему полностью завершён. Старая версия LLM отключена — теперь доступна только обновлённая LLM-Студия со всеми описанными улучшениями: шкалой расхода, увеличенными лимитами, безлимитными моделями и сбросом лимитов.
Это упрощает работу: единый современный интерфейс без «зоопарка» старых и новых версий.
Как экономить токены: практические советы
Раз уж появился наглядный контроль расхода, поделимся приёмами, которые помогают расходовать лимит рационально:
- Подбирайте модель под задачу. Простой вопрос, короткий текст, быстрый ответ — берите экономичную модель (одно деление на шкале). Сложный анализ или код — флагман.
- Используйте безлимитные модели для рутины. Черновики, переписывание, простые ответы — всё это можно делать без расхода лимита.
- Формулируйте запрос чётко. Понятный промпт снижает число повторных генераций, а значит — экономит токены.
- Дробите большие задачи только там, где нужно. Для длинных многошаговых сценариев логично взять модель с большим контекстом (например, Grok 4.6), чтобы не «пересобирать» контекст заново.
- Сбрасывайте лимит осознанно. Если работа горит — сброс за токены выручит, но для регулярной экономии лучше сочетать экономичные и безлимитные модели.
Где попробовать обновлённую LLM-Студию
Оценить все изменения проще всего на практике:
- На сайте — раздел «Текст» → LLM-Студия: полный интерфейс с фильтром расхода, выбором моделей и всеми настройками.
- В телеграм-боте — если удобнее работать прямо в мессенджере.
Новым пользователям начисляется 5.50 токенов на бесплатные генерации — этого хватит, чтобы попробовать разные модели (включая Grok 4.6) и оценить, как работает новая система лимитов. Всё без VPN, с оплатой российскими картами.
Если вы уже пользуетесь другим агрегатором — это хороший повод сравнить удобство: наглядный контроль расхода, увеличенные лимиты и сброс без ожидания периода делают ежедневную работу заметно комфортнее.
Как разобраться в моделях глубже
Чтобы выжимать максимум из LLM-Студии и грамотно выбирать модели под задачи:
- Академия SYNTX — системные материалы: какая модель для чего подходит, как писать эффективные промпты, как экономить токены.
- YouTube-канал SYNTX — дважды в неделю разбираем сложные темы и показываем путь от идеи до результата.
- Блог SYNTX Family в Телеграме — каждый день короткие посты с фишками и примерами применения нейросетей. Удобно учиться между делом.
Лучший способ прочувствовать обновление — просто зайти и попробовать: откройте LLM-Студию на сайте или в телеграм-боте и протестируйте новый фильтр расхода на своих задачах.
Часто задаваемые вопросы (FAQ)
Что изменилось в LLM-Студии SYNTX?
Появился фильтр «Расход лимита» со шкалой у каждой модели, лимиты увеличены в 3 раза на всех тарифах без роста цены, стало больше безлимитных моделей, добавлен сброс лимитов за токены и новый флагман Grok 4.6. Старая система LLM отключена.
Как работает фильтр «Расход лимита»?
У каждой модели есть шкала из трёх делений: чем больше закрашено, тем выше расход. Фильтр — в правом верхнем углу над выбором нейросети. Это помогает выбирать экономичные модели для простых задач.
Лимиты правда увеличили в 3 раза бесплатно?
Да, лимиты выросли втрое на всех тарифах без изменения стоимости.
Что за безлимитные модели?
Начиная с тарифа Pro, на каждом уровне есть модели, которые не расходуют лимит. Полный список — на сайте.
Как сбросить лимит LLM?
Теперь не нужно ждать нового периода — лимит можно сбросить в любой момент за токены и сразу продолжить работу.
Что умеет Grok 4.6?
Это свежий флагман xAI, заточенный под длительные многошаговые задачи: держит контекст (около 500 000 токенов), не теряет нить в сложных сценариях и перепроверяет себя по ходу работы. Отлично подходит для больших документов, кода и объёмного анализа.
Можно ли попробовать бесплатно?
Да, новым пользователям начисляется 5.50 токенов на бесплатные генерации. Без VPN, оплата картами РФ.
Нужно ли что-то переносить из старой системы LLM?
Нет. Переход завершён полностью, теперь доступна только новая LLM-Студия — просто заходите и работайте.
Обновлённая LLM-Студия стала удобнее сразу по нескольким направлениям: наглядный контроль расхода токенов, втрое больше лимитов, расширенный список безлимитных моделей, мгновенный сброс лимитов и мощный Grok 4.6 для сложных задач. Всё это — чтобы вы тратили меньше времени на управление лимитами и больше — на результат.
Заходите и потестите сами.