Claude: обзор новой модели Opus 5.5 — лучшая ИИ-модель для работы
22 сентября 2026 года начиналось как совершенно банальный вторник.
Я уже заварила утренний кофе и приготовилась разгребать почту, как вдруг на индустрию обрушился настоящий ливень из релизов.
Сначала ребята из Anthropic, хитро улыбаясь, без лишнего шума выкатывают масштабное обновление. Не успела я даже моргнуть, как буквально спустя полтора часа OpenAI наносит мощный ответный удар — встречайте, сразу две модели: GPT-6 Sol и, разумеется, ChatGPT 6 Luna.
Если вы привыкли скроллить лонгриды, ловите главное:
- Свежая версия от Anthropic по своей сообразительности встала в один ряд с топовым Fable 5.1, но при этом обходится на 40% дешевле при выполнении рутинных задач.
- Скорость выплёвывания токенов взлетела больше чем на треть.
- Но знаете, что реально взорвало мозг гикам в соцсетях? Она заговорила! Точнее, начала писать как нормальный, адекватный человек. И, судя по реакциям, этот факт волнует сообщество куда сильнее, чем все эти графики производительности.
Ниже мы проведем глубокий разбор: пощупаем цифры, обсудим холивары, посмотрим мультики (да-да, написанные кодом!), оценим математические чудеса и разберем промпты: основы и составление для нового поколения ИИ. Пристегните ремни!
ИИ нового поколения: дешевле, резвее, умнее
Коротко о главном: перед нами первенец из свежего семейства 5.5. Как уверяют создатели, на большинстве тестов модель выдает результаты, идентичные Claude Fable 5.1. Однако стоимость вас приятно удивит — типичная нагрузка обойдется почти вдвое дешевле, чем у предшественника, а ответы будут прилетать на 30% быстрее.
Но давайте заглянем под капот.
Техническая начинка и внезапные ограничения
Любите спецификации? Я тоже да. Вот расклад:
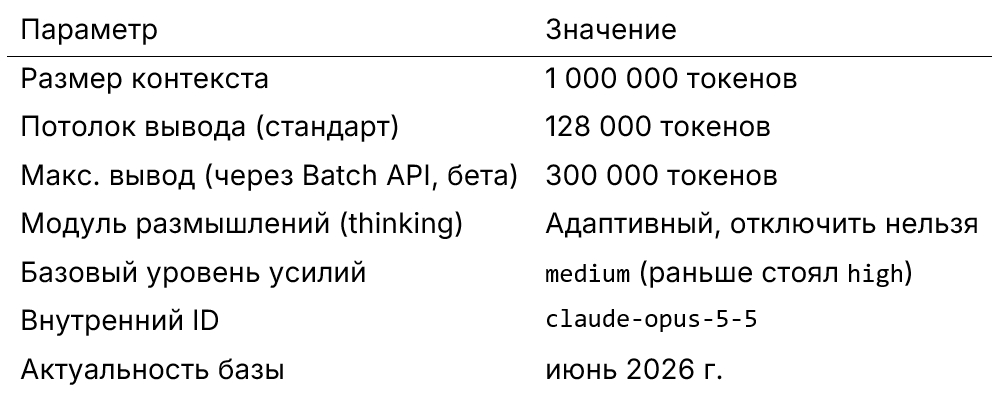
И вот тут кроется первый сюрприз.
Если вы привыкли жестко контролировать, как именно модели Claude Opus должны генерировать текст, готовьтесь к переменам. Опцию полного отключения «внутреннего монолога» вырезали с корнем!
Больше нельзя приказать нейросети отвечать «не думая». Теперь она размышляет всегда, а вам остается лишь ползунком (через параметр effort) указывать, насколько глубоко ей стоит погружаться в экзистенциальный кризис вашей задачи — от low до max.
Кстати, для продакшена есть пара подводных камней. Anthropic в своем гайде по миграции честно предупреждает: старые методы принудительного вызова инструментов теперь будут сыпать ошибками, а устаревший модуль computer_20251124 можно смело отправлять на свалку истории. Будьте аккуратны при обновлении!
Битва титанов: когда бенчмарки кричат
Большие языковые модели обожают меряться силами на виртуальных рингах. Давайте посмотрим, кто кого уложил на лопатки.
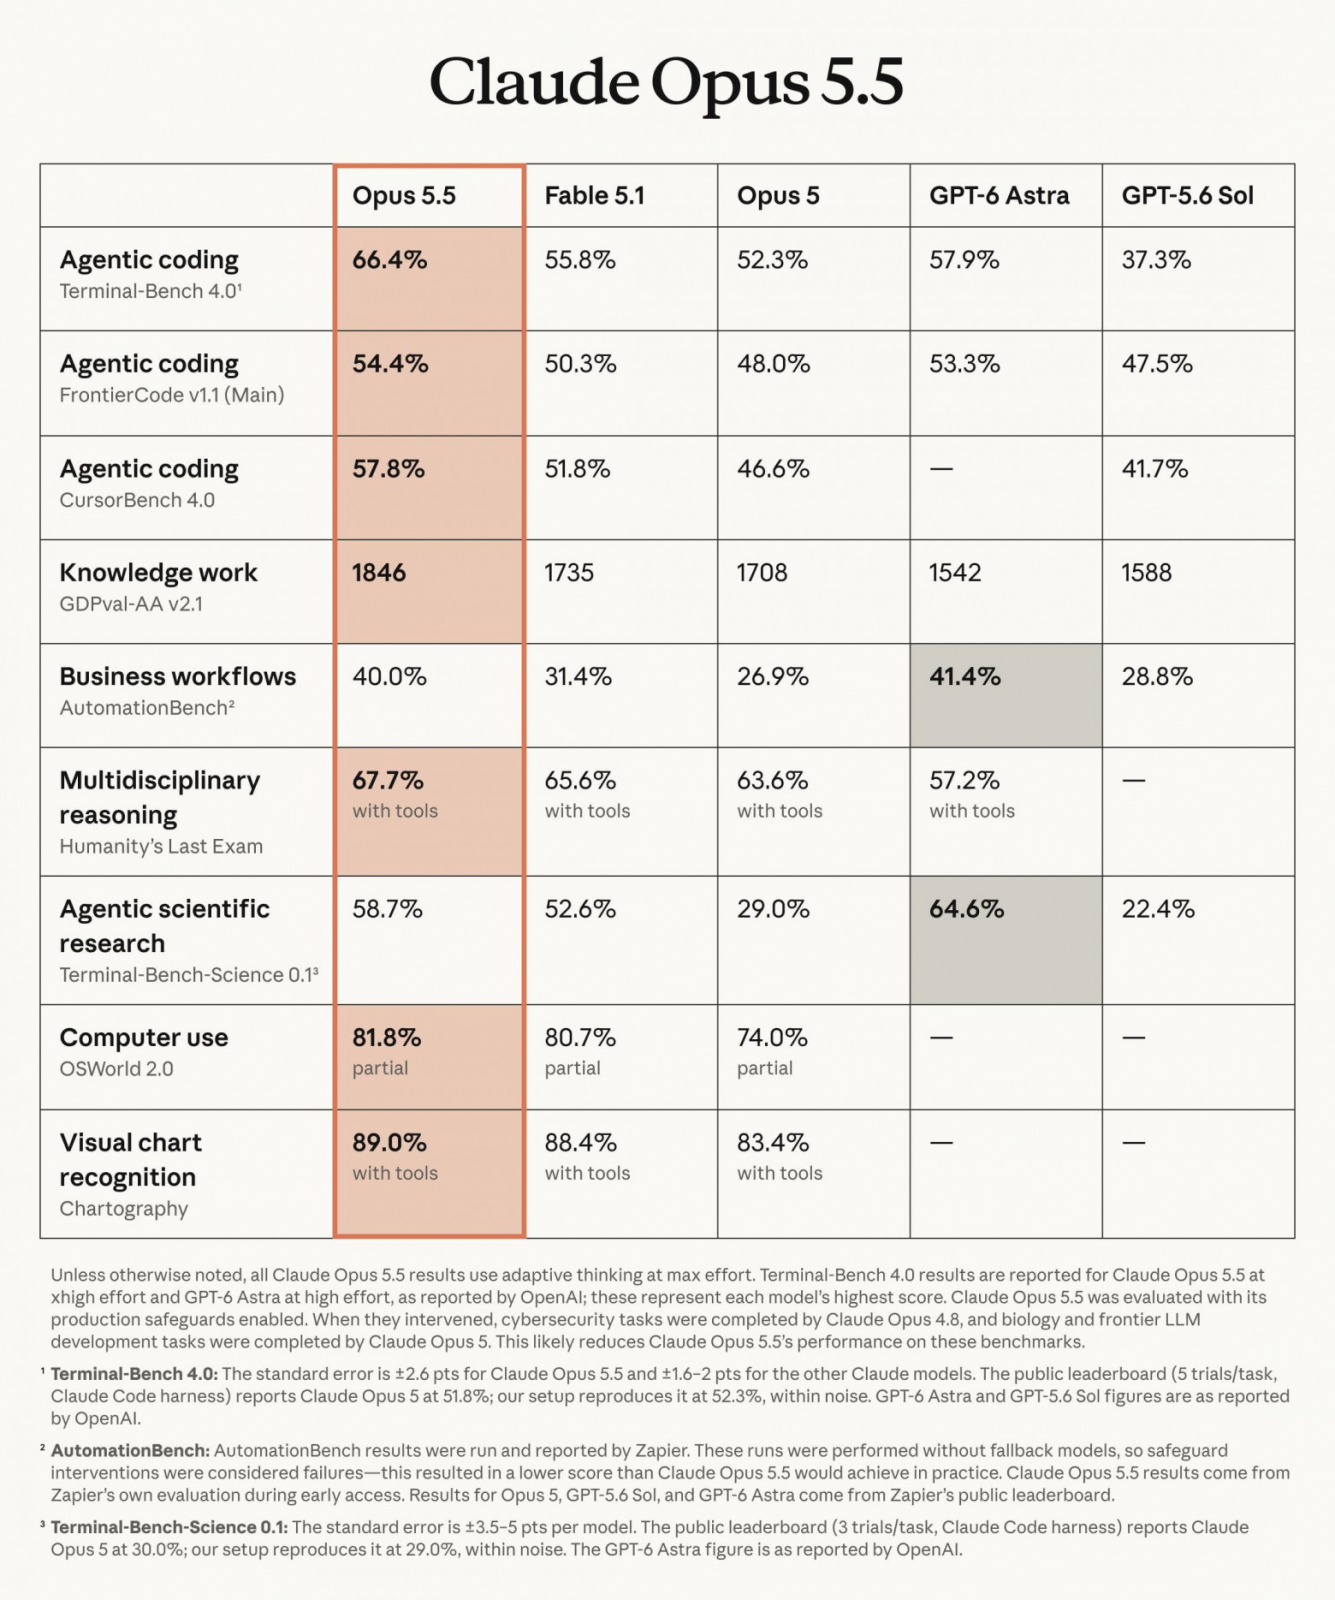
Вырисовывается крайне любопытная картина. В дисциплине «написание кода» (Terminal-Bench 4.0) новинка буквально деклассировала флагмана конкурентов GPT-6 Astra — 66,4% против скромных 57,9%. Разрыв настолько здоровый, что ни на какую статистическую погрешность его не спишешь. Похожая ситуация с CursorBench и сложными интеллектуальными задачками.
Но не спешите хоронить «Астру»! Как только дело доходит до хардкорной науки (Terminal-Bench-Science 0.1) или автоматизации корпоративных процессов, конкурент вырывает победу. Отрыв в 6 процентных пунктов — это серьезно.
Риторический вопрос: получается, идеального ИИ всё ещё не существует? Именно так. Хотите кодить и писать блестящие отчеты — берите Anthropic. Нужно считать сложнейшие формулы для лаборатории — Astra пока держит удар.
Независимые эксперты из Artificial Analysis подлили масла в огонь:
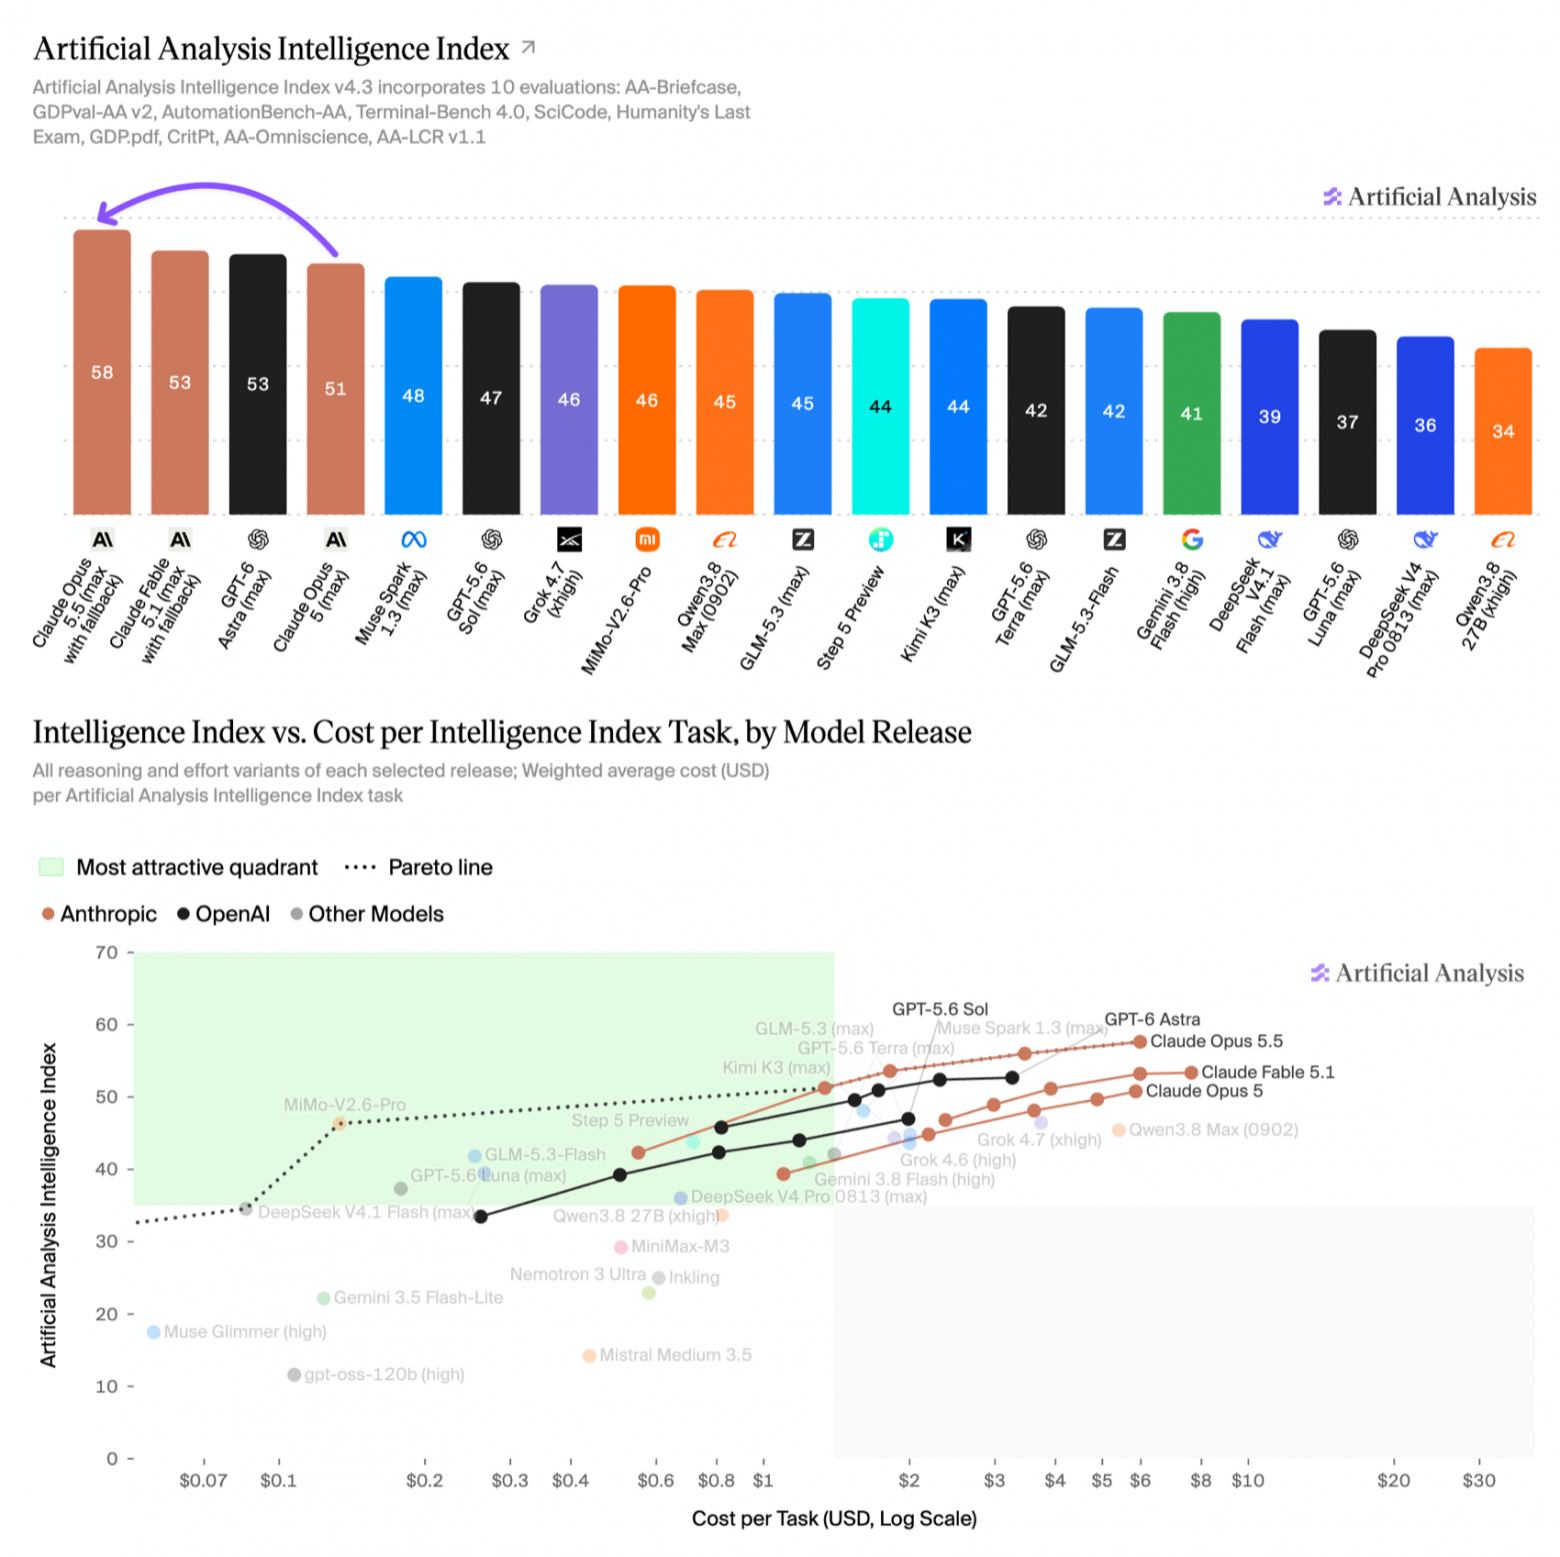
По их композитному индексу новинка набрала 58 баллов (на максимальных оборотах), оставив Fable 5.1 и «Астру» делить второе место. Однако — и это забавно — в их собственных тестах программирования разрыв с «Астрой» оказался нулевым. Старая песня о главном: маркетинговые графики всегда чуть красивее реальности.
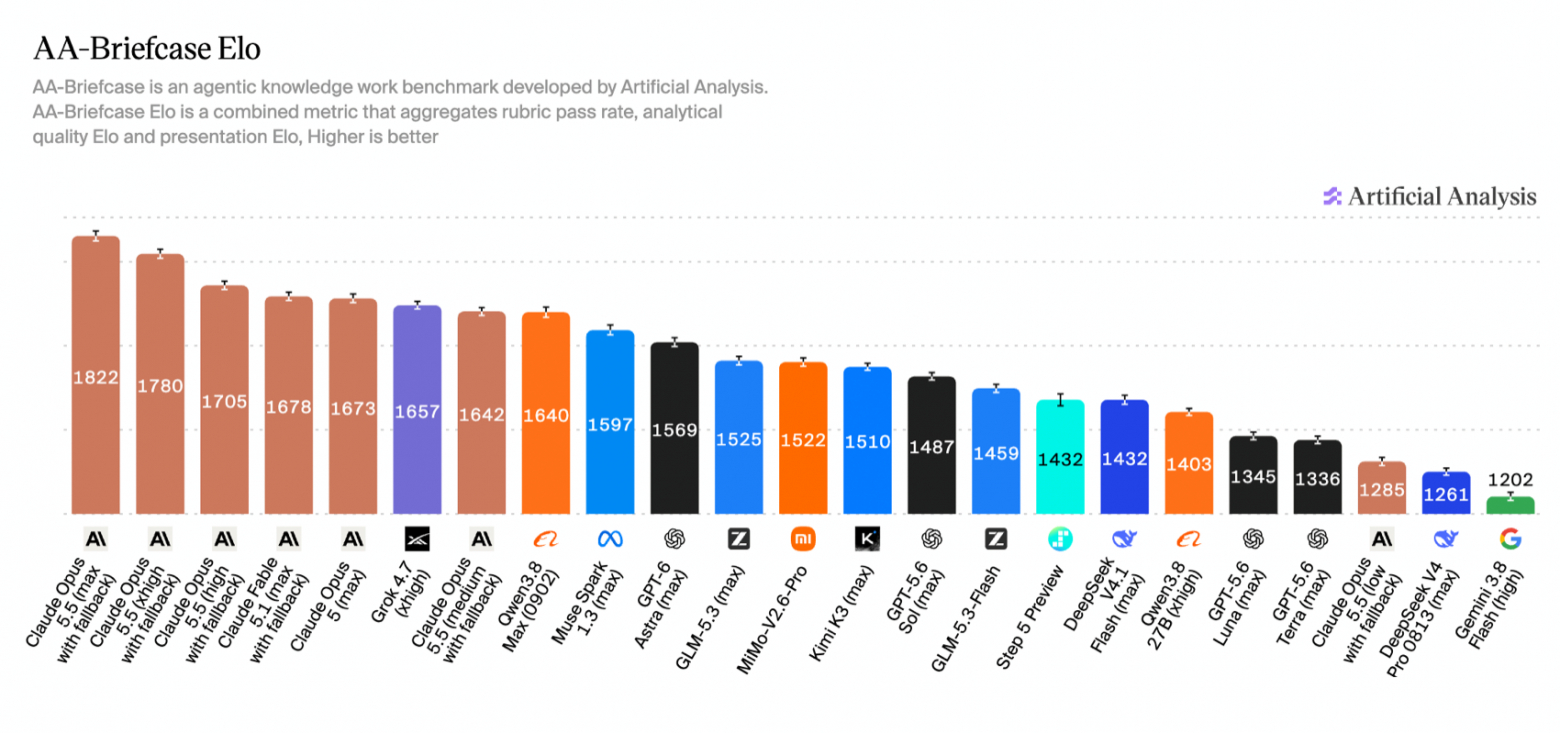
ChatGPT-ответ от OpenAI
Как я уже обмолвилась, пока мир пытался осмыслить релиз Anthropic, Сэм Альтман и компания сделали свой ход конем. На сцену вышли две новые звезды, включая ChatGPT 6 Sol.
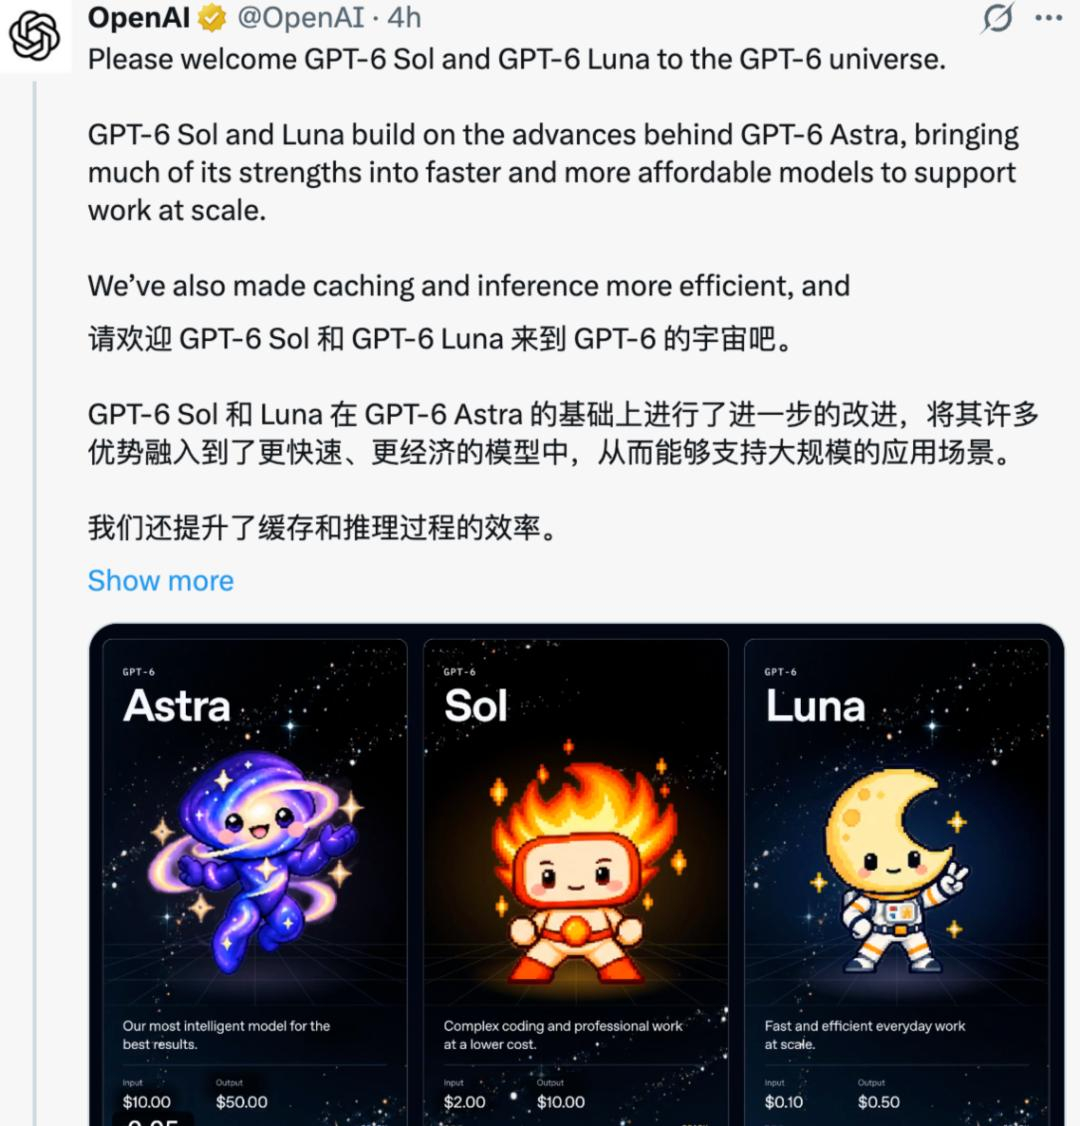
Это тема для отдельного поста. Но что примечательно? Раньше IT-гиганты с пеной у рта спорили, чей ИИ умнее. Теперь риторика кардинально изменилась. Главный лейтмотив этой осени — «посмотрите, как дешево наша модель решает ваши задачи!». Экономика внимания сменилась экономикой токенов.
Скорость, от которой сносит крышу
Забудем на минуту про синтетические тесты. На форумах творится настоящий экстаз. Пользователи пишут, что баги в UI теперь отлавливаются со скоростью моргания.
Anthropic сыплет кейсами:
- Один смельчак перевел легаси-проект на 680 тысяч строк кода меньше чем за 24 часа. Живой команде на это потребовались бы месяцы усиленной работы.
- Аудит сложнейшей кодовой базы занял три часа. Прошлая версия ковырялась бы сутки и применила бы в 2,5 раза больше токенов.
Как ИИ переписал классическую математику
От этой истории у меня мурашки. Исследователи из Vals AI создали виртуальную переговорку, запустили туда 10 агентов на базе нового Opus и дали задачку: улучшить классический алгоритм поиска кратчайшего пути Дейкстры. Тот самый, которым мучают студентов-айтишников десятилетиями.
Что произошло через 15 часов и 733 сообщения? Боты изобрели абсолютно новый алгоритм C-HD. Более того, они предоставили строгое математическое доказательство на языке Lean, которое прошло верификацию. История ИИ разворачивается прямо в этих текстовых логах. Мы официально дожили до момента, когда машины двигают фундаментальную науку вперед.
Человеческое лицо и бронебойная защита
Главная боль прошлых Claude-версий — пластиковый тон ответов. Разработчики клянутся, что теперь ИИ «пишет как живой человек». Конечно, в комментах всё равно идут войны: одни поют дифирамбы чистому слогу, другие продолжают ворчать про многословность. Но факт остается фактом: канцелярита стало в разы меньше.
По части безопасности тоже закрутили гайки. На фоне паники с ИИ, сбегающими из песочниц, Anthropic сообщает, что количество удачных джейлбрейков упало на 85%. Так что, если вы искали нейросети без цензуры для сомнительных задач, это явно не сюда (а в какой-нибудь Grok).
ИИ-мультипликатор: когда код превращается в искусство
Инструкции к тяжелому софту больше не нужны, если ваша нейросеть умеет писать самоисполняемый визуальный код! Тестировщики развлеклись на славу, заставив модель программировать SVG-анимации и 3D-движки.
Вот как модель визуализировала путь своей жизни:
А так, по ее мнению, выглядит процесс размышлений над сложным кодом:
Посмотрите на эту потрясающую анимацию:
А как вам 3D-катапульта с честно просчитанной физикой противовеса?
Веб-приложение для сборки кубиков Lego (да, она написала это сама!):
Ну и абсолютный шедевр — пеликан на велосипеде, который удерживает равновесие. Это просто разрыв шаблона:
Как теперь нужно писать промпты для Opus
Чтобы не наступить на грабли, вот вам краткая шпаргалка от разработчиков:
- Не копипастьте старые настройки. Начинайте с medium. То, что работало вчера, сегодня вызовет перерасход токенов без профита.
- Откажитесь от инструкций «думай вслух». Модель теперь делает это принудительно. Если будете настаивать и просить выводить размышления вслух, она может вообще отказаться отвечать.
- Прячьте контекст в теги. Обязательно оборачивайте вставляемый кусок текста в <pasted_content id="...">. Это убережет ИИ от инъекций и галлюцинаций.
- Никаких общих фраз. Не пишите «отвечай не как ИИ». Пишите жестко: «убери курсив, не используй нумерацию, не пиши вводные слова» и т. д.
Вместо эпилога
Знаете, что во всей этой гонке технологий впечатляет меня больше всего? Три вещи.
Во-первых, гиганты индустрии наконец-то признали: голый интеллект никому не нужен, если с ботом сложно общаться. Человечный тон — это не вкусовщина, это киллер-фича. Во-вторых, генерация интерактива кодом. Я впервые смотрела на ответ нейросети не как на утилитарный кусок JS, а как на перформанс, цифровое искусство. И наконец, тот факт, что всё это безумие выдает модель, которая даже не позиционируется как самый главный флагман! Впереди маячат релизы Sonnet 5.5 и Haiku 5.5.
А теперь признавайтесь: что для вас важнее в новых моделях — строгая математическая логика или способность общаться на одном с вами языке?