Написал текст – получил кино. Как нейросеть создаёт видео по текстовому описанию
Пишешь строчку текста – через минуту получаешь ролик со светом, движением камеры и звуком. Что происходит внутри между Enter и готовым видео?
Генерация видео по тексту (text-to-video) – это технология, при которой нейросеть получает словесное описание сцены и сама собирает из него ролик: кадры, движение, свет, а в новых моделях ещё и звук. Почти все современные генераторы работают на диффузии: модель начинает с цифрового шума и шаг за шагом «отмывает» его до осмысленной картинки, всё время сверяясь с вашим текстом.
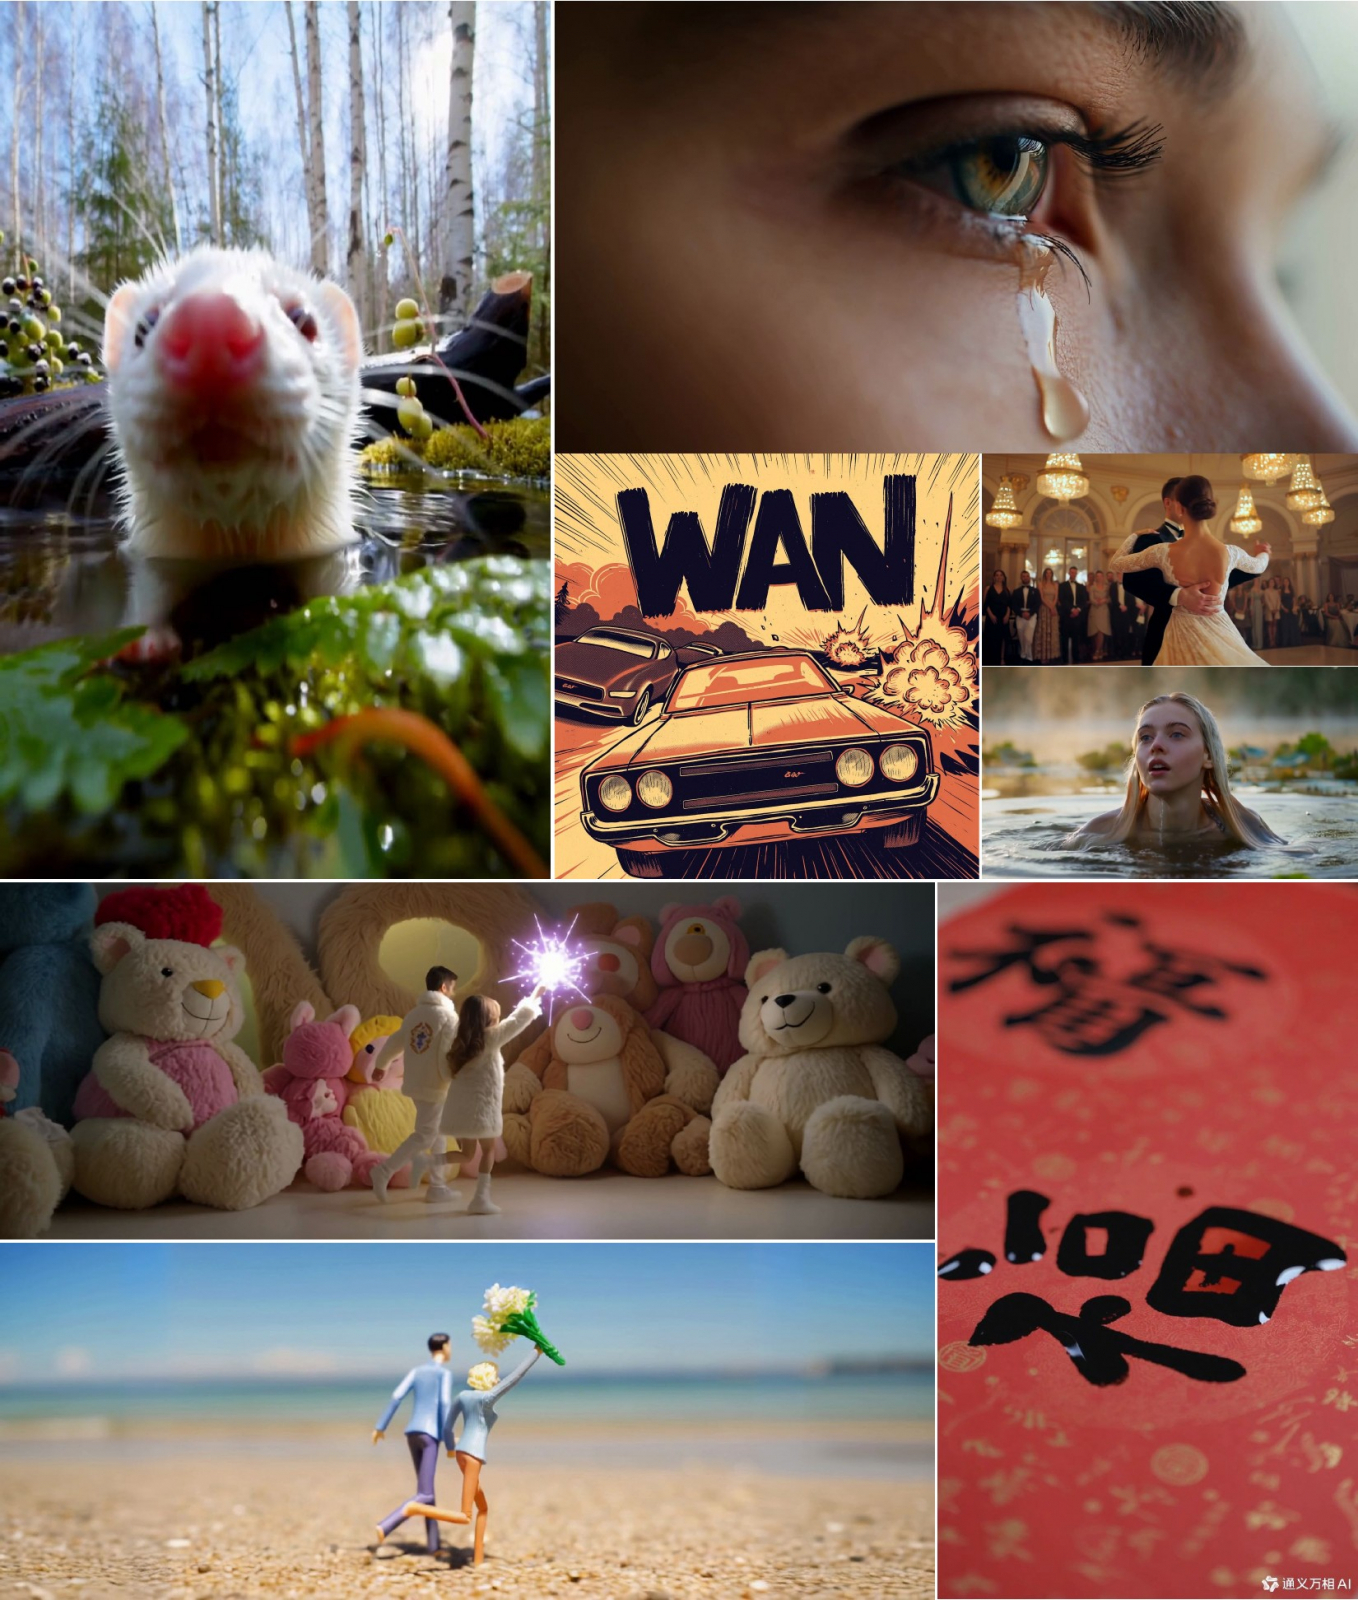
Звучит как волшебство, но внутри вполне понятная механика. Предлагаю разобрать её без формул.
Как попробовать самому за пять минут:
- заходим на GPTunnel.ru (или в @gptunnel_bot)
- в Creative Lab переключаемся на видео и выбираем модель
- вставляем промпт, выставляем формат и длительность
- жмём «Сгенерировать» и идём ставить чайник
Скульптор, который работает по шуму
Микеланджело приписывают фразу, что он просто убирает из мрамора всё лишнее. Диффузионная модель делает то же самое, только вместо мрамора у неё телевизионная рябь.
Учат её задом наперёд. Берут обычное видео и постепенно подмешивают к нему шум, пока от кота на подоконнике не останется серая каша. Модель смотрит на каждую стадию и тренируется угадывать, какой именно шум был добавлен. Миллионы примеров спустя она умеет обратное: получает чистый шум и по шагам вычищает из него сцену.
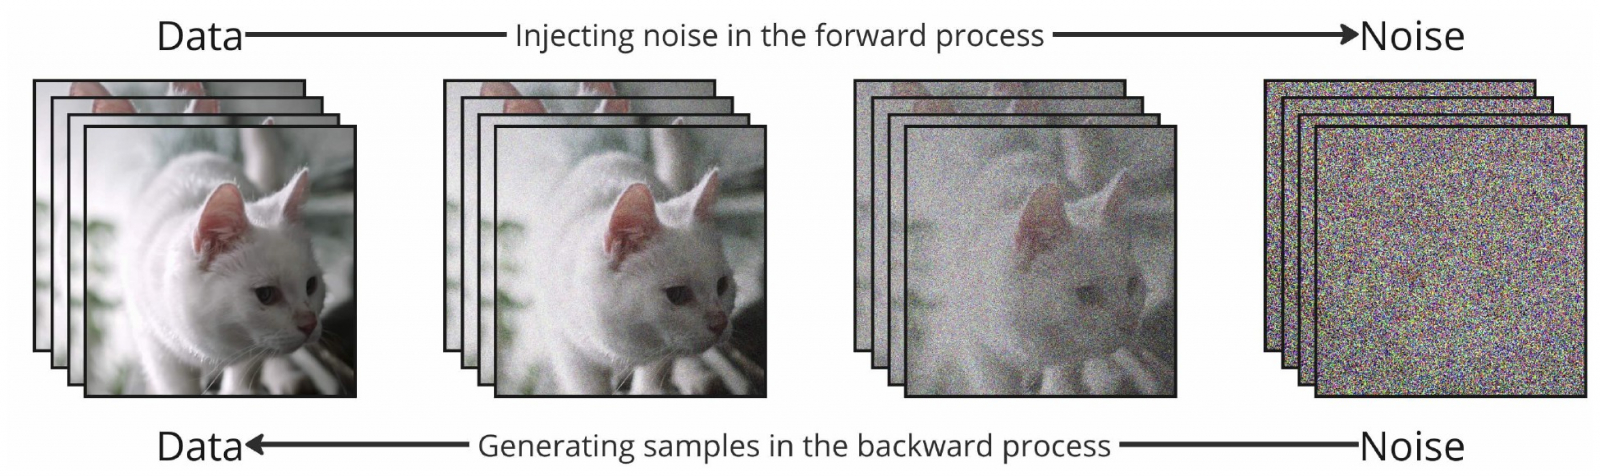
Где же тут ваш текст? Он работает как компас. Перед стартом описание прогоняют через языковой энкодер, и на каждом шаге очистки модель спрашивает себя: «Похоже ли то, что проступает из шума, на “кота, который запрыгивает на подоконник”?» Без текста из шума тоже вылезет что-то правдоподобное, просто непонятно что.
Видеонейросеть не ищет подходящий ролик в базе и не склеивает чужие кадры. Каждый пиксель в нём появляется из шума заново.
Почему видео – это не 24 картинки подряд
Первое, что приходит в голову: раз модели уже рисуют картинки, почему бы не нарисовать 24 штуки и не склеить?
Пробовали. Получается мультфильм в лихорадке: у кота на каждом кадре новые пятна, фон дышит, предметы прыгают. Каждая картинка хороша сама по себе, но между собой они не договорились.
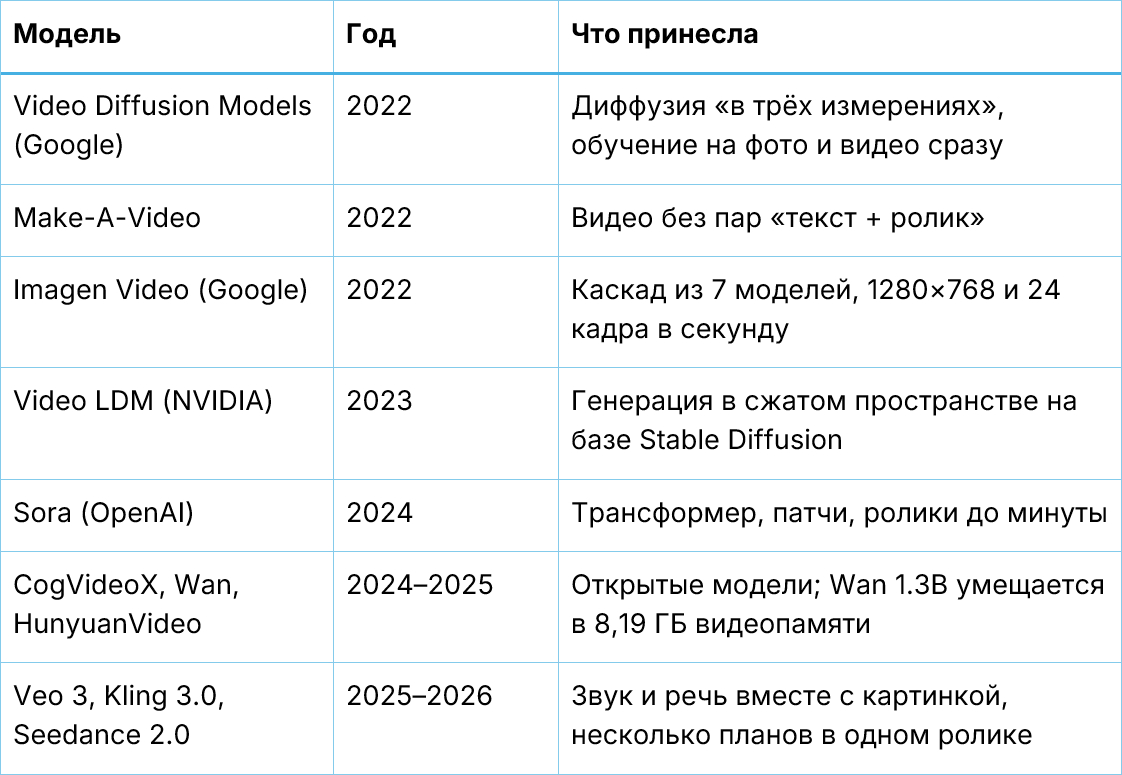
Поэтому видео генерируют целым блоком. В 2022 году команда Google в работе «Video diffusion models» расширила картиночную архитектуру на третье измерение – время. Модель видит сразу пачку кадров и следит, чтобы они были согласованы. Там же нашли полезный трюк: учить модель одновременно на видео и на обычных картинках. Фотографий в мире на порядки больше, чем подписанных роликов, и это сильно ускорило обучение.
Через полгода другая компания довела идею до изящной формулы. В экспериментальной модели Make-A-Video разделили обучение на две части:
Узнать, как мир выглядит и как его описывают, по парам “картинка + текст”, а как мир движется – по видео без всяких подписей.
То есть модели вообще не понадобились ролики с описаниями. Внешний вид она взяла у картиночного генератора, а движение подсмотрела в миллионах немых клипов.
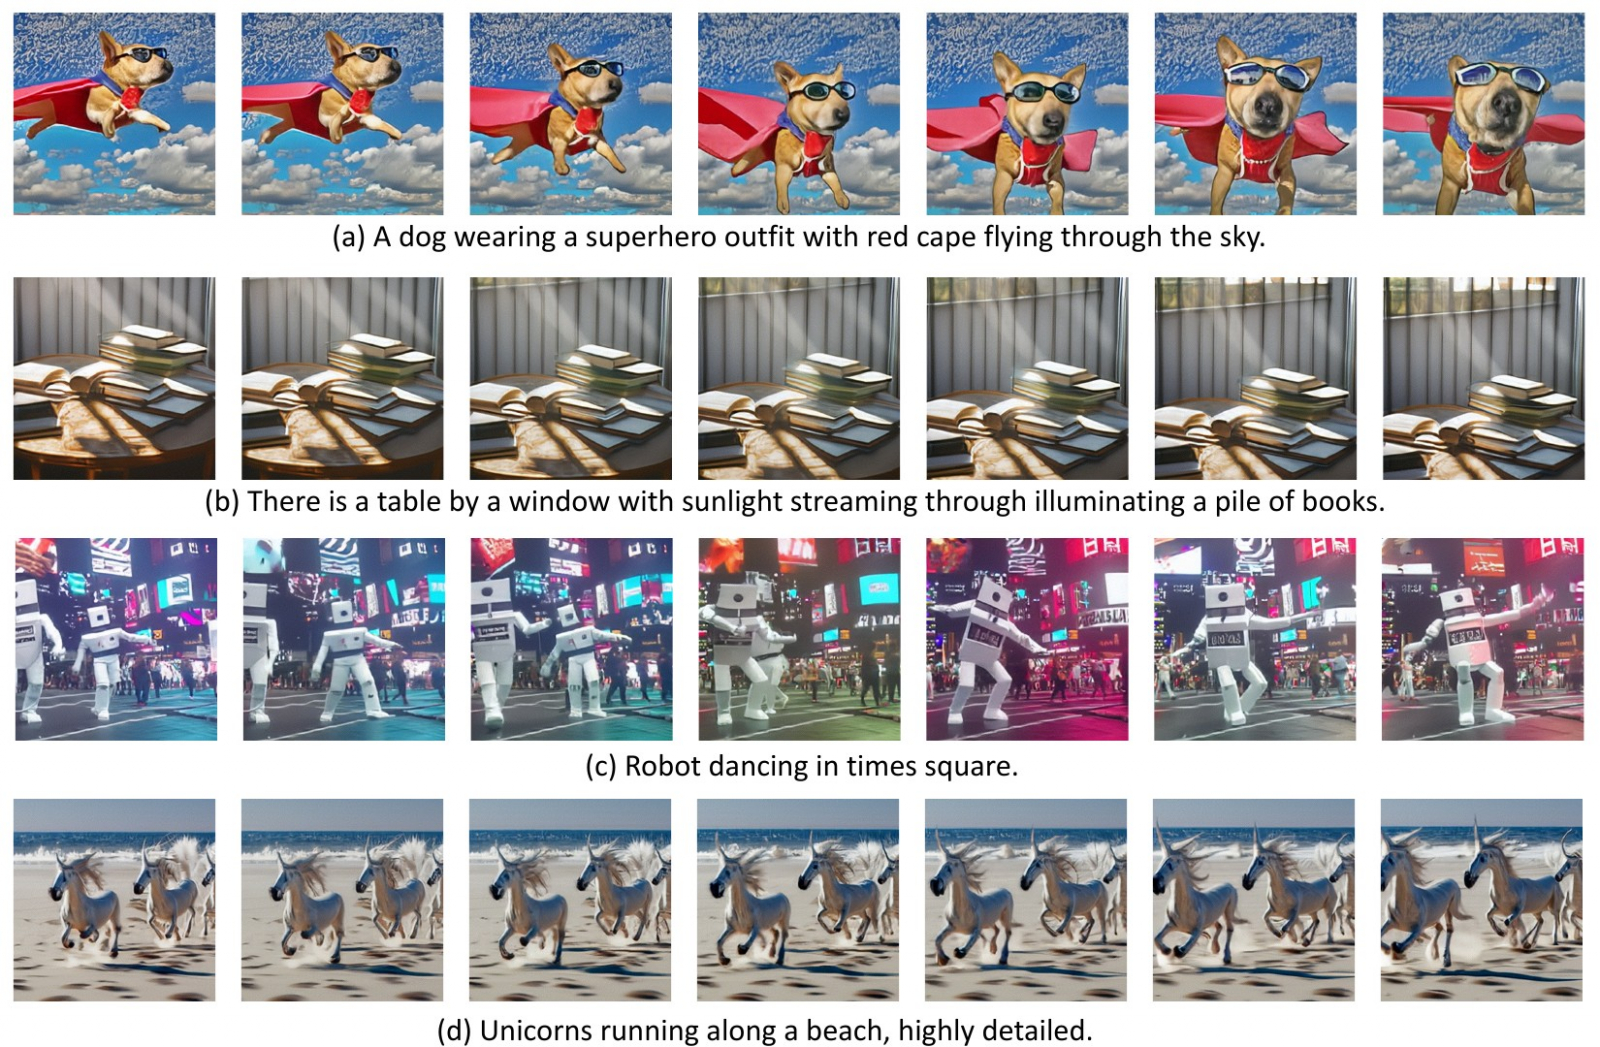
Дальше пошли совсем лайфхаки. Авторы модели Text2Video-Zero из Picsart вообще ничего не обучали: взяли готовую Stable Diffusion и заставили каждый кадр «подглядывать» в первый, чтобы герой не менял лицо. А VideoCrafter2 от Tencent нашёл выход из нехватки красивых видео: движение модель учила на дешёвых роликах низкого качества, а «картинку» доводила на качественных фото.
Конвейер на семь моделей и кадр размером с иконку
Отдельная головная боль – вычисления. Пять секунд видео в HD – это уже больше сотни миллионов пикселей, и чистить их от шума напрямую слишком дорого.
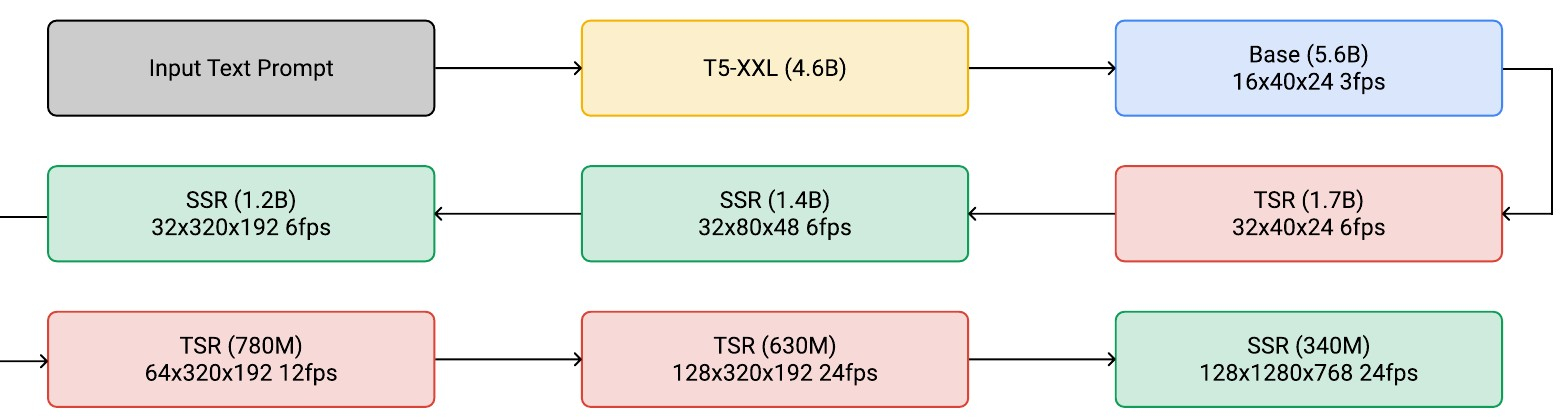
Imagen Video от Google решил задачу в духе сцены из «Бегущего по лезвию», где детектив командует компьютеру «увеличь!». Базовая модель генерировала крошечный ролик: 16 кадров размером 40 на 24 пикселя при 3 кадрах в секунду. Это меньше значка приложения на телефоне! Потом за дело брались ещё шесть моделей: одни дорисовывали промежуточные кадры, другие повышали разрешение. На выходе – 5,3 секунды в 1280×768 и 24 кадра в секунду. Всего семь диффузионных моделей и 11,6 млрд параметров.
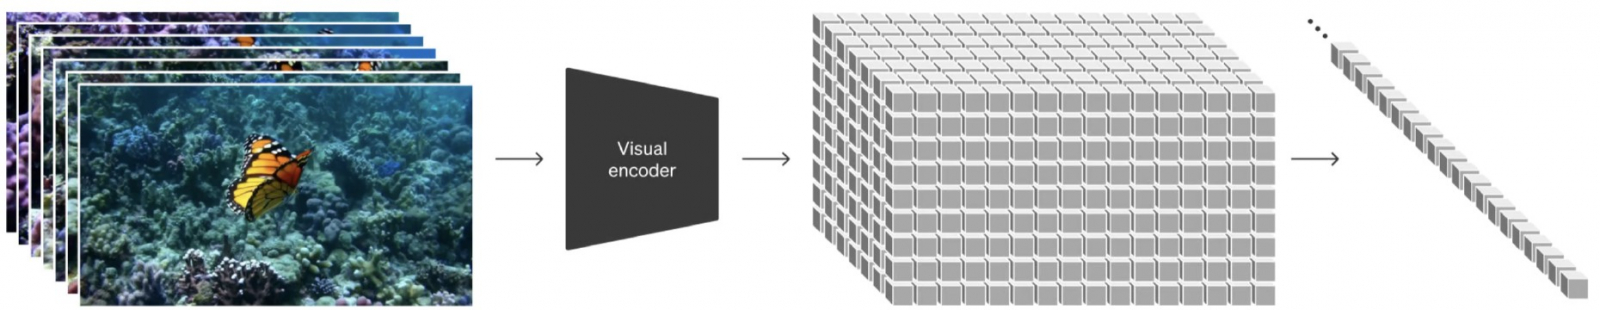
Но настоящий прорыв случился, когда видео научились сжимать. Сегодняшние модели сначала упаковывают ролик автоэнкодером в компактное «латентное» представление, работают с ним, а в конце распаковывают обратно. В Video LDM исследователи NVIDIA так превратили обычную Stable Diffusion в видеогенератор, дообучив только слои, которые отвечают за время.
OpenAI для Sora пошла дальше и нарезала сжатое видео на «кубики пространства-времени», почти как блоки в Minecraft. Эти патчи можно сравнить с токенами в языковых моделях. Для нейросети ролик превращается в длинную фразу из кусочков картинки и движения.
А читает эту «фразу» трансформер, та же архитектура, что у ChatGPT. Идею поставить его в диффузию вместо привычной свёрточной сети описали в 2022 году в работе «Diffusion transformers». Один из авторов, Уильям Пиблз, позже стал одним из руководителей Sora в OpenAI. С тех пор DiT стал стандартом: на нём построены CogVideoX, Wan, HunyuanVideo и Veo.
Вот как это выглядит у Google Veo:
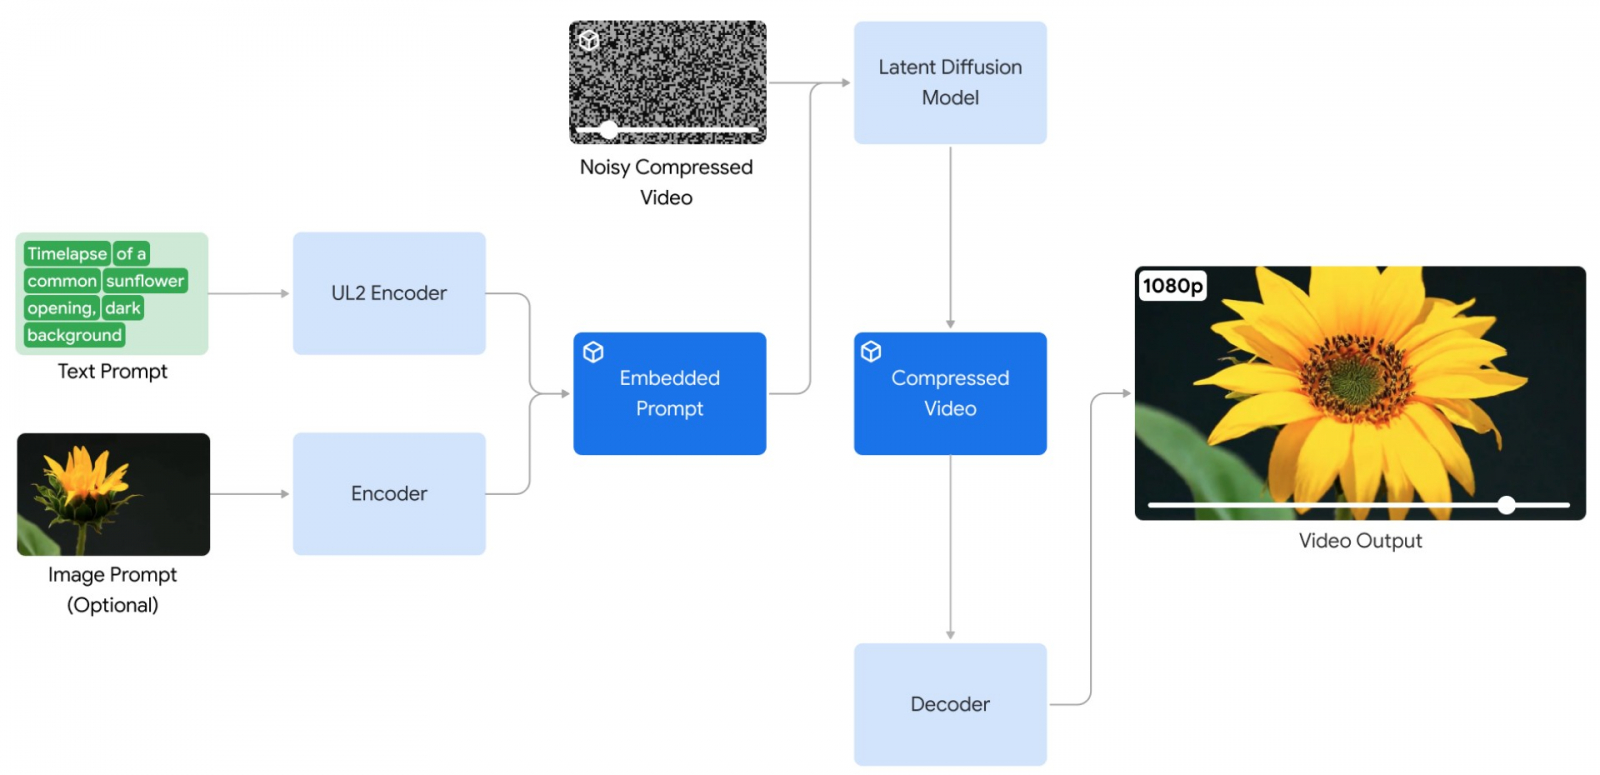
Промпт «таймлапс: раскрывается подсолнух, тёмный фон» уходит в языковой энкодер. Рядом лежит сжатое видео из чистого шума. Латентная диффузионная модель много раз чистит его, сверяясь с текстом, а декодер разворачивает результат в настоящие кадры. Можно добавить и картинку-референс – тогда модель будет держаться за её внешний вид.
Кто пишет подписи к миллионам роликов
Самая недооценённая часть истории – данные. Объёмы такие, что считать удобнее в годах:
- для Stable Video Diffusion собрали 580 млн клипов – это 212 лет непрерывного видео
- HunyuanVideo 1.5 начинала с 10 млн часов сырых записей, больше тысячи лет
- Wan обучали на миллиардах картинок и видео, порядка триллиона токенов
Из базы вычищают статичные кадры, монтажные склейки, ролики с логотипами и субтитрами. В CogVideoX после фильтров остались 35 млн коротких клипов примерно по 6 секунд.
Каждому ролику нужна подпись, и пишут их уже не люди, а другие нейросети. Google размечает данные для Veo несколькими моделями Gemini, причём с разной степенью детализации: от пары слов до развёрнутого описания со светом и ракурсом.
Отсюда главный практический вывод: модель привыкла к подробным описаниям. Чем ближе ваш промпт к такой «подписи», тем точнее результат.
Как написать промпт для видео, чтобы нейросеть поняла
Хорошая новость: чтобы создать видео с помощью нейросети, не нужно разбираться в диффузии. Достаточно помнить, что модель обучалась на подписях, и писать тем же способом, как этот делал составитель такой подписи.
- Кто в кадре. Конкретный герой с парой деталей: «рыжий кот с белой грудкой».
- Что делает. Современные модели, вроде SeeDance 2.5 и Kling 4.0, могут уместить даже несколько событий в нескольких секундах.
- Где. Место, время суток, погода.
- Как движется камера. «Медленный наезд», «камера на уровне глаз», «съёмка с рук».
- Свет и звук. «Яркий закатный свет», «слышно дождь по стеклу».
Какие модели для генерации видео стоит знать осенью 2026-го:
Популярные модели text-to-video и их сильные стороны:
- Veo 3.1 (Google) – звук вместе с видео, до трёх картинок-референсов, первый и последний кадр
- Kling 3.0 (Kuaishou) – ролики до 15 секунд, речь на нескольких языках, сцены из нескольких планов
- Seedance 2.5 (ByteDance) – принимает текст, фото, аудио и видео как референсы, 4–15 секунд
- WAN 3.0 (Alibaba) – наследник открытой линейки Wan, хорошо держит надписи в кадре
- Grom TV (GPTunneL) – недорогая российская модель для быстрых черновиков и портретов
Частые вопросы о генерации видео по описанию
Когда-то видео по описанию было демо из научной статьи с размытой собакой в плаще. Теперь это рабочий инструмент: черновик рекламы, задник для поста, сторис без съёмочной группы. Механика внутри сложная, но пользоваться ей просто, ведь всё, что требуется, это внятно описать сцену. С этим, согласитесь, справится каждый.