Sonnet 5.5 или Opus 5.5: какую модель Claude взять для бизнес-задач
Sonnet 5.5 вышла 28 сентября 2026 года. Anthropic в анонсе ставит её вплотную к Opus 5.5 на офисных тестах, а за токен берёт вдвое меньше. Независимые замеры Artificial Analysis уточняют, что близко к Opus 5.5 она подходит на уровне усилия max. На medium, который стоит по умолчанию в Claude Code, Sonnet 5.5 слабее: 41 пункт общего индекса против 51. Поэтому для важной работы на умолчаниях разумнее Opus 5.5, а Sonnet 5.5 подходит для дешёвой рутины. Цифры даны на 6 октября 2026 года.
Что такое Sonnet 5.5 и чем она отличается от Opus 5.5
Anthropic называет Sonnet 5.5 более быстрым и дешёвым дополнением к Opus 5.5. Opus 5.5, по описанию компании, создан для сложной работы, где нужно взвешенное суждение, а Sonnet 5.5 сильнее всего в чётко поставленных повседневных задачах, исправлении ошибок и подготовке документов, презентаций и таблиц.
По сравнению с прежней Sonnet 5 новая модель отвечает более чем на 30% быстрее и, по словам компании, обходится до 30% дешевле на задачу. У Sonnet 5.5 и Opus 5.5 один набор уровней усилия, то есть глубины рассуждений перед ответом: low, medium, high, xhigh и max. В Claude Code и приложениях по умолчанию стоит medium, на Claude Platform high.
Сколько стоит новая модель в API
В API за миллион токенов Sonnet 5.5 стоит $2 на входе и $10 на выходе. По странице цен Anthropic, у Opus 5.5 цены $4 и $20.
Что показывает таблица Anthropic
В таблице анонса Sonnet 5.5 идёт вплотную к Opus 5.5 на офисных задачах, управлении компьютером и работе в терминале:
- GDPval-AA v2.1, задания вроде документов, слайдов и таблиц: 1844 у Sonnet 5.5 и 1846 у Opus 5.5.
- AA-Briefcase v1.1: 1811 против 1822.
- OSWorld 2.1, управление компьютером: 80,1% против 81,8%.
- Terminal-Bench 4.0, работа в терминале: 70,6% против 66,4%. Для Opus 5.5 в сноске указан уровень xhigh.
В разработке Opus впереди. В FrontierCode 1.1 у Sonnet 5.5 46,2% на max против 54,4% у Opus 5.5. Anthropic оговаривает, что на max Sonnet 5.5 набирает меньше, чем на xhigh: чаще запускала проверку кода субагентами, и в двух разобранных случаях это привело к таймауту или лишним правкам. В Humanity's Last Exam, наборе трудных вопросов, с инструментами у неё 64,5% против 67,7%. Anthropic пишет, что на сложной открытой работе, где нужно долго держать суждение, Opus 5.5 остаётся сильнее.
В сноске к таблице сказано, что оценки GDPval-AA и AA-Briefcase получены на предрелизной версии с ошибкой в структурированных ответах. Anthropic ожидает, что эффект небольшой и скорее занижает результат Sonnet 5.5, и ошибку с тех пор исправили. Уровень усилия для остальных ячеек в таблице не назван.
Что показывают замеры Artificial Analysis на разных уровнях усилия
Artificial Analysis прогоняет модели через один набор тестов отдельно на каждом уровне усилия, а «задачей индекса» называет одну задачу из этого набора. На max Sonnet 5.5 набирает 56 пунктов общего индекса, на 2 меньше Opus 5.5, а в GDPval-AA у неё 1839 против 1866 (в таблице Anthropic 1844 против 1846, там предрелизная версия). На medium разрыв больше. По страницам Artificial Analysis общий индекс Sonnet 5.5 на medium равен 41, у Opus 5.5 на medium 51.
Opus 5.5 на medium по индексу сравним с Sonnet 5.5 на xhigh: 51 против 52 пунктов. Задача индекса при этом обходится Opus 5.5 в $1,34, а Sonnet 5.5 на xhigh в $2,75. Sonnet 5.5 на medium дешевле, $0,59 за задачу, но и слабее.
В статье Artificial Analysis от 28 сентября сказано, что на max Sonnet 5.5 тратит около 193 тысяч выходных токенов на задачу индекса. Это примерно на 60% больше, чем у Opus 5.5 на том же уровне, и самый высокий расход среди замеренных моделей. На страницах моделей на max задача индекса обходится Sonnet 5.5 в $7,67, а Opus 5.5 в $5,98, хотя токен у Sonnet 5.5 вдвое дешевле. Sonnet 5.5 на max к тому же на 51% дороже Sonnet 5 на том же уровне. Anthropic пишет об экономии до 30% на задачу, но уровень усилия для этой цифры не называет.
В тесте фактических знаний AA-Omniscience на max Sonnet 5.5 даёт 54% верных ответов, Opus 5.5 66%. По отдельной метрике Artificial Analysis доля выдуманных ответов у Sonnet 5.5 ниже: 47% против 59% у Opus 5.5.
Как включить новую модель в Claude Code
На Pro, Max, Team, Enterprise и в API по документации Claude Code по умолчанию стоит Opus 5.5. Sonnet 5.5 включают сами:
- Выполнить claude update. Sonnet 5.5 требует Claude Code версии 2.1.284 или новее, Opus 5.5 версии 2.1.280.
- Для пробы запустить claude --model sonnet, выбор действует одну сессию. Команда /model sonnet сохраняет Sonnet 5.5 как модель по умолчанию, и тогда Opus придётся вернуть командой /model opus.
- Проверить уровень усилия командой /effort. Если вы раньше не задавали его сами, стоит medium.
Алиас sonnet ведёт на Sonnet 5.5 при входе через Anthropic API. На Amazon Bedrock и в Google Cloud он ведёт на Sonnet 4.5. Какие настройки менять при работе на Opus 5.5, описано в статье про Claude Code на Opus 5.5.
Что отдавать Sonnet, а что Opus
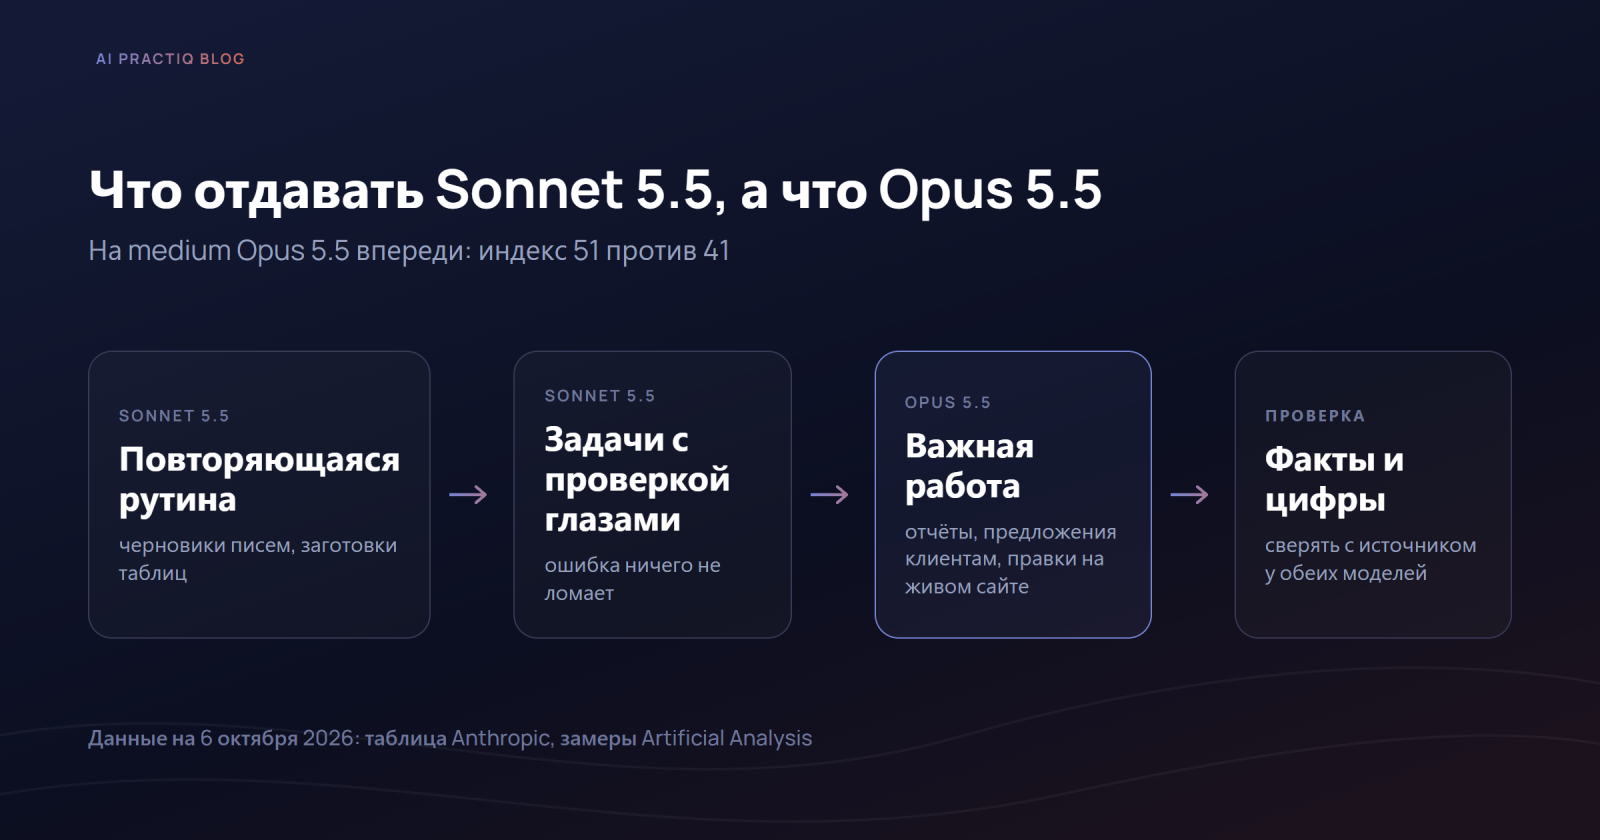
Для важной работы на умолчаниях, то есть на medium, лучше оставить Opus 5.5: отчёт для собрания, коммерческое предложение для клиента, правку на работающем сайте или в боте. Разрыв на этом уровне составляет 10 пунктов общего индекса.
Sonnet 5.5 на medium подходит для дешёвой рутины, где результат легко проверить глазами и ошибка ничего не ломает: черновики писем, первичная сортировка заявок, заготовки таблиц. Если нужен её максимум, уровень усилия поднимают, но по замерам Artificial Analysis уже на xhigh задача обходится дороже, чем у Opus 5.5 на medium при том же индексе.
Как сравнить две модели на своей задаче
Сравнить модели можно на одной своей задаче:
- Выбрать задачу, которая повторяется каждую неделю: отчёт, письмо клиентам, правку на сайте.
- Открыть новую сессию, запустить claude --model sonnet, оставить medium и выполнить задачу. Записать, сколько лимита ушло.
- Повторить с claude --model opus в новой сессии с теми же вводными.
- Показать оба результата коллеге, не говоря, какой от какой модели, и спросить, какой лучше.
- Если Sonnet справилась хуже, повторить её прогон на high и снова записать расход лимита.
Один прогон даёт шумный результат, поэтому лучше взять две-три задачи. Если выбор стоит между Opus 5.5 и более дорогой моделью Fable 5.1, он разобран в статье про Claude Opus и Fable.
Частые вопросы
Когда вышла Sonnet 5.5? 28 сентября 2026 года.
Сколько стоит Sonnet 5.5? В API $2 за миллион входных токенов и $10 за миллион выходных. У Opus 5.5 цены ровно вдвое выше.
Sonnet 5.5 или Opus 5.5: что лучше? В пяти из шести названных тестов анонса Sonnet 5.5 слабее Opus 5.5 или идёт вровень, впереди она только в Terminal-Bench 4.0. На уровне medium независимые замеры показывают отставание Sonnet 5.5, на max она почти догоняет Opus 5.5, но задача обходится дороже.
Какой уровень усилия выбрать для Sonnet 5.5? Начинать с medium, он стоит по умолчанию в Claude Code и приложениях. Если результат слабее, чем у Opus 5.5, поднимать до high. На max модель по замеру Artificial Analysis тратит больше токенов, чем любая из замеренных.
Как включить Sonnet 5.5 в Claude Code? Обновить программу командой claude update и запустить claude --model sonnet. Нужна версия 2.1.284 или новее.
Какая модель в Claude Code стоит по умолчанию? Opus 5.5 на Pro, Max, Team, Enterprise и в API.
Заключение
Sonnet 5.5 вдвое дешевле Opus 5.5 за токен, но на умолчаниях Claude Code уступает Opus 5.5 по независимым замерам, а почти догоняет только на max, где задача обходится дороже. Для важной работы стоит оставить Opus 5.5, а Sonnet 5.5 пробовать на повторяющейся рутине и сверять с Opus на своих задачах. Разборы Claude Code клуб AI Practiq собирает на канале в Telegram.